


Adobe于周四推出Firefly图像生成AI模型系列最新版本,新增矢量图生成模型,并上线整合自身及竞品AI模型的网页应用。此外,Firefly移动端应用也在开发中。
🎨 Firefly Image Model 4:画质与控制力全面升级
全新Firefly Image Model 4在输出质量、生成速度,以及对结构、风格、相机角度和缩放的控制上均优于前代,支持最高2K分辨率。其强化版Image Model 4 Ultra可精准渲染包含微小结构与海量细节的复杂场景。
Adobe生成式AI副总裁Alexandru Costin表示,新模型通过更高算力训练提升了细节表现与文本生成效果,并支持用户上传参考图引导模型生成特定风格内容。
🎬 视频与矢量模型开放,创作边界拓展
Firefly视频模型已向全量用户开放(此前为限测版)。该模型支持文本/图像生成视频、自定义运镜、起止帧控制、大气元素及动态设计,最高输出1080p分辨率视频片段。
Firefly Vector Model则专注于可编辑矢量艺术创作,可快速迭代生成标志、包装、图标、场景及图案的多种变体。
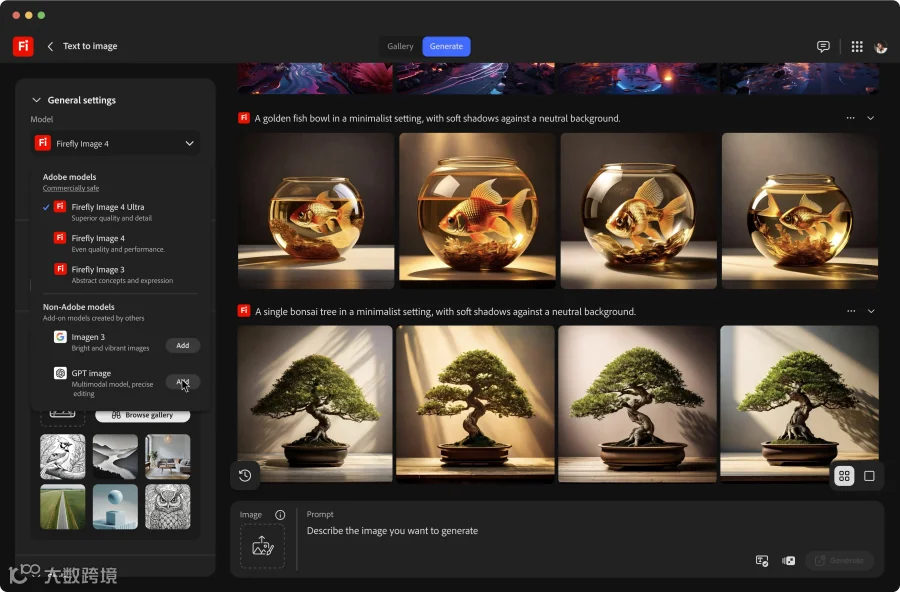
🌐 网页应用聚合多模型,新增协作画布工具
Firefly网页应用现已集成OpenAI(GPT图像)、Google(Imagen 3/Veo 2)及Flux(Flux 1.1 Pro)等第三方模型。用户可自由切换模型,所有生成内容均附带凭证,未来或接入更多AI模型。
同步公测的新工具Firefly Boards是一款AI构思画布,支持生成/导入图像、混音重组及多人协作,功能对标Visual Electric、Cove及Kosmik等平台,可通过Firefly网页端直接使用。

⚙️ API开放与内容确权测试
新模型将陆续整合至Adobe产品矩阵,具体时间表待定。Text-to-Image API与Avatar API已全面可用,Text-to-Video API开放Beta测试,均可通过Firefly Services调用。
Adobe正测试Content Authenticity网页应用,支持为作品附加元数据凭证以明确权属,用户还可自主设定是否允许AI公司使用其图像进行模型训练。