


来自AI实验室Cohere、斯坦福大学、麻省理工学院和Ai2的一篇新论文指控LM Arena——知名众包AI基准Chatbot Arena背后的组织——通过帮助少数AI公司获得更高的排行榜分数,从而损害了竞争对手的利益。
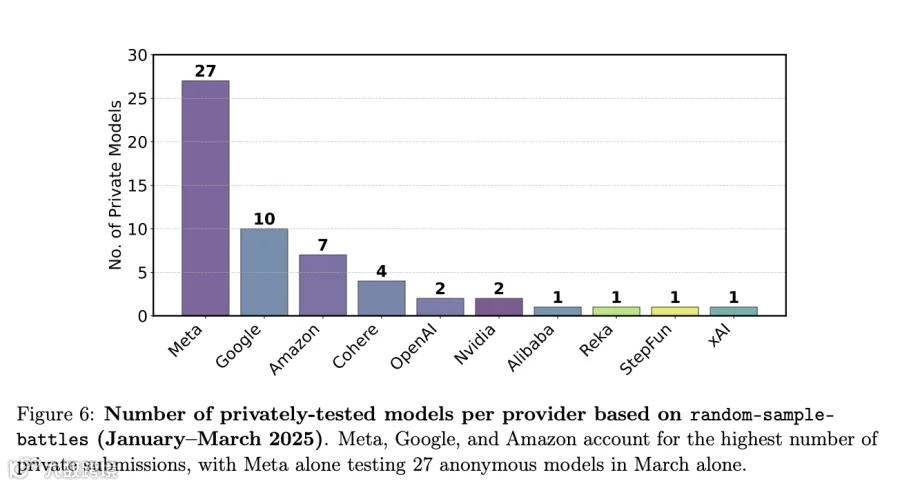
据作者称,LM Arena允许Meta、OpenAI、Google和Amazon等几家行业领先的AI公司私下测试多种AI模型变体,然后不公布表现最差者的得分。这使得这些公司更容易在平台的排行榜上占据榜首位置,尽管并非每家公司都能获得这种机会。
Cohere的AI研究副总裁兼该研究共同作者Sara Hooker在接受采访时指出:“只有少数几家公司被告知可以进行这种私下测试,而某些公司获得的私下测试次数远远多于其他公司,这是一种游戏化行为。”
Chatbot Arena于2023年由加州大学伯克利分校作为学术研究项目创建,现已成为AI公司的首选基准测试平台。其工作原理是将两个不同AI模型的回答并排展示进行“对决”,让用户选择最佳回答。在竞技场中,未发布的模型以化名参与竞争并不罕见。
随时间积累的投票会影响模型的得分,进而影响其在Chatbot Arena排行榜上的排名。虽然许多商业参与者都在使用Chatbot Arena,但LM Arena长期以来一直声称其基准测试是公正且公平的。然而,论文的作者们表示他们发现的情况并非如此。
据作者指控,Meta公司在Llama 4发布前的1月至3月期间,能够在Chatbot Arena上私下测试27个模型变体。在发布时,Meta仅公开了一个模型的得分,而这个模型恰好排在Chatbot Arena排行榜的靠前位置。
LM Arena联合创始人、加州大学伯克利分校教授Ion Stoica在邮件中表示,该研究充满了“不准确之处”和“可疑的分析”。LM Arena在声明中强调:“我们致力于公平、由社区驱动的评估,并邀请所有模型提供商提交更多模型进行测试,以提升其在人类偏好方面的表现。如果一个模型提供商提交的测试比另一个模型提供商多,这并不意味着第二个模型提供商受到了不公平对待。”
所谓受偏袒的实验室
论文作者在2024年11月开始进行研究,当时他们得知一些AI公司可能获得了Chatbot Arena的优先访问权限。总共,他们在五个月的时间里测量了超过280万次Chatbot Arena对决。
作者表示,他们发现了证据表明LM Arena允许包括Meta、OpenAI和Google在内的某些AI公司通过让其模型出现在更多的模型“对决”中来从Chatbot Arena收集更多数据。这种更高的采样率使这些公司获得了不公平的优势。使用来自LM Arena的额外数据可以将模型在Arena Hard(LM Arena维护的另一个基准)上的性能提升112%。不过,LM Arena指出,Arena Hard的性能与Chatbot Arena的表现并不直接相关。
Hooker表示,目前尚不清楚某些人工智能公司是如何获得优先访问权限的,但无论如何,LM Arena都有责任提高其透明度。针对研究中的主张,LM Arena指出非主要实验室开发的模型出现在Chatbot Arena对决中的次数比研究中所建议的更多。
该研究的一个重要局限性在于,它依赖“自我识别”来确定哪些人工智能模型正在Chatbot Arena上进行私有测试。作者多次向人工智能模型询问其所属公司,并依靠模型的回答对其进行分类,这种方法并非万无一失。然而,Hooker表示,当作者联系LM Arena分享初步发现时,该组织并未对此提出异议。
LM Arena陷入争议
在论文中,作者呼吁LM Arena实施多项变革,以使Chatbot Arena更加“公平”。例如,作者指出,LM Arena可以设定一个清晰且透明的上限,限制各人工智能实验室可进行的私有测试次数,并公开这些测试的得分。此外,研究人员还建议调整Chatbot Arena的采样率,以确保竞技场中的所有模型参与相同数量的对战。LM Arena已公开对这一建议表示欢迎,并表示将创建一种新的采样算法。
对于公开预发布模型分数的建议,LM Arena予以拒绝,声称其自2024年3月起就已发布了关于预发布测试的信息,且“展示尚未公开可用的预发布模型的分数是没有意义的”,因为AI社区无法自行测试这些模型。
这篇论文发表数周后,Meta被发现在其上述Llama 4模型发布前后操纵Chatbot Arena的基准测试结果。Meta针对其中一个Llama 4模型优化了“对话性”,这帮助它在Chatbot Arena排行榜上取得了令人印象深刻的分数。但该公司从未发布经过优化的模型,而未经优化的基础版本在Chatbot Arena上的表现要差得多。当时,LM Arena表示,Meta在其基准测试方法上应更加透明。
本月早些时候,LM Arena宣布正在成立一家公司,计划从投资者那里筹集资金。这项研究增加了对私人基准组织的审查力度,并引发人们对其能否在不受企业利益干扰的情况下公正评估AI模型的信任问题。
2025年4月30日晚9:35(太平洋时间)更新:本故事的前一版本引用了一位Google DeepMind工程师的评论,该工程师称Cohere的部分研究内容不准确。该研究人员并未否认Google在1月至3月期间向LM Arena发送了10个模型进行发布前测试(正如Cohere所指控的那样),只是指出负责Gemma的公司开源团队仅发送了一个模型。