


OpenAI推出旗舰级AI模型GPT-5,将为下一代ChatGPT提供核心动力。
周四发布的GPT-5是OpenAI首款“统一”模型,融合了o系列的推理能力与GPT系列的快速响应。这标志着ChatGPT及OpenAI迈入新时代,彰显其开发类智能体(Agent)而非单纯聊天机器人的宏大愿景。
相较于GPT-4的智能问答,GPT-5支持代表用户执行复杂任务,如生成软件应用、管理日历或撰写研究简报。同时,新模型内置实时路由器,可根据问题复杂度自动选择即时回复或深度思考模式,简化了用户设置流程。
OpenAI CEO Sam Altman称GPT-5为“全球最佳模型”,视其为通往通用人工智能(AGI)的重要里程碑,并坦言此类技术在历史上几乎不可想象。
即日起,GPT-5作为默认模型向所有ChatGPT免费用户开放。副总裁Nick Turley表示,此举旨在践行让先进AI广泛惠及大众的使命,此前高阶推理模型仅限付费使用。
作为自2022年ChatGPT爆火以来最受期待的产品,GPT-5被视为AI进展的风向标。目前ChatGPT周活超7亿,约占全球人口10%。业界正密切关注其能否像GPT-4一样带来能力飞跃,进而影响科技巨头、资本市场及监管政策。
GPT-5 在竞争中略占优势
OpenAI宣称GPT-5在多项基准测试中领先Anthropic、Google DeepMind及xAI的竞品,但在部分领域仍互有胜负。
编程方面,GPT-5表现卓越,擅长按需生成完整应用的“氛围编码”。在SWE-bench Verified真实编程测试中,其首次尝试得分74.9%,微幅超越Claude Opus 4.1(74.5%),显著高于Gemini 2.5 Pro(59.6%)。
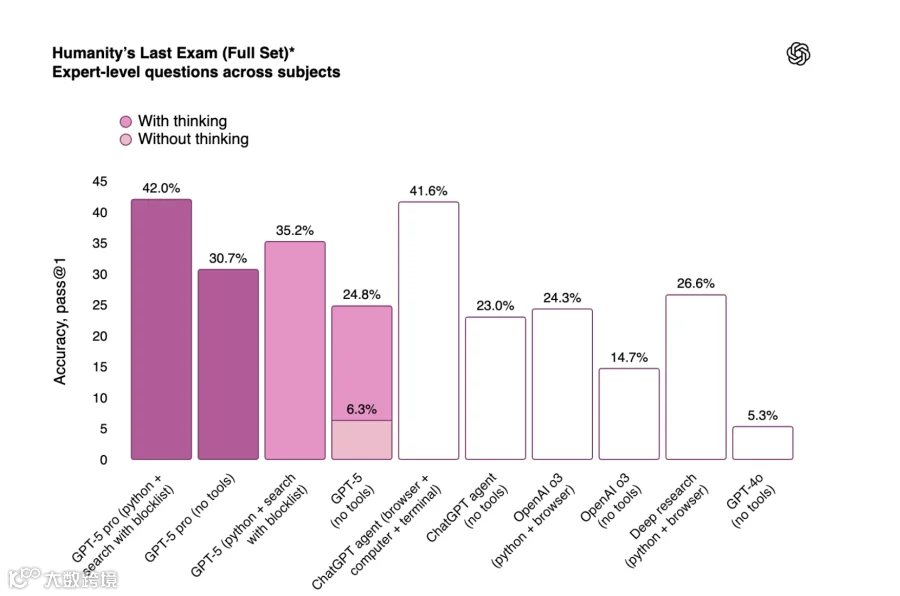
在高难度综合测试Humanity’s Last Exam中,带扩展推理功能的GPT-5 Pro得分为42%,略低于xAI Grok 4 Heavy的44.4%。但在博士级科学问题测试GPQA Diamond中,GPT-5 Pro首试得分89.4%,优于Claude Opus 4.1(80.9%)和Grok 4 Heavy(88.9%)。
医疗健康领域,GPT-5准确性显著提升。HealthBench Hard Hallucinations测试显示,其幻觉率仅1.6%,远低于GPT-4o(12.9%)和o3(15.8%)。针对非专业用户获取健康建议的现状,GPT-5能更主动标记风险并辅助解读结果。
创意设计与写作等主观领域,GPT-5展现出更自然的反应和“更好的品味”。此外,其幻觉问题大幅改善,错误信息回应比例降至4.8%,而o3和GPT-4o分别为22%和20.6%。
Tau-bench模拟任务测试中,GPT-5表现参差不齐:导航航空公司网站得分63.5%(低于o3的64.8%),零售网站导航得分81.1%(低于Claude Opus 4.1的82.4%)。
安全性方面,GPT-5欺骗行为发生率更低,提升了透明度与可信度。同时,它能更精准区分恶意滥用与无害请求,在拒绝不安全问题的同时减少对正常用户的误拒。
面向消费者和开发者的升级
ChatGPT新增四种人格选项:愤世嫉俗者、机器人、倾听者和极客,可自动调整回复风格无需额外指令。
订阅权益分级明确:Plus用户($20/月)享有更高使用限额;Pro用户($200/月)获无限访问权及利用额外算力的增强版GPT-5 Pro;Team、Edu及Enterprise组织将于下周默认接入。
开发者可通过API调用gpt-5、gpt-5-mini和gpt-5-nano三种尺寸模型,并自定义回复长度。基础模型定价为输入令牌$1.25/百万token,输出令牌$10/百万token。
此次发布紧随开源推理模型gpt-oss上线之后。尽管GPT-5在编程等领域树立新标杆,但整体与其他前沿模型大致持平。实际应用中是否真正优于竞品,仍有待市场验证。