


谷歌正为其Gemini聊天机器人升级全新AI图像模型,旨在提升照片编辑的精细控制能力。此举意在追赶OpenAI热门图像工具,并从ChatGPT争夺用户。
此次更新名为Gemini 2.5 Flash Image,将于周二起向Gemini应用全量用户推送,并通过Gemini API、Google AI Studio及Vertex AI平台同步面向开发者开放。
Gemini新AI图像模型支持根据自然语言指令精准编辑图像,同时保持面部、动物及其他细节的一致性,有效解决了多数竞品在此方面的短板。例如,使用ChatGPT或xAI的Grok修改照片中人物衬衫颜色时,常出现面部扭曲或背景篡改等问题。
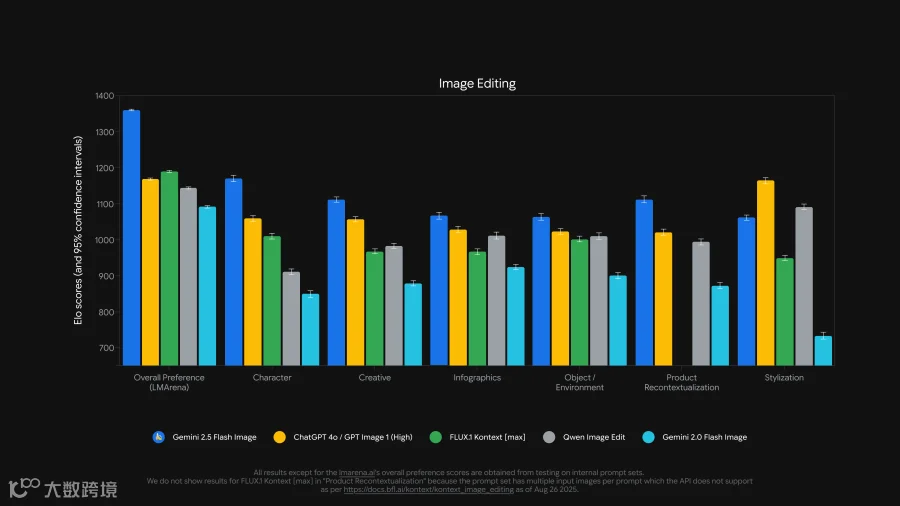
该工具已引发广泛关注。近期,众包评估平台LMArena上的用户对一款表现出色的AI图像编辑器好评如潮,该模型曾以“nano-banana”为代号匿名测试。
谷歌证实即为该模型开发方(从大量香蕉相关提示中亦不难推断),其本质是旗舰模型Gemini 2.5 Flash的原生图像能力。谷歌称,该模型在LMArena及多项基准测试中均处于领先地位。
谷歌DeepMind视觉生成模型产品负责人Nicole Brichtova在接受TechCrunch采访时表示:“我们确实在推动视觉质量进步,并提升模型对指令的遵循能力。”她补充道:“此次更新使编辑流程更无缝,输出结果可适配多种应用场景。”
AI图像模型已成为科技巨头竞争焦点。今年三月,OpenAI推出GPT-4o原生图像生成器后,借助AI生成的吉卜力风格模因热潮,带动ChatGPT使用量大幅攀升。据CEO Sam Altman透露,这些模因甚至让公司GPU“融化”。
为应对竞争,Meta上周宣布将从初创公司Midjourney获取AI图像模型授权;而获a16z投资的德国独角兽Black Forest Labs,则凭借FLUX模型持续领跑各项基准测试。
Gemini出色的AI图像编辑能力或有助于缩小与OpenAI的用户差距。目前ChatGPT周活跃用户已超7亿;而在七月财报电话会上,谷歌CEO Sundar Pichai披露Gemini月活跃用户为4.5亿,意味着其周活数据更低。
Brichtova表示,该图像模型专为消费者场景设计,如辅助家居与花园项目可视化。模型具备更强的“世界知识”,支持单条提示词整合多参考素材——例如将沙发图片、客厅照片与调色板融合为统一渲染图。
尽管新工具提升了逼真图像的制作与编辑效率,谷歌仍设置了内容安全限制。此前,Gemini曾因生成历史不准确的人物图像致歉,并一度回滚AI图像生成功能。
如今,谷歌认为已找到更优平衡点。Brichtova强调:“我们希望赋予用户创作控制权,使其获得所需内容,但这并不意味着毫无约束。”
谷歌服务条款明确禁止生成“非自愿亲密图像”。相比之下,Grok缺乏类似防护机制,允许创建Taylor Swift等名人的AI裸露图像。
针对深度伪造带来的真实性挑战,Brichtova指出,谷歌将在AI生成图像中添加视觉水印,并在元数据嵌入标识符。不过,用户在社交媒体浏览时未必会主动查验这些信息。