


周一,Anthropic 推出前沿模型 Claude Sonnet 4.5,据称其在编码基准测试中表现顶尖。该模型能构建“可直接投入生产”的应用程序,而非仅停留于原型阶段,标志着 AI 模型可靠性的显著提升。
Claude Sonnet 4.5 将通过 Claude API 及聊天机器人提供。开发者定价与上一代持平:输入令牌每百万 3 美元(约 75 万单词),输出令牌每百万 15 美元。
过去一年,凭借在软件工程任务中的卓越表现,Anthropic 模型成为开发者和企业的首选。Apple、Meta 等巨头内部已采用该模型,Anthropic 亦通过向 Cursor、Windsurf、Replit 等 AI 编码应用提供 API 获得可观收入。近期,OpenAI GPT-5 在多项编码基准测试中超越 Claude,对其领先地位构成挑战。
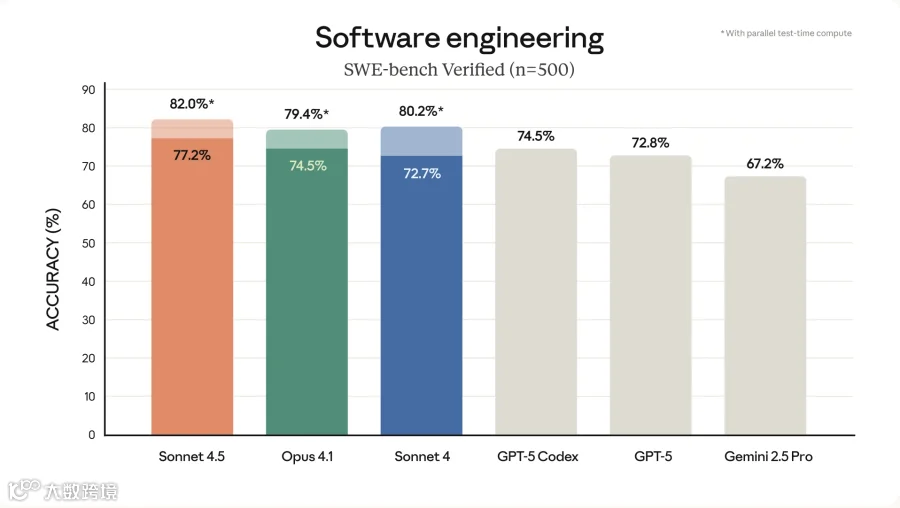
Anthropic 表示,Claude Sonnet 4.5 在 SWE-Bench Verified 等多项编码基准测试中处于行业领先。但研究员 David Hershey 指出,仅凭基准测试难以全面衡量其实际性能。
Hershey 透露,在企业客户早期试验中,Claude Sonnet 4.5 曾自主编码长达 30 小时,期间不仅构建了应用程序,还搭建了数据库服务、购买了域名并执行了 SOC 2 安全审计。
Cursor CEO Michael Truell 评价称,该模型代表了最先进的编码性能,尤其在长周期任务方面;Windsurf CEO Jeff Wang 则将其誉为“新一代编码模型”。
此外,Claude Sonnet 4.5 是 Anthropic 迄今为止对齐程度最高的前沿模型,奉承和欺骗行为发生率更低,且对提示注入攻击的抵抗力有所增强。
伴随新模型发布,Anthropic 同步推出 Claude Agent SDK。这是支撑 Claude Code 运行的基础设施,可助力开发者构建自有智能体。
针对 Max 订阅用户,Anthropic 推出了名为“Imagine with Claude”的临时研究预览版,展示 AI 实时生成软件的能力。该模型无需预设功能或预写代码,即可实时响应用户请求。
当前 AI 领域竞争激烈,旗舰模型更新已成常态。Claude Sonnet 4.5 距上一款模型 Opus 4.1 发布不足两月,快速迭代使得任何公司都难以长期维持显著领先优势。