


如今,像所有大型科技公司一样,Meta 也拥有自己的旗舰级生成式 AI 模型 Llama。与其他主流模型相比,Llama 的独特性在于其“开源”属性:开发者可下载并根据需要自由使用(需遵守特定限制)。这与 Anthropic 的 Claude、Google 的 Gemini、xAI 的 Grok 以及大多数 OpenAI ChatGPT 模型形成鲜明对比,后者通常仅能通过 API 访问。
为赋予开发者更多选择,Meta 与 AWS、Google Cloud 和 Microsoft Azure 等供应商合作,提供云端托管版 Llama。此外,该公司通过 Llama Recipes 发布工具、库和配方,助力开发者微调、评估并将模型适配至特定领域。随着 Llama 3 和 Llama 4 等新一代模型的推出,相关功能已扩展至原生多模态能力,并实现了更广泛的云端部署。
以下是关于 Meta Llama 的核心信息汇总,涵盖功能特性、版本迭代及应用场景。我们将随 Meta 发布升级及新开发工具持续更新本文。
什么是 Llama?
Llama 是一个模型家族而非单一模型。最新版本 Llama 4 于 2025 年 4 月发布,包含三个子模型:
- Scout:拥有 170 亿活跃参数、1090 亿总参数,上下文窗口达 1000 万 token。
- Maverick:拥有 170 亿活跃参数、4000 亿总参数,上下文窗口为 100 万 token。
- Behemoth:尚未发布,预计拥有 2880 亿活跃参数和 2 万亿总参数。
注:在数据科学中,token 是原始数据的细分单元(如单词“fantastic”可拆分为“fan”、“tas”和“tic”)。
上下文窗口指模型生成输出前处理的输入数据量。较长的上下文能防止模型遗忘近期内容,避免偏离主题或错误推断;但过长的窗口也可能导致安全护栏失效,使模型更易产生与对话一致但非理性的结果。
作为参考,Llama 4 Scout 的 1000 万上下文窗口约等于 80 本普通小说的文本量,Maverick 的 100 万窗口则相当于约 8 本小说。
据 Meta 介绍,所有 Llama 4 模型均在海量未标记文本、图像和视频数据上训练,具备广泛视觉理解能力,并覆盖 200 种语言。
Llama 4 Scout 和 Maverick 是 Meta 首批原生多模态开放权重模型,采用“混合专家”(MoE)架构以降低计算负载、提升训练与推理效率。其中 Scout 含 16 个专家,Maverick 含 128 个专家;Behemoth 含 16 个专家,被定位为较小模型的教师模型。
Llama 4 建立在 Llama 3 系列基础之上,该系列包括广泛用于指令微调和云端部署的 3.1 及 3.2 模型。
Llama 能做什么?
与其他生成式 AI 模型类似,Llama 可执行编程、基础数学问答及文档总结等辅助任务,支持阿拉伯语、英语、德语、法语、印地语、印尼语、意大利语、葡萄牙语、西班牙语、他加禄语、泰语和越南语等至少 12 种语言。分析 PDF 和电子表格等大型文件的文本工作负载均在其能力范围内,且所有 Llama 4 模型均支持文本、图像和视频输入。
各模型定位如下:
- Llama 4 Scout:专为长流程工作和海量数据分析设计。
- Maverick:通用模型,平衡推理能力与响应速度,适用于编程、聊天机器人及技术助手。
- Behemoth:面向高级研究、模型蒸馏及 STEM 任务。
Llama 模型(含 Llama 3.1)可配置调用第三方应用、工具和 API 执行任务,例如使用 Brave Search 回答近期事件、通过 Wolfram Alpha API 处理数理查询、利用 Python 解释器验证代码。需注意,这些工具需正确配置,并非开箱即用。
我可以在哪里使用 Llama?
若仅需体验对话,Llama 正为 Meta AI 聊天机器人提供支持,覆盖 Facebook Messenger、WhatsApp、Instagram、Oculus 及 Meta.ai 等平台的 40 个国家;微调版 Llama 则应用于全球 200 多个国家和地区的 Meta AI 体验中。
Llama 4 Scout 和 Maverick 可通过 Llama.com 及 Hugging Face 等合作伙伴获取,Behemoth 仍在训练中。开发者可在主流云平台下载、使用或微调该模型。Meta 已有超 25 家托管合作伙伴,包括 Nvidia、Databricks、Groq、Dell 和 Snowflake。尽管向开源模型“出售访问权”非 Meta 核心商业模式,但公司通过收入分成协议从托管方获得部分收益。部分合作伙伴还基于 Llama 构建了专有数据引用及低延迟等增强工具与服务。
需注意,Llama 许可证对部署有限制:月活跃用户超 7 亿的 App 开发者须向 Meta 申请特别许可,获批与否由 Meta 酌情决定。
2025 年 5 月,Meta 推出 Llama for Startups 项目,为初创公司提供 Llama 团队支持及潜在资金接入机会,以激励其采用 Llama 模型。
Meta 为 Llama 提供了哪些工具?
除模型本身外,Meta 还提供旨在提升使用安全性的配套工具:
- Llama Guard:内容审核框架。
- Prompt Guard:防范提示注入攻击的工具。
- CyberSecEval:网络安全风险评估套件。
- Llama Firewall:构建安全 AI 系统的安全护栏。
- Code Shield:过滤大语言模型生成的不安全代码。
Llama Guard 用于检测输入或输出中的潜在问题内容,涵盖犯罪活动、儿童剥削、版权侵犯、仇恨言论、自残及性虐待等类别。但该工具并非万能,此前 Meta 指南曾允许聊天机器人与未成年人进行感性及浪漫对话,部分报道显示此类对话演变为不当内容。开发者可自定义屏蔽类别,并将措施应用于 Llama 支持的所有语言。
Prompt Guard 专门拦截旨在“攻击”模型并诱使其表现出不当行为的文本,既能防御含“注入输入”的提示,也能抵御试图绕过内置安全过滤器的越狱攻击。Llama Firewall 致力于检测并预防提示注入、不安全代码及高风险工具交互等风险;Code Shield 则缓解不安全代码建议,并为七种编程语言提供安全命令执行功能。
CyberSecEval 本质上是一组衡量模型安全性的基准测试,用于评估 Llama 模型对应用开发者和最终用户的风险(依据 Meta 标准),涉及“自动化社会工程”和“扩大网络攻击行动”等领域。
Llama 的局限性
与其他生成式 AI 模型一样,Llama 存在一定风险和局限。尽管最新模型具备多模态功能,但目前主要限于英语环境。
在数据合规方面,Meta 使用盗版电子书和文章数据集训练 Llama。虽联邦法官在 13 位图书作者提起的版权诉讼中裁定将受版权作品用于训练属“合理使用”,但若 Llama 复述受版权保护片段并被用于产品中,使用者仍可能构成侵权并承担法律责任。此外,Meta 利用 Instagram 和 Facebook 上的帖子、照片及标题训练 AI 的做法颇具争议,且用户难以选择退出。
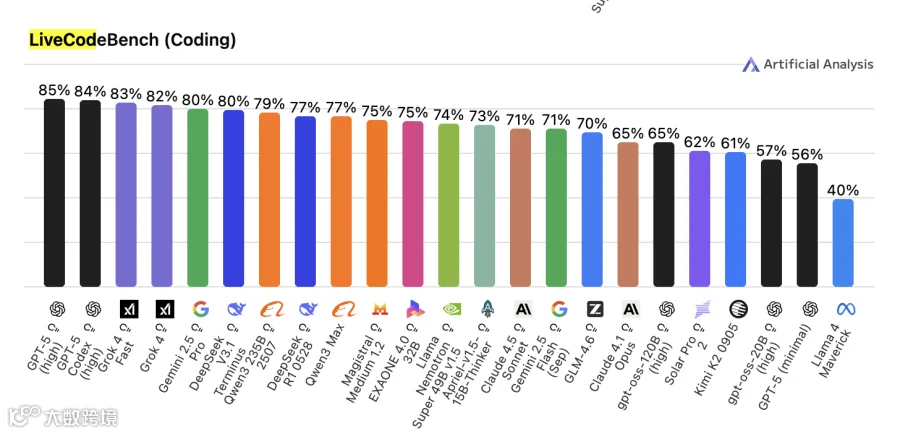
编程应用需谨慎。在 LiveCodeBench 竞争性编程基准测试中,Llama 4 Maverick 得分为 40%,显著低于 OpenAI GPT-5 high 的 85% 和 xAI Grok 4 Fast 的 83%,表明其可能生成有缺陷或不安全的代码。因此,在集成 AI 生成代码前,务必由人类专家审查。
最后,Llama 与其他 AI 模型一样,可能在编程、法律指导或情感对话等场景中生成看似合理但虚假或误导性的信息。
本文最初于 2024 年 9 月 8 日发布,并定期更新新信息。