


AI模型的上下文窗口(表示模型“记住”信息的能力)随时间推移不断增加,但研究人员提出新方法以增强AI模型的长期记忆,因为它们通常无法在多个会话间保持上下文。
19岁的创始人Dhravya Shah正试图通过为AI应用构建名为Supermemory的记忆解决方案来解决该领域的问题。
创始人背景与项目起源
Shah来自印度孟买,几年前开始构建面向消费者的机器人和应用程序。他甚至将自己的一款将推文格式化为美观截图的机器人出售给了社交媒体工具Hypefury。
这位创始人当时正在准备印度理工学院(IIT)的入学考试,他通过这笔交易赚了不少钱,并决定前往美国就读亚利桑那州立大学。
搬迁后,他挑战自己在40周内每周构建一个新项目。其中一周,他构建了Supermemory(最初名为Any Context)并将其发布在GitHub上。当时,该工具允许用户与他们的Twitter书签进行对话。
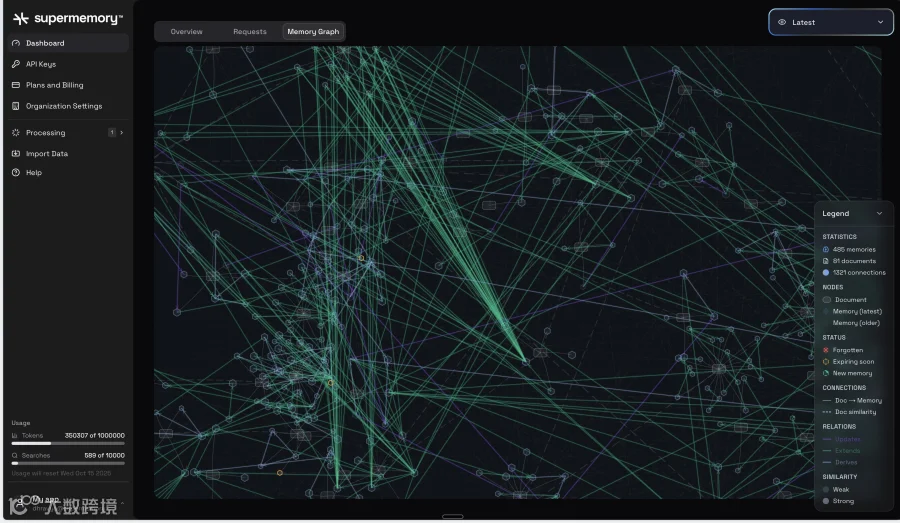
该工具的最新版本能够从非结构化数据中提取“记忆”或见解,帮助应用程序更好地理解上下文。
产品功能与应用场景
2024年,Shah在Cloudflare获得了实习机会,从事AI和基础设施方面的工作。后来,他在该公司担任开发者关系负责人。在此期间,包括Cloudflare CTO Dane Knecht在内的顾问们建议他将Supermemory打造为一款产品。今年,他决定全职开发Supermemory。
Supermemory现在被描述为面向AI应用的通用记忆API,它根据处理的数据构建知识图谱,并为用户个性化上下文。例如,它可以支持写作或日记应用查询一个月前的条目,或者用于电子邮件应用的搜索。由于该解决方案支持多模态输入,视频编辑人员也可以利用它从素材库中获取特定提示词的相关资源。
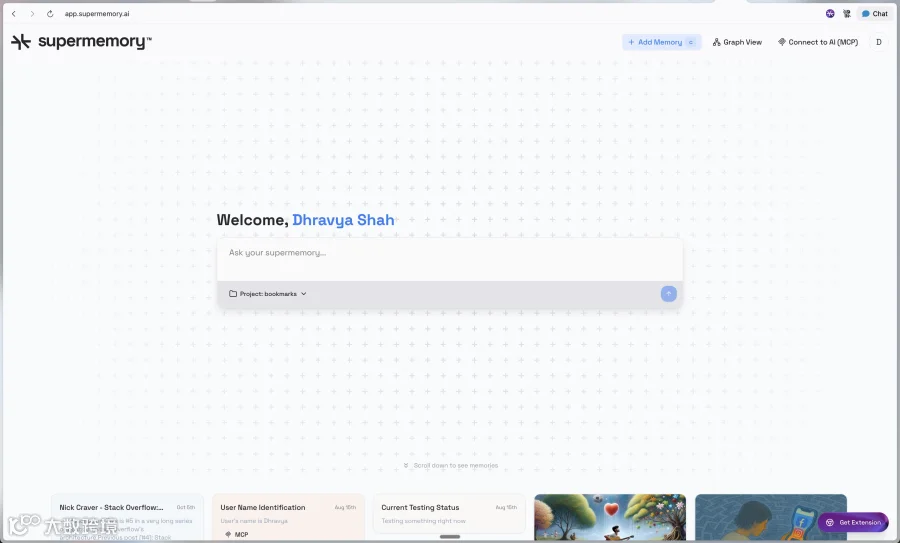
该公司表示,Supermemory可以摄入任何类型的数据,包括文件、文档、聊天记录、项目、电子邮件、PDF和应用数据流。其聊天机器人和笔记功能允许用户以文本形式添加记忆、上传文件或链接,并连接Google Drive、OneDrive或Notion等应用。此外,还有一个Chrome扩展程序,让用户可以轻松地从网站添加笔记。
Shah表示:“我们的核心优势是从各类非结构化数据中提取见解,并为应用程序提供更多关于用户的上下文信息。由于我们处理多模态数据,我们的解决方案适用于各种类型的AI应用,从电子邮件客户端到视频编辑器。”
融资情况与客户生态
Supermemory已获得由Susa Ventures、Browder Capital和SF1.vc领投的260万美元种子轮融资。该轮投资还包括Cloudflare的Knecht、Google AI负责人Jeff Dean、DeepMind产品经理Logan Kilpatrick、Sentry创始人David Cramer,以及OpenAI、Meta和Google的高管等个人投资者。
Shah表示,Y Combinator曾一度邀请他加入其某个孵化批次,但他当时已经找到了投资者,因此时机并不合适。
Joshua Browder是“机器人律师”初创公司DoNotPay的创始人兼CEO,他以单人普通合伙人(solo GP)身份运营Browder Capital,他对Shah的坚韧印象深刻。
他说:“我在X上与Dhravya取得了联系,令我印象深刻的是他行动迅速且能快速构建产品,这促使我决定投资他。”
该公司拥有多个现有客户,包括由a16z支持的桌面助手Cluely、AI视频编辑器Montra、AI搜索Scira、Composio的多MCP工具multi-MCP tool Rube,以及房地产初创公司Rets。此外,它正与一家机器人公司合作,以保留机器人捕获的视觉记忆。
虽然这偏向消费者市场,但该应用更像是一个开发者的游乐场,让他们更深入地了解该工具,并可能将其用于自己的工作流或自己的应用中。
市场竞争与优势
Supermemory在记忆领域面临强大的竞争对手。像Felicis Ventures支持的Letta和Mem0(Shah曾短暂在此工作)这样的初创公司正在为智能体构建记忆层。Supermemory自身的投资方Susa Ventures也投资了Memories.ai,并与三星合作,后者可以利用数千小时的录像来获取洞察。
Shah表示,尽管这些初创公司可能服务于不同的行业和使用场景,但Supermemory将因其更低的延迟而脱颖而出。
“越来越多的AI公司将需要记忆层。Supermemory的解决方案在提供高性能的同时,还能快速呈现相关上下文,”Browder说。