


印度AI实验室Sarvam周二发布新一代语言模型,押注较小、高效的开源AI模型能从美中竞争对手的昂贵系统中抢占市场份额。
此次发布在德里举行的“印度AI影响力峰会”上宣布,与德里推动减少对外国AI平台依赖、针对本地语言和使用案例定制模型的举措相一致。
Sarvam表示,新阵容包括300亿和1050亿参数模型、文本转语音模型、语音转文本模型及文档解析视觉模型。这标志着对其2024年10月发布的20亿参数Sarvam 1模型的显著升级。
300亿和1050亿参数模型采用混合专家架构,一次仅激活总参数的一小部分,显著降低计算成本。其中,30B模型支持32,000 token上下文窗口,旨在实现实时对话;较大模型提供128,000 token窗口,用于复杂多步推理任务。
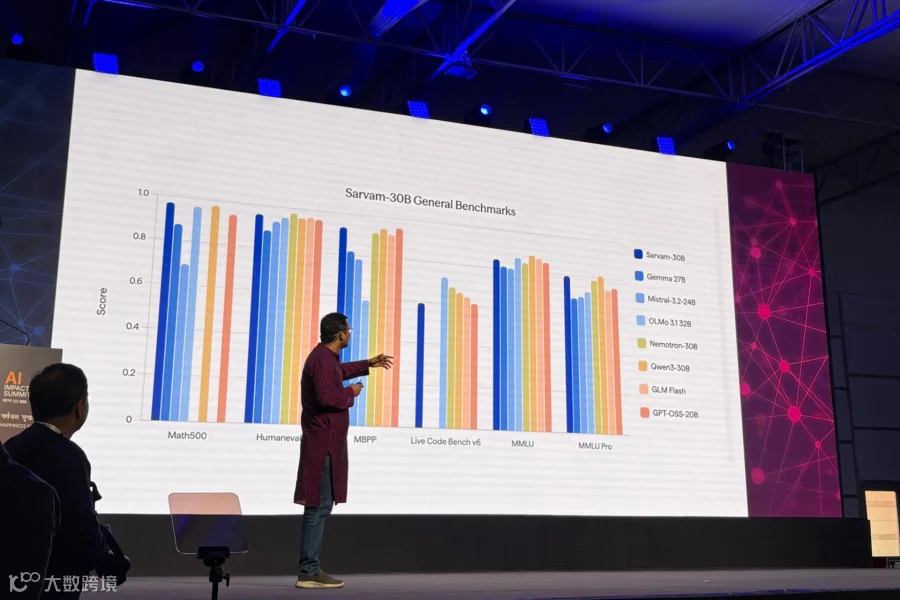
新AI模型均为从头训练,而非基于现有开源系统微调。30B模型在约16万亿token文本上预训练,105B模型则在涵盖多种印度语言的数万亿token上训练。
这些模型旨在支持实时应用,包括基于语音的助手和印度语言聊天系统。

模型训练获印度政府支持的IndiaAI Mission计算资源支持,数据中心运营商Yotta提供基础设施,Nvidia提供技术支持。
Sarvam高管表示,公司计划谨慎扩展模型,专注于实际应用而非原始规模。
“我们希望在扩展时保持谨慎,”Sarvam联合创始人Pratyush Kumar在发布会上说,“我们不希望盲目地扩展。我们希望了解真正重要的任务,并为之构建。”
Sarvam计划开源30B和105B模型,但未说明是否公开训练数据或完整训练代码。
该公司还概述了构建专用AI系统的计划,包括专注编码的模型、企业工具(Sarvam for Work)及对话式AI代理平台Samvaad。
成立于2023年的Sarvam已筹集超4000万美元资金,投资者包括Lightspeed Venture Partners、Khosla Ventures及Peak XV Partners(原赛富印度)。