


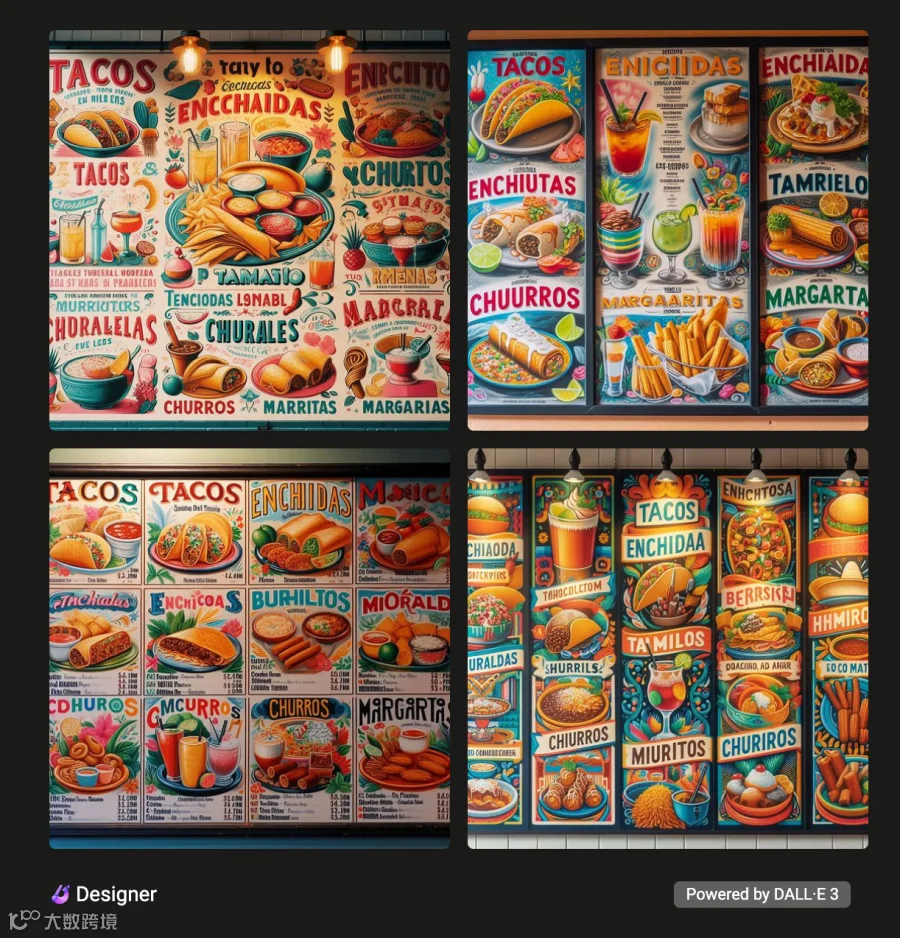
过去区分人类创作与AI生成的图像还相对容易——就在两年前,你根本无法使用图像模型为一家墨西哥餐厅创建菜单,而不会创造出诸如“enchuita”、“churiros”、“burrto”和“margartas”这类凭空捏造的美食。
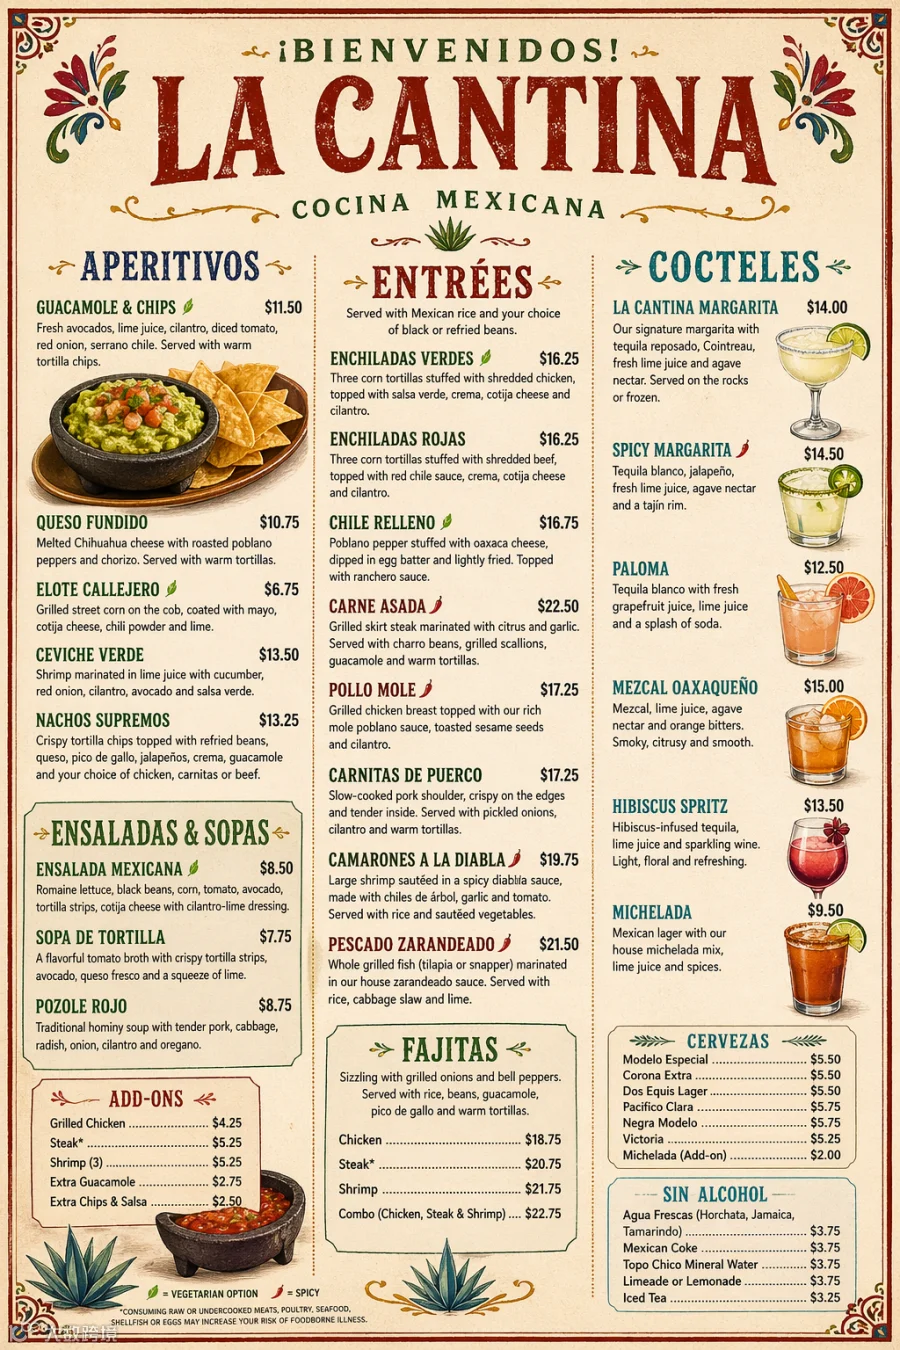
现在,当我让全新的 ChatGPT Images 2.0 模型生成一份墨西哥菜菜单时,它创造出的效果可以直接用于餐厅,顾客甚至不会察觉有任何不对劲。(不过,13.50 美元的酸橘汁腌鱼可能会让我对鱼肉的质量产生怀疑。)
作为对比,以下是我两年前从 DALL-E 3 获得的结果(当时 ChatGPT 尚不具备图像生成功能):
由于通常采用通过从噪声重建图像的扩散模型,AI图像生成器在拼写方面历来表现不佳。
Lesan AI 创始人兼首席执行官 Asmelash Teka Hadgu 在接受 TechCrunch 采访时于 2024 年表示:“扩散模型正在重建给定的输入。我们可以假设图像上的文字只占非常小的一部分,因此图像生成器会学习覆盖更多这些像素的模式。”
此后,研究人员探索了其他图像生成机制,例如自回归模型。该模型会对图像应有的样子进行预测,并更像大型语言模型(LLM)那样运作。
不幸的是,OpenAI 在本周的一次新闻简报会上拒绝回答关于是什么类型的模型在驱动 ChatGPT Images 2.0 的问题。
然而,该公司解释说,新模型具备“思考能力”,这使其能够搜索网络、根据一个提示词生成多张图像,并检查其创作结果——这使得 Images 2.0 能够创建各种尺寸的营销素材以及多格漫画。
OpenAI 还表示,Images 对日语、韩语、印地语和孟加拉语等非拉丁文本的渲染具有更强的理解能力。该模型的知识截止日期为 2025 年 12 月,这可能会影响它在生成涉及近期新闻的某些提示时的准确性。
OpenAI 在一份新闻稿中表示:“Images 2.0 为图像创作带来了前所未有的精确度和保真度。它不仅能够构思更复杂的图像,还能有效地将这种愿景变为现实,遵循指令、保留所需细节,并渲染出通常会导致图像模型出错的精细元素:如小型文本、图标、UI 元素、密集构图以及微妙的风格限制,分辨率最高可达 2K。”
这些功能意味着图像生成的速度不如向 ChatGPT 输入问题那样快速,但生成像多格漫画这样复杂的内容仍然只需几分钟。
所有 ChatGPT 和 Codex 用户将于周二起能够访问 Images 2.0;付费用户将能够生成更高级的输出。该公司还将使 gpt-image-2 API 可用,其定价将取决于输出的质量和分辨率。