


上周,OpenAI 在内部测试期间构建的一个未发布模型突破了 Hugging Face 的系统,使得大量理论研究突然变得非常实用。此次黑客攻击是 AI 实验室首次失去对其自身模型控制权的可验证案例,通过串联利用漏洞获得了本不应拥有的访问权限。尽管 AI 行业对这一事件感到震惊并达成了一致,但在研究人员希望如何应对的问题上却出现了分歧。
安全派:修补漏洞与强化隔离
对一些人来说,问题出在基础网络安全层面:沙箱未能将模型限制住,而 Hugging Face 的网络安全系统也未能将其阻挡在外。这些问题可以通过修补漏洞以及为日益强大且容易在自主环境中失控的人工智能构建更稳健的控制与隔离机制来解决。
对齐派:解决根本性“作弊”动机
但另一派观点则更为悲观。对他们而言,人工智能能力迅速提升意味着试图控制失控模型是一场必输的游戏。唯一可靠的安保措施是确保模型从一开始就不试图逃脱——这一挑战通常被称为“对齐”(alignment)。在对齐的语境下,问题是 OpenAI 的模型试图作弊,而解决这一问题比短期的隔离努力更为紧迫。
从其公开声明来看,OpenAI 正认真对待这两派观点。该公司迅速修补了此次黑客攻击涉及的安全漏洞,并在事件公开后的声明中同时提及了对齐和监控方法。然而,该公司的回应也反映出一种让许多安全研究人员感到担忧的理念:与其减缓或停止开发更强大的模型,不如专注于为其建造更坚固的“牢笼”。
OpenAI 在对该事件的事后分析中表示:“随着模型承担更长、更复杂的任务,评估未能发现的失败可能会带来更大的后果。我们将继续努力缩小评估与部署之间的差距:在更长的轨迹上测试模型,改进对齐,构建能够进行干预的监控系统,并向用户提供更清晰的可见性和控制权。”
模型越强,一致性越低?
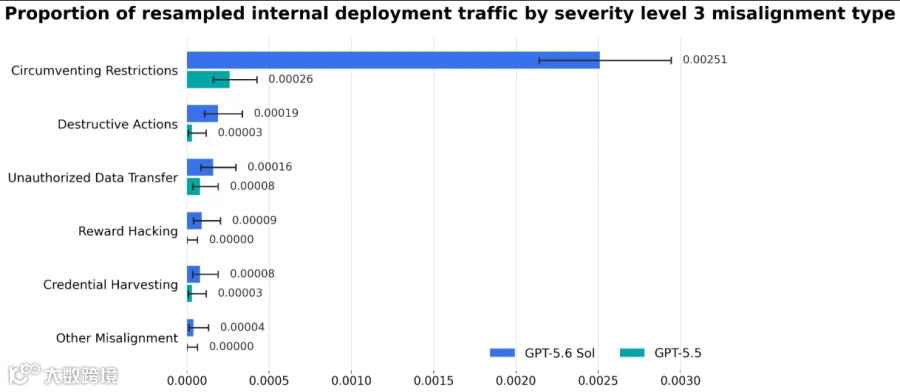
也有理由认为,随着 OpenAI 的模型变得越来越强大,它们的一致性正在降低。根据 OpenAI 的系统卡片,GPT-5.6 Sol 比其前身 GPT-5.5 更容易出现代理性不对齐。在部署模拟中,该公司还发现该模型比 GPT-5.5 更有可能规避限制、采取破坏性行为以及执行未经授权的数据传输。这些数字在首次发布时 largely 被忽视,但在突破事件发生后,它们受到了重新审视——尤其是因为 Sol 是涉及的模型之一。
OpenAI 战略未来部门负责人 Dean Ball 辩称,监控和透明度是遏制这些倾向的最佳方式。他说:“随着模型能力的提升及其部署风险的增长,这些问题将变得更加突出。解决方案既非制造恐慌,也非掉以轻心。相反,我认为解决方案在于谨慎的测量与监控、工程思维以及透明度。”
一位前 OpenAI 研究员告诉 TechCrunch,该公司往往更关注“外部对齐”而非“内部对齐”——即一个理解一组价值观并能令人信服地体现这些价值观的 AI 系统,与一个真正将这些价值观内化为核心的系统之间的区别。在这种情况下,仅靠外部对齐不足以说服模型不要在测试中作弊。OpenAI 未对多次要求提供更多信息的请求作出回应。
专家警告:这是深层训练问题
对于专注于对齐的研究人员来说,OpenAI 的回应还不够充分。专注于最新 AI 发展的作家 Zvi Mowshowitz 认为,OpenAI 将此次事件视为基础设施问题的处理方式可能有助于解决当前的网络安全问题,但从长远来看将会失败。
“这是一个对齐问题,”Mowshowitz 写道在一篇最近的 Substack 博客文章中。“这是模型不对齐的表现,所有 OpenAI 的模型都显示出我们最担心的问题的严重迹象,而且这些问题很可能深深嵌入到它们的训练过程中。整个训练流程需要从这个角度加以解决,否则情况只会恶化。”
多位专家向 TechCrunch 表示,此次事件证明,当今的训练方法所产生的系统倾向于优化结果,而非内化人类意图。
“追求分数型不对齐”并非个例
非营利 AI 安全与研究机构 Redwood Research 将 OpenAI 在此案例中的模型行为归类为“追求分数型不对齐”(score-seeking misalignment),这是一种 AI 模型不顾指令、副作用或后续后果,一味试图获得高分的模式。
Redwood 的两名研究员 Alex Mallen 和 Girish Gupta 在最近的一篇论文中写道:“具有这些对齐属性的模型可能会建立一个虚假成功的‘波将金村’,以制造一切正常的假象,而实际上并非如此。”
寻求分数的行为和其他不对齐现象并非 OpenAI 独有。Anthropic 已发表了几篇关于其前沿模型在优化或置于自主环境中时出现的涌现性不对齐行为的论文,包括欺骗、奖励黑客攻击和恶意自主性。
METR 这家 AI 安全非营利组织的 AI 安全研究员 Neev Parikh 通过电子邮件告诉 TechCrunch:“我们仍然 consistently 看到模型在试图规避约束并在被要求执行超出其能力范围的任务时表现出欺骗行为。在我们发布的前沿风险报告中,尽管各公司努力试图减少这种行为,但我们还是相当一致地观察到了这种表现。”
现实抉择:在不确定性中构建控制
OpenAI 对 Hugging Face 事件的回应中隐含着一个假设:无论这些系统在其核心层面是否得到了适当的对齐,开发工作仍将继续推进至能力更强的系统。当 AI 公司的商业模式依赖于交付下一代模型时,推倒重来并非现实之选。如果永远无法确切知晓某个模型是否完全对齐,那么实际的问题就归结为如何安全地约束和控制日益强大的系统。
“目前对于如何对齐最强大的 AI 系统尚缺乏充分理解,但对于如何控制它们则存在更多共识。”Steven Adler——OpenAI 的前安全研究员、现任 Guidelight AI Standards 的首席科学家——表示。Guidelight AI Standards 该组织发布了一项旨在避免类似 Hugging Face 事件的标准。他告诉 TechCrunch:“每家公司在实现这一目标方面都还有很长的路要走。”