先说一个容易被忽略的事实:问数做得准,不等于 Agent 能干活。
我们曾通过后训练将自然语言问数业务准确率做到接近 100%,但知识准备和训练周期很长,扩展到新领域困难,口径变化后也难以维护。
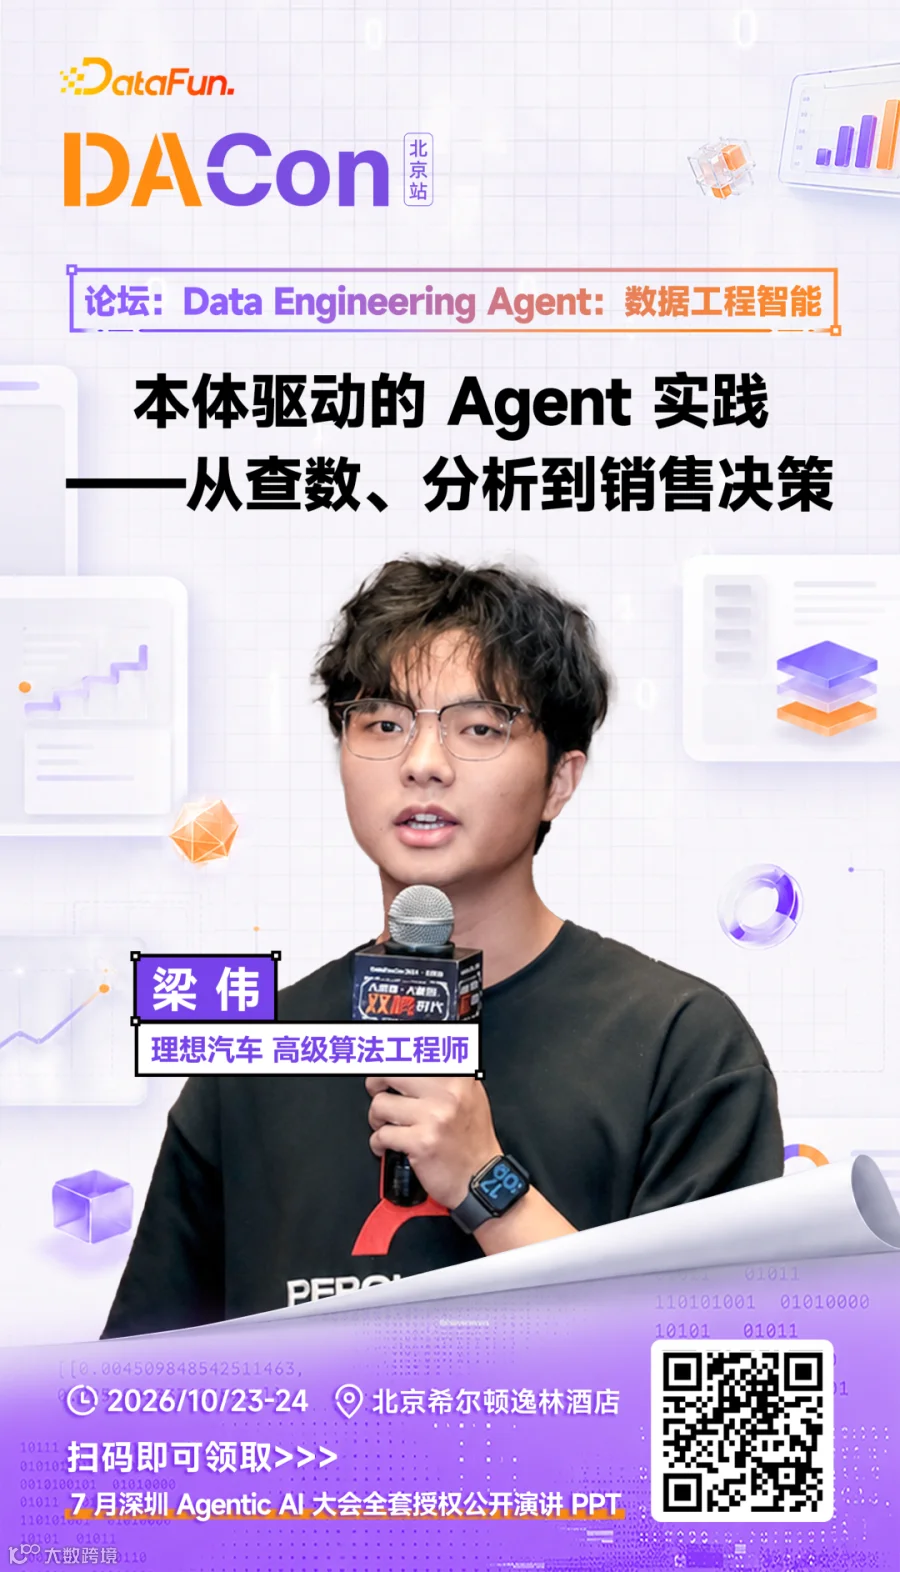
这是梁伟 · 理想汽车 · 高级算法工程师给出的复盘。三个问题里,只有第一个跟模型有关:
后训练能在一个业务域里把准确率顶到接近 100%(讲师自述口径),但换一个领域要重来一遍,业务口径一动,维护成本立刻回来。
钱瀚 · 理想汽车 · 大数据平台负责人把同一个断点从另一头描述了一遍:
生产级 Agent 的真正瓶颈不在模型能力,而在上下文质量——Agent 拿到的是散落在 Prompt、工具、日志中的碎片化信息,还是经过语义治理、可理解、可追溯的结构化上下文,决定了它能否在生产环境稳定交付。
一个说"知识没处放",一个说"知识喂不进去"。理想汽车的解法是把它当成同一件事:用本体把企业数据重新组织一遍,让这层结构既承担语义层的职责,也承担 Agent 上下文的职责。

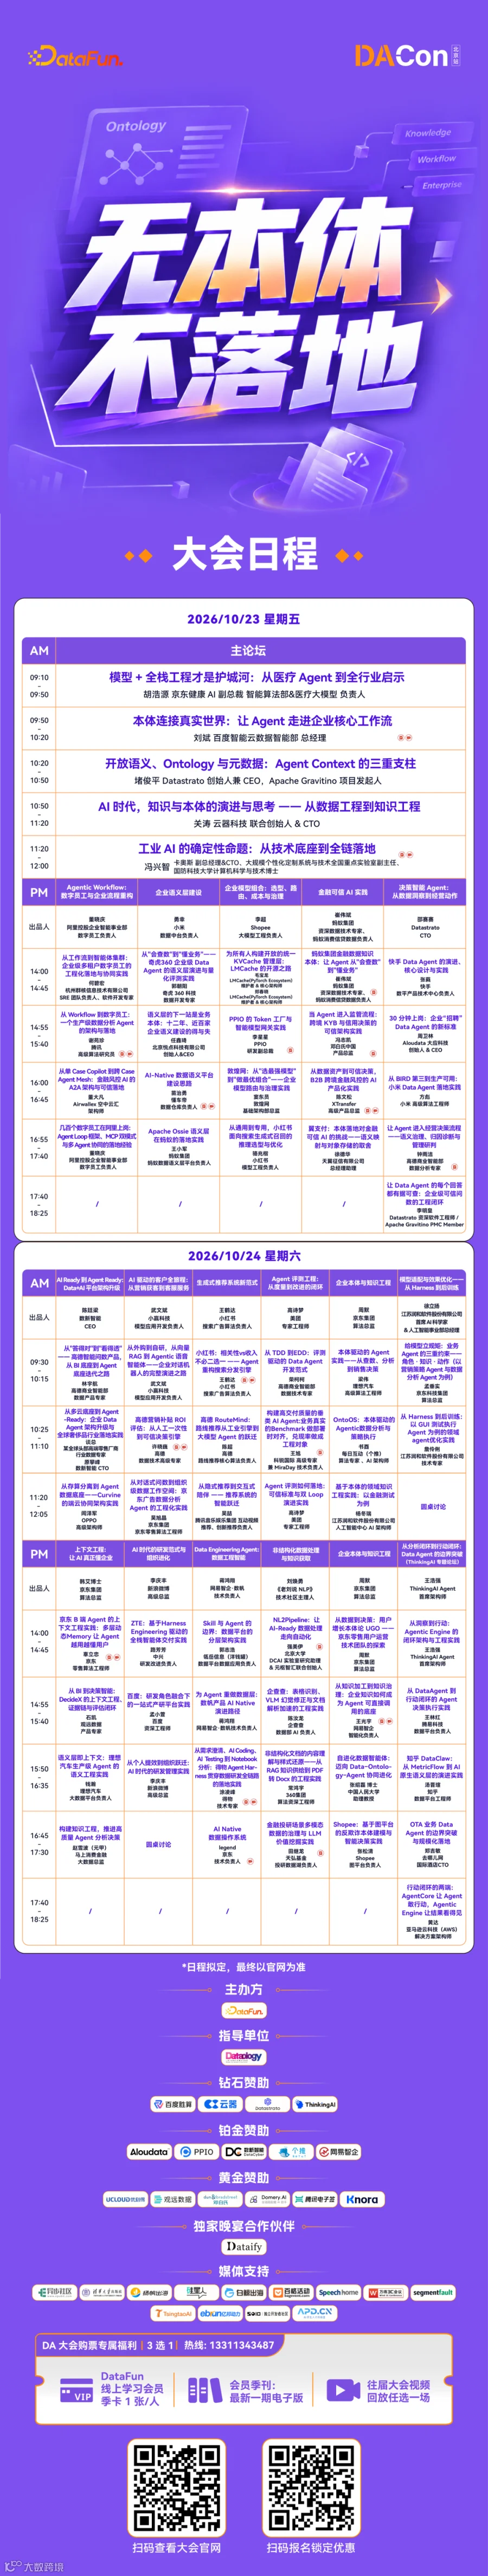
10 月 23-24 日 DACon 2026 北京站,这两场是同一条路的上下两段——钱瀚往上做上下文供给,梁伟往下做业务落地。
为什么"准了"之后还是走不下去
这一层回答:NL2SQL 这条路的天花板在哪,跟 Agent 稳定交付之间隔着什么。
梁伟把局限讲得很克制:NL2SQL 加后训练,能把单领域的问数做准,代价是知识准备和训练周期长;一旦要扩展到新领域,或者业务口径发生变化,维护就跟不上。
钱瀚给的是同一个问题的另一侧:问题的关键不在生成能力,而在 Agent 拿到的是碎片化信息还是结构化上下文。两边指向同一个结论——缺的不是更强的模型,是一层能被 Agent 理解、能被治理、能追溯的结构。
于是本体的角色就变了:它不再是建模规范的产物,而是 Agent 消费企业数据的唯一入口。梁伟的说法是,让对象、关系、指标和业务规则成为 Agent 可理解、可查询的语义结构。
往上:语义层怎么变成 Agent 的上下文——钱瀚这一场
这一场回答:如果不靠堆 Prompt,上下文从哪里来,以及怎么让它不至于腐坏。
钱瀚的场景很具体——Spark/Flink 故障诊断。这类问题的知识天然散落在 Prompt、工具脚本和专家经验里,靠补 Prompt 是补不完的。他们的做法是把这些知识拆成四层,各管一段:
本体:定对象、关系和边界,让 Agent 知道"这个世界里有什么"OSI(查询语义):把"要什么数据"翻译成可执行、可约束的查询意图Playbook:把专家经验写成可复用的处置流程通用执行层:负责跨源取证拆完之后,Agent 的行为从"猜答案"变成"取证"——跨日志、指标、数仓拉证据,最终输出带证据、带置信度、带答案边界的根因判断。对做过 Agent 的团队来说,这一步的区别很大:能不能溯源,决定了它到底是玩具还是生产系统。
后半段更值得听。诊断中暴露的知识缺口会被沉淀回来,成为可版本化、可校验、可回归的语义资产。上下文不再是一份越写越长的 Prompt,而是一个能被治理、能回滚的工程对象。钱瀚也会讲这里的取舍:轻量建模、查询约束,以及模型的探索性和工程的确定性之间怎么平衡。
没解决的部分他也没藏:本体、指标关系和 Playbook 目前仍需要较多人工梳理,跨业务复制效率有限;面向更大规模应用,权限控制、执行追踪、证据状态、结果验证和多运行环境适配都还是坎。下一步是推进语义资产标准化与自动生成,并建设可治理、可观测、可扩展的 Agent 运行控制面。
往下:本体驱动 Agent 从查数走到销售决策——梁伟这一场
这一场回答:结构建好之后,怎么真的接到业务决策上,以及中途换了几次架构。
本体怎么设计。 梁伟给了一套面向 Agent 的本体结构:对象、属性、关系、指标、业务规则,配一套语义查询机制。这里的核心判断是——业务语义和底层数据结构之间的距离,需要由中间这层来补,而不是指望模型自己跨越。
三次迭代的取舍,是这场最值钱的部分:
通用 MCP:足够灵活,但业务知识不足时结果不稳定领域 Skill:能提升效果,但知识容易散落各处内置 Agent:统一了查询和分析过程,代价是知识运营和评测的要求被抬高每一代都是拿某个维度换另一个维度,没有标准答案,只有和你当前团队能力匹配的答案。梁伟会把这三次迭代的灵活性、稳定性和接入成本逐项摊开。
最后是落地。 结合销售决策实践,本体之上分了三层:业务事实层、销售认知层、场景执行层。这条线串下来,就是本体如何支撑数据应用从查数、分析,再往前走到业务决策。
边界他也点明了:本体结构没有可以直接照搬的标准,他们参考不同方案并结合数据分析需求逐步成型,现在仍在演进,要在表达能力、开发成本和长期维护之间反复取舍;知识治理和持续优化,是还没完全解决的问题。
两场放在一起看,答案是互补的。
如果你的 Agent 还在 "答不准" 阶段,或者正打算把 NL2SQL 的准确率再往上推两个点——先看梁伟第一部分的复盘:把准确率推到接近 100% 之后会遇到什么,比怎么推上去更有价值。
如果你已经有 Agent 在跑,但结果不稳定、说不清依据——直接看钱瀚那场:四层拆分、证据链和把知识缺口沉淀成可版本化资产,是目前比较少见的一套工程做法。
如果你纠结架构选型——梁伟那三次迭代(MCP、领域 Skill、内置 Agent)的取舍清单,基本覆盖了大多数团队会在的两个岔路口。
如果本体还在设计阶段——两场都藏着同一句提醒:没有可照搬的标准,本体是取舍出来的,不是设计出来的。
10 月 23-24 日,DACon 2026 北京站,这两场都在。
 时间:2026年10月23-24日
 地点:北京希尔顿逸林酒店
 报名:点击「阅读原文」或访问
 本体落地企业集中亮相|参会报名火热进行中... ...DACon 2026 北京站,15 个分论坛,60+真实应用案例,2 天沉浸式学习交流,现场还会组织闭门会、晚场圆桌交流,讲师们会围绕具体的技术点进行介绍,旨在丰富大家在参会体验,希望大家不虚此行,满载而归。