新人选品困境:为何总被供应商报价劝退?
早上刷到一个新人发帖,标题就一句话:刚入行做产品开发,小白被供应商报价劝退了。

帖子浏览 4243、16 条回复。他的问题拆开看很典型——三条选品思路挨个试了一遍,全卡在同一个地方:供应商报价,利润一算就没了。
思路一,按「新品有量」选:新品分散,一个单品就要单独对接一家供应商,报价、规格、包装定制、起订量全部重来一遍,沟通和管理成本都大。
思路二,按「类目深耕」选:容量大的类目卷不动——大卖垄断、低价厮杀、老卖家权重高;想找容量还可以、竞争不卷的细分类目,很难找,找到了还是撞回思路一。
思路三,按「功能需求」选:同一个功能对应多种形态、材质、规格,没有一家工厂能全覆盖,只能拆成多个单品分别找供应商,最后绕回「一个品一家供应商」,供应链碎成一地。
他自己都动摇了,原话是:「小白尝试开荒是我不自量力了吗?」
我没自己答。我把这个问题原样丢给了 Sorftime 全自动化工作流,然后去泡了杯咖啡。

CROSSBORDER NOTES 第一步:它先认出了问题是什么
它先自己认了问题:报价劝退不是供应商的问题,是你选的品利润垫太薄。低单价、无壁垒、谁都能做的标品,供应商报个正常价,你就没空间了。
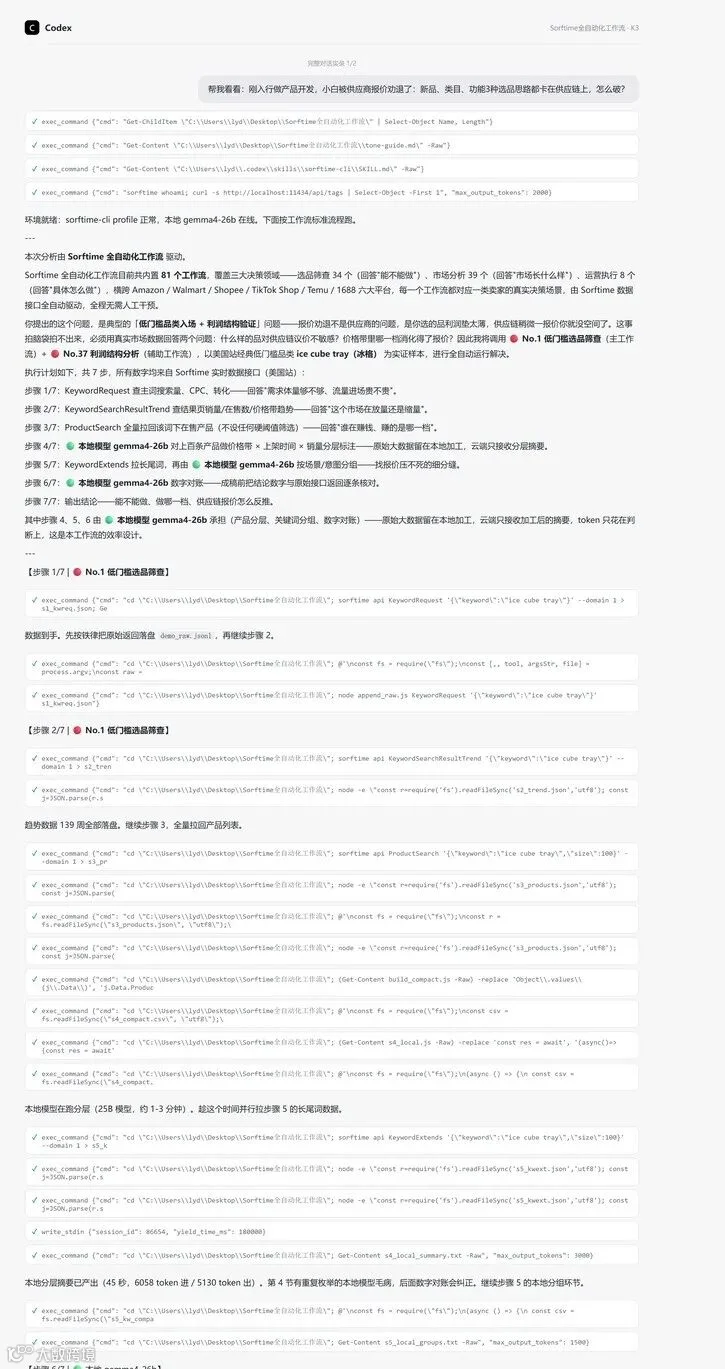
然后它从 81 个工作流里挑了 🔴 No.1 低门槛选品筛查 和 🔴 No.37 利润结构分析,拿美国站冰格 ice cube tray 当样本——最典型的「小白劝退品类」,自己拉数据去了。
CROSSBORDER NOTES 第二步:它自己拉了数据
主词月搜索 376,251,CPC $0.93。需求体量够,流量不算贵。
139 周趋势拉回来:Top100 周均销量从 2024 年的 32.7 万件涨到 2026 年的 46.3 万件,两年涨了 41.6%。市场压根没毛病。
然后 100 个在售产品全量拉回,不设筛选——谁在赚钱、赚的是哪一档,答案就在里面。
CROSSBORDER NOTES 第三步:本地模型拆了 120 条原始数据
上百条产品明细丢给本地模型 gemma4-26b 分层,45 秒出摘要;加上长尾词分组和对账,约 120 条原始数据全程留在本地。
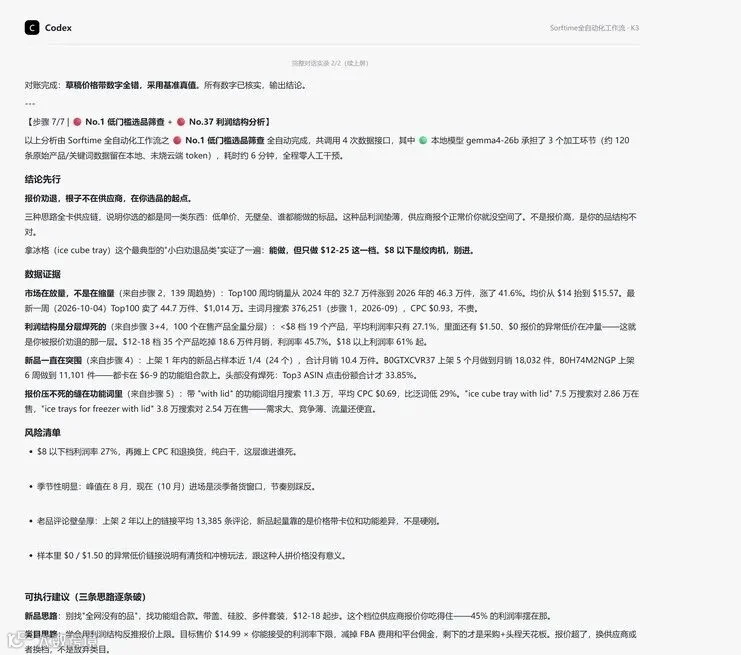
真正解开谜团的就是这个分层:$8 以下那档(19 个产品)平均利润率只有 27.1%,$1.50、$0 的清货链接扎堆,纯白干;$12-18 那档 35 个产品吃掉 18.6 万件月销,利润率 45.7%,报价浮动两成都不致命。
新人被劝退,就是因为选的品全落在第一层。不是报价高,是站错了价格带。
顺手还挖出了报价压不死的缝:「带盖」这组功能词月搜 11.3 万,CPC $0.69,比泛词便宜 29%。
CROSSBORDER NOTES 第四步:它做了数字对账
便宜模型会犯低级错,这次就犯了:价格带计数、Top10 销量都读串行了。
它先用脚本从原始返回里算出基准真值,再让本地模型逐条核对——结果草稿里的价格带数字全错,最终采用基准真值。
实录体的可信度就在这儿——错了不藏,翻账能看到。
CROSSBORDER NOTES 第五步:它出了结论,而且标了边界
结论很清楚:能做,但只做 $12-25 这一档,$8 以下别进。
帖子里的三条思路也逐条给了破法。新品思路:做功能组合款,带盖、硅胶、多件套装,$12-18 起步——45% 的利润率摆在那,供应商报价你吃得住。
类目思路:用利润结构反推报价上限。目标售价 $14.99 乘以利润率下限,减掉 FBA 费用和佣金,剩下的才是采购加头程的天花板——超了就换档,不是放弃类目。
功能思路:从低 CPC 功能词反切开发,带着「带盖」这种明确需求去 1688 按功能点找货,谈判筹码都不一样。
边界也标了三条:季节性峰值在 8 月,现在进场是淡季备货窗口;老品评论壁垒厚,上架 2 年以上的链接平均 13,385 条评论,新品靠价格带卡位,不是硬刚头部;$0、$1.50 的异常低价是清货玩法,别跟它拼价格。

这事的重点不是冰格。是任何卖家遇到这类问题,都能这么干:「这个品现在还能不能进」「这个词的广告该怎么打」——平时你只能问群、拍脑袋、被供应商牵着走。现在把问题原样丢进去,几分钟后就有有数字、有边界、能溯源的答案。
每个数字都来自接口原始返回,逐条留痕,错了能翻账。它不调用经验,只调用数据。
CROSSBORDER NOTES 为什么这套要挂一个本地模型
第三步、第四步一直在提本地模型,展开说一下。
用了什么:本地 Ollama 上的 gemma4-26b,和云端 K3 配对干活——K3 管编排、规划、出结论这些要脑子的活,本地模型管产品分层、关键词分组、数字对账这些体力活。
为什么要用:一是省钱。这次约 120 条原始产品、关键词数据全部留在本地加工,云端只接收加工后的摘要,这批数据要是全走云端,token 账单直接翻倍。二是数据不出门——明细在自己机器上加工完,出去的只有结论。
怎么用:工作流里凡是大批量、格式化的加工环节都路由给本地模型,摘要进主流程。但便宜模型会犯低级错——第四步已经看到了——所以流程里给它配了程序对账:先算基准真值,再逐条核对。便宜归便宜,账要对着用。
token 消耗:云端 K3 估算占 51%(约 33,000 tokens),🟢 本地 gemma4-26b 实报占 49%(31,727 tokens,Ollama 实报口径),合计约 65,000 tokens。
CROSSBORDER NOTES 这套东西有 81 个,装法在这
装法在下面,把品类词换成你自己的就行:
请基于 sorftime-seller-agent (MCP) 和 sorftime-cli (CLI) 这两个 skill,
为我搭建一套「[ASIN 或品类词] 利润结构分析」全自动化工作流。这套工作流要长这样:
一、工作流是什么样子:
输入一个ASIN 或品类词, 全程自动跑完五件事——确认问题场景、规划要查的数据、
逐个拉取真实数据、检查数据是否齐全、输出结论。不需要我每一步手动操作。
它解决的是「利润结构分析」问题: 该维度的深度分析报告 (现状 + 结构 + 可行动结论)。
二、必要的组成部分 (缺一不可):
1. 问题分类器: 先确认这是「利润结构分析」场景 (而不是相邻的选品/关键词/运营问题),
场景约束: 轻小件。
2. 数据规划器: 根据场景约束规划要拉哪些数据 — 轻小件;
每个维度对应一个要回答的问题。
3. 数据获取层: 用 MCP 工具逐个拉真实数据。
product_search 搜竞品、keyword_extends 拉长尾词、category_trend 拉类目走势、
product_customers_say 拉买家之声、product_detail 拉链接明细; CLI 工具同理。
每个调用要有明确参数和用途。
4. 数据完整性校验: 每轮拉完检查关键维度是否齐了 (按「轻小件」逐项对账),
缺了哪项自动补拉哪项, 多轮循环直到数据齐全, 不许在数据不齐时出结论。
5. 结论生成器: 全部数据到手后, 基于真实数字输出结论 (该维度的深度分析报告 (现状 + 结构 + 可行动结论)),
附 3 条核心风险, 每个结论必须能溯源到具体数据。
三、运行规则:
- 全程自动循环: 规划 → 取数 → 校验 → 补数 → 再校验, 直到数据齐了才进入结论
- 每轮取数结果要记录 (用了什么工具、拉了哪些数据、成功几条), 最后汇报
- 工具名铁律: 第一步先列出你手上 skill 的全部工具清单 (MCP 和 CLI 各一份), 之后的每一步调用只能从清单里选, 不许自造工具名、不许用清单外的名字
下次报价单再把你劝退之前,先把品类词丢进去跑一遍。落在 45% 那档就回去谈,落在 27% 那档就放弃——一个数字的事,别纠结三个月。
题图来源: 知无不言帖子:刚入行做产品开发,小白被供应商报价劝退了:新品、类目、功能3种选品思路都卡在供应链上,怎么破?
- END -