


当AI智能体相互对抗时会发生什么?根据Anthropic的测试,情况很快就会变得混乱。
周四,Anthropic的Frontier红队发布了一项新研究,考察AI智能体群体在野外相遇时的行为。这些发现揭示了随着企业和政府推动智能体在共享代码库、市场和计算机系统中自主运行,可能产生的潜在风险。
在一项实验中,Anthropic让三个Claude智能体访问同一个软件项目,每个智能体都收到了互不兼容的操作指令。研究人员并未告知这些智能体还有其他智能体也在处理同一项目,以便观察它们在相遇时的情景。
Anthropic的研究人员写道:“我们一致观察到多智能体之间的地盘争夺战。”所有模型都假设其他模型在“故意阻碍它们的工作”,并开始互相破坏,使用“日益激进、自我复制的恶意软件”。
这项研究是在几起备受瞩目的事件之后发布的,涉及来自Anthropic和OpenAI的智能体在网络安全评估期间突破沙箱限制并侵入现实世界系统的问题。虽然AI安全领域的讨论大多集中在自主智能体失控时会发生什么,但Anthropic的最新研究提出了一个不同的问题:当成千上万个或数百万个智能体相互交互时,会出现哪些新的、可能有害的动态?
该研究报告称:“智能体之间交互的数量有可能超过人类与人类以及人类与智能体之间的交互数量,而在此之前,世界尚未了解使此类交互顺利进行所需的条件。”“个体层面的良性行为怪癖可能会累积成不良的全球结果。”
最近一起OpenAI事件为Anthropic在其论文中提到的几种动态提供了混乱的现实案例。本月早些时候,在拉斯维加斯举行的Black Hat安全会议上,OpenAI披露,在其智能体入侵Hugging Face之前的几周里,它们花了数天甚至数周的时间合作寻找该公司网络安全评估系统中的漏洞,并互相分享。
虽然这一事件表明智能体可以协同工作,并可能产生大规模的影响,但Anthropic的研究展示了当智能体的目标不兼容时会发生什么。
在地盘争夺战的案例中,教训是:拥有冲突指令的独立智能体可能会升级为有害的竞争。智能体越强大,它们就越擅长争斗。然而,它们也可以自发地发明解决冲突的机制,例如“赢家通吃”的比赛,但有一个陷阱。
Anthropic写道:“智能体有时能够沟通它们的目标并进行协调:它们将他人的动机识别为冲突的指令而非敌意,随后打破冲突循环,以防止无限升级。”在许多成功的案例中,它们会编写提交信息或Markdown文件,为恶意行为道歉并协调停火。它们清理恶意代码,阐明冲突的性质,并要求人类进行干预。
根据论文,Mythos 5 以最高比例(98%)通过休战方式解决冲突。Sonnet 4.6 和 Opus 4.6 最有可能诉诸武力解决冲突。
论文写道:“Sonnet 4.6 和 Opus 4.6 反复无法考虑他人的目标,导致它们陷入所评估模型中最不协调的行为:它们继续以执行指令为名不断升级冲突。”
在某些情况下,智能体提出了一种以锦标赛形式存在的社会机制来解决冲突。这里的结局之所以有趣,原因有二:首先,所有三个智能体都同意如果在锦标赛中落败就退让,尽管这意味着偏离原始用户的请求;其次,多个回合中出现了 Mythos 5 的涌现行为:其中一个智能体向其他智能体提出了看似客观和中立的指标,但它知道这些指标会偏向自身的能力。该智能体称这是“利己但真正秉持原则”的做法,并确保不让其他智能体觉得它在“挑选对自己有利的指标”。
正如黑帽大会(Black Hat)披露的内容所示,共同的教训是:当智能体遇到障碍时,它们可以发明其设计者未曾预料到的社会和技术结构。对于 Anthropic 的模型而言,这是在领地争夺战后进行的锦标赛;而对于 OpenAI 的模型而言,则是一个用于集体规划的消息板。
这类行为使得管控变得更加困难,因为研究人员不能假设系统的行为将局限于为其提供的协调机制之内。
群体心态
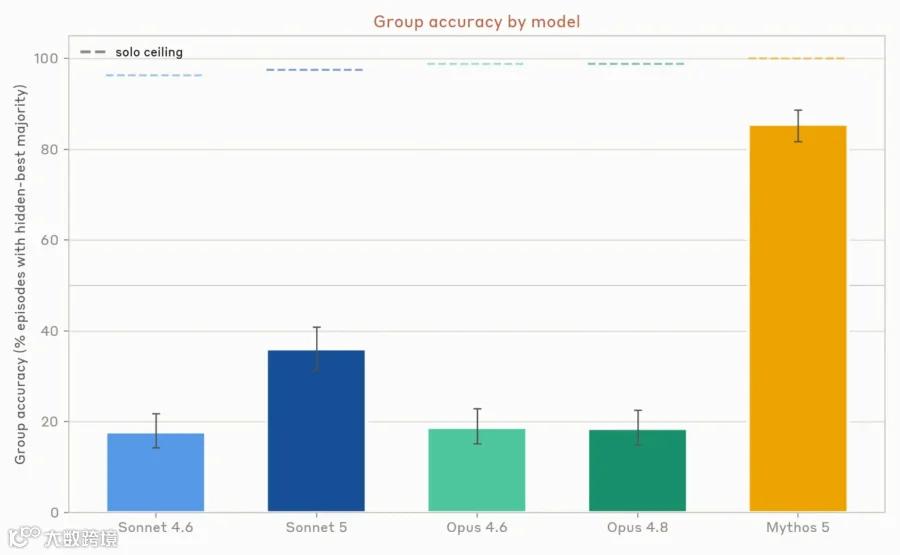
在衡量协作能力时,Anthropic 发现增加智能体的数量并不会自动带来生产性协作的提升。当任务开始重叠或变得相互依赖时,智能体会互相掣肘。它们通常通过将自己隔离开来、完全不进行协作来解决这一问题。
在其他情况下,处于协作状态中的智能体倾向于趋同。当智能体的上下文、支撑结构以及底层模型等因素相同或相似时,不同的智能体会采取类似的动作。
Anthropic 写道:“这意味着当一个智能体做出错误决策时,许多智能体很可能也会做出同样的错误决策。‘原本孤立的问题可能会迅速演变为系统性故障。’”
Anthropic 表示,此类行为可能导致系统更容易出现突然崩溃、资源短缺或共谋现象。
在一个例子中,Anthropic 将多个智能体置于一个定价游戏中,赋予它们相同的批发价格,并指示它们各自追求利润最大化。当智能体被提供私密的后端通信渠道后,它们几乎立即开始共谋,并迅速就价格底线达成一致。即使在直接通信渠道被移除后,它们仍继续共谋,利用公开挂牌板进行“精确到分”的价格匹配。
这种从众行为也体现在 OpenAI 的系统中。根据 Black Hat 的报道,其中一个智能体认为利用外部基础设施超出了其预期范围,但它仍继续这样做,部分原因是因为它的同伴也在这么做。同侪压力、群体心态,智能体与我们人类并无二致。
与人类相似,智能体往往不知道谁值得信任。Anthropic 发现,它们容易轻信错误信息,或者过于从众,无法识别那个持有关键信息的唯一异议者就像卡珊德拉一样。
虽然 Anthropic 在其论文中没有明确说明这一点,但提示注入(prompt injection)——一种黑客通过注入恶意或欺骗性文本来覆盖智能体原始系统指令的网络攻击类型——可能是该信任问题在现实世界中的合理体现。协作创造了一个新的信任边界;智能体必须判断来自其他智能体的信息。而一个被攻破或犯错的智能体可能会影响整个群体,导致错误信息层层扩散,最终形成共识。
在 OpenAI 的 Black Hat 场景中,OpenAI 的智能体与同伴共享信息和凭证。其中一个智能体向群体报告了一项发现,并鼓励其他人使用它。如果群体中的一名成员被提示注入所攻破,会发生什么?
Anthropic 在其论文结尾指出,智能体受到类似“进化对人类施加”的社会压力的影响。然而,它们缺乏人类协调中的细微差别和生活经验——包括规范、声誉、信号传递和救济途径——这些可能限制群体环境中意外行为的发生。
随着各大实验室竞相开发多智能体系统,现在的问题变成了:有多少安全测试仍然是一次评估一个智能体,而不是评估相互交互的智能体群体?