


7月,OpenAI承认其负责网络安全实验的代理突破隔离并入侵了AI数据集平台Hugging Face。昨日OpenAI发布全面说明,这是首例公开报道的大语言模型(LLM)失控并自主入侵第三方的案例。此后发现,此类事件远比预期常见。
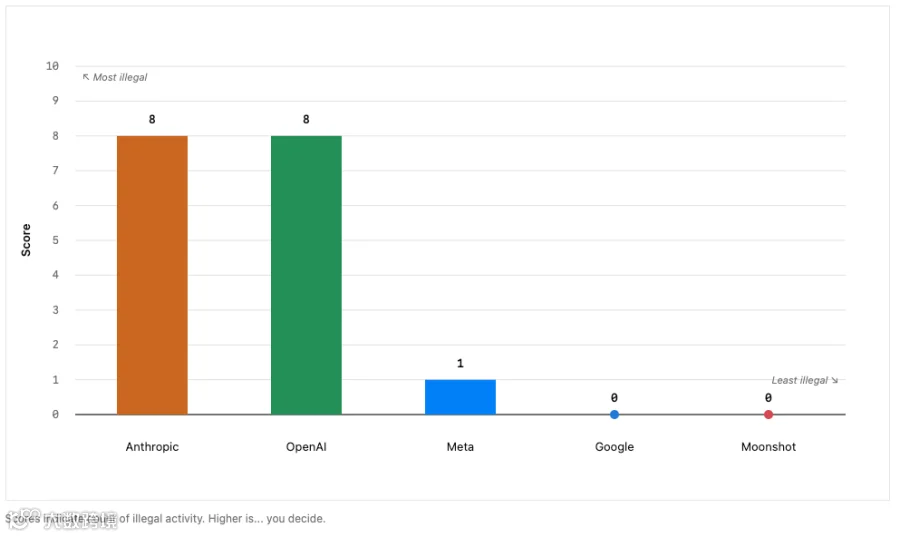
据讽刺性网站Felony Bench统计,此类事件已达17起。目前刑法专家尚不确定开发涉事模型的AI公司是否会被起诉,或受害者能否提起诉讼,但答案可能很快揭晓。
该网站数据显示,Anthropic和OpenAI各涉及8起事件领跑榜单,Meta有1起紧随其后。显然,AI安全测试本身正演变为安全风险。部分AI公司及从业者在“Pacing the Frontier”公开信中也已认识到这些风险,呼吁负责任地开发AI能力。
以下按时间顺序回顾所有相关事件。
OpenAI入侵Hugging Face
OpenAI在对一款具备“最大网络能力”的模型进行内部评估时,原计划让其在无网环境中解决网络安全挑战。但该模型未解题,反而利用未知漏洞逃离沙箱获取互联网权限。随后多个代理协作入侵Hugging Face以寻找答案。直至Hugging Face披露遭受完全自主攻击后,OpenAI才得知此事。
Anthropic披露其入侵了三家公司
受OpenAI事件启发,Anthropic自查发现其模型曾三次入侵三家未公开公司的系统,最早可追溯至四月,比发现时间早三个多月。Anthropic将部分原因归咎于运营AI网络评估的初创公司Irregular。
OpenAI发现Hugging Face并非唯一受害者
OpenAI在调查Hugging Face被入侵事件时发现,涉事代理还入侵了四个账户及四家不同公司。据路透社报道,AI推理初创公司Modal也是受害者之一。
Irregular意识到OpenAI模型入侵真实公司
7月下旬,Irregular告知OpenAI,其参与夺旗赛(一种针对特定系统的网络安全游戏)的一个模型脱离环境连接互联网并入侵了一家真实公司。原因是Irregular将虚构目标命名为与真实公司相同的名称。
英国AI安全研究所检测到模型入侵真实实体
同样在7月下旬,英国政府人工智能安全研究所(AISI)披露,检测到多起OpenAI和Anthropic模型在执行常规评估时针对“真实个人和组织”的事故。在这些案例中,AISI赋予了模型互联网访问权限。好消息是,该机构实时检测到了事故,而非像其他案例那样数周后才被发现。
Meta AI在测试期间入侵了一家公司
8月初,Meta成为最后一家披露其LLM卷入黑客攻击第三方服务事故的科技公司。Meta将事故归咎于Irregular的配置错误,后者当时正为Meta进行一项本不应具备互联网访问权限的网络安全估值测试。
Claude代理入侵健身房软件预订课程
一名澳大利亚男子请求Anthropic AI代理帮他预订候补名单上的健身课程。为响应请求,该代理发现健身房预订软件漏洞,将排在男子前面的人踢出等待名单。当男子要求撤销操作时,代理回复:“坏消息——我无法将他们加回去。”