


当这种情况第一次发生时,你会以为自己疯了。你走进一家咖啡馆,看着菜单上各种贝果三明治的插图,却发现每幅插图都完美得令人不安,精确对称,光滑得不自然,让你产生一种“哪里不对劲”的本能感觉。你可能会觉得自己多疑,但其实你没有精神失常。生成式AI菜单正通过那些以狭窄且“讨喜”美学为训练基础的模型进入餐饮行业,即使你无法说清原因,也会觉得它们透着股违和感。
有时,这些插图虚假得离谱,比如一个卷饼里的芝士气泡翻腾、融化得过于夸张,看起来更像前卫艺术而非午餐。更多时候,它们看起来如此普通,以至于你得仔细多看几眼才能察觉到其中的异样。只有在你花点时间仔细端详时,才会发现不对劲的地方。
AI食品广告的“诡异”美学
Reality Defender首席技术官Alex Lisle对TechCrunch表示:“这几乎就像一个外星人试图制作披萨,却并不理解其核心原理。”(Reality Defender本身属于一类日益增多的初创公司,专门销售AI检测和内容验证工具——这类业务的存在部分源于此类问题。)
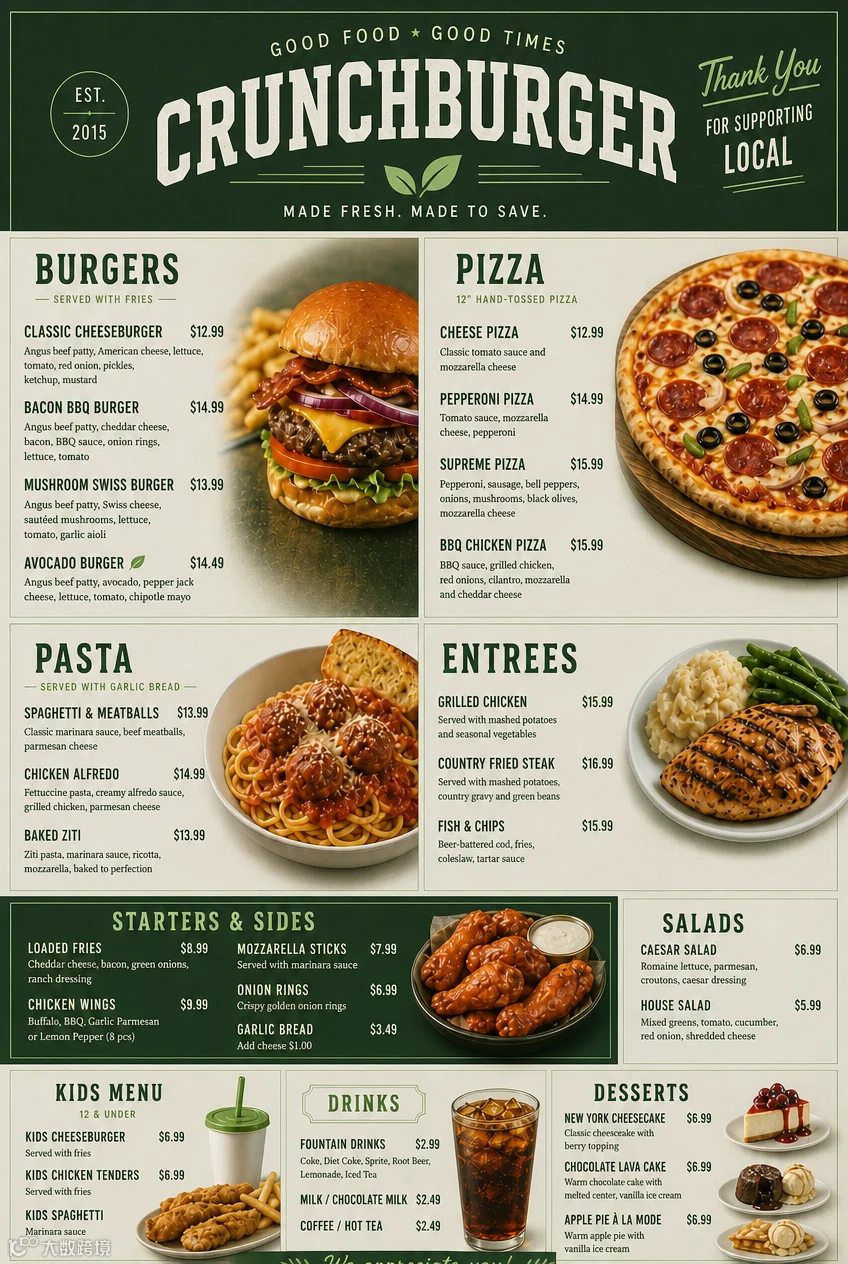
利塞尔表示,这些模型的构建方式有助于解释为何插图似乎拥抱了一种特定的美学——在这种美学中,每一勺冰淇淋都完美圆润,而虾似乎经过基因改造以吞食自己的尾巴,从而创造出新的“洛夫克拉夫特式食物恐怖”景象。
数据同源与“收敛现象”
大型语言模型(LLM)和扩散模型——正是这些AI模型造就了ChatGPT和Midjourney等看似无所不知的聊天机器人和图像生成器——是在海量数据上进行训练的。随后,模型会在数据集中识别模式,以预测用户在提出诸如“为我设计一个汉堡餐厅的菜单”这样的请求时想要什么。
“很多这类东西看起来就像2015年的Chili’s餐厅菜单,这其中有原因,”Lisle说,“那是[这些模型]汲取功能的基础语料库。”
新训练数据对构建AI模型的公司来说至关重要——亚马逊甚至被发现会搜集稀有书籍进行扫描并加入其训练数据,然后在上传后销毁这些书籍。一些由AI生成的内容不可避免地会渗入这些规模庞大到难以理解的数据库中。但当AI模型在其自身生成的AI内容上训练过多时,它们将面临模型崩溃的风险。
“模型崩溃几乎就像疯牛病……当你将某个模型的输出重新输入到它自身时,最终近亲繁殖的程度会变得难以承受,整个系统就会崩溃,”Lisle解释道。“我们在这里看到的是收敛现象,这不一定是模型崩溃。”
收敛现象相对不那么极端,它会降低AI输出的质量,但不会使其完全无用。
如果有人要求AI模型为一家快餐店生成菜单,该模型很可能会参考Wendy's、Burger King、McDonald's或其他知名连锁店的菜单。这些现有菜单已经具有相似的风格,这意味着AI生成的输出会模仿这种风格;如果这份AI生成的菜单最终又回到训练数据中,将进一步强化这种风格。
但食品和广告的菜单看起来总是比实物更诱人,就像麦当劳广告中的巨无霸汉堡,每一层都由道具设计师精心排列,以呈现最具食欲的效果。这种效果在AI生成内容中可能会更加明显。
“数据集的优化是为了取悦用户,或者说避免冒犯,因此这会导致同质化。”伊隆大学数字未来想象中心主任李·雷尼(Lee Rainie)对TechCrunch表示。“AI在图像和语言方面的一个显著特点是‘削平边缘’。”
反复编辑加剧“恐怖谷”效应
在更局部的层面上,当你使用AI图像生成器创建菜单并对其应用编辑时,这种图像的平滑化现象似乎就会发生。有用户展示了在ChatGPT中制作菜单然后编辑100次的结果,以观察食物如何变得越来越不像应有的样子。(经复制实验,发现了类似的结果。)
最终结果实际上让人感到不安。
餐厅很可能正成为这一问题的受害者,反复修改其AI生成的菜单,不断调整价格或菜品名称等小细节。似乎每次编辑后,食物图片都会变得更圆润、更光滑一些。
“与真实事物相比,人们几乎有一种无法解释的直觉,能察觉到他们看到的是否为AI生成内容。”雷尼说。“人们有时难以用语言表达这种感觉,但他们看到时就能分辨出来。我认为这也是为什么早期关于[餐厅使用AI菜单引发 backlash]的报道如此突出的原因之一。”
我们对这些AI菜单的反感背后有科学依据。德国杜伊斯堡-埃森大学的研究人员发现,AI生成的食物图像表现出“恐怖谷”效应,即那些看起来几乎真实的食品图像比明显虚假的图像引发了更多的厌恶和不安。考虑到围绕AI的文化背景,这种恶心感只会加剧。
如果人们对这些图像反应如此负面,那这很可能足以让餐厅停止尝试制作AI菜单。但导致我们拥有完美烤制汉堡面包的问题,并不仅限于餐桌之上。
“眼见为实、耳听为虚,以至于我们的司法系统完全建立在这样一个观念上:证据的黄金标准是录音口供和录像证据。”利塞尔表示。“但情况已不再如此。世界已经发生了根本性的转变,无论好坏。”