


AI芯片采用多Die架构后,封装、电源管理及软件验证需在流片前协同介入。
受光罩尺寸限制,单片Die难以同时容纳计算、HBM和I/O模块。Synopsys引用IBS预测指出,至2030年,超过半数的7nm及以下新设计将采用Chiplet技术。 Die拆分仅是起步,连线速率、封装工艺、供电与热设计必须在架构阶段确定。若待版图完成后才处理,返工将严重影响首版硅片的进度与成本。
突破光罩边界:计算、内存与I/O分离布局
过去,先进工艺依赖晶体管微缩提升密度、频率和能效,但单片Die面积存在硬上限,光罩尺寸通常卡在850mm²左右。
AI数据中心加剧了这一瓶颈。计算Die需采用最先进节点,而I/O和内存控制器无需同等昂贵工艺;HBM需紧邻计算单元,网络接口则需预留芯片边缘空间。强行整合于单片芯片会导致面积、良率及设计周期恶化。
Synopsys提出的多Die方案,通过将计算、内存和I/O拆分并在同一封装内组织,可实现相当于2至5倍以上光罩面积的硅片内容,旨在构建万亿晶体管级系统。Chiplet因此成为AI芯片扩展的现实路径。
左侧为受光罩限制的单片芯片,中间为多核Die,右侧展示CPU、I/O、HBM及Die-to-Die互连集成于同一封装。

明确数据速率:Die拆分后的互连考量
Chiplet系统的首要问题并非“接口能跑多快”,而是“哪些数据需要如此高速”。
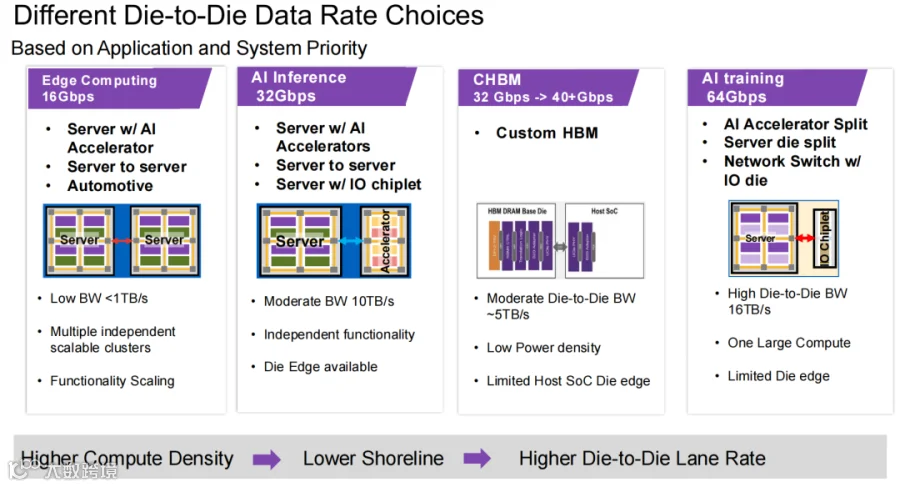
不同应用场景对Die间速率要求各异:边缘计算约为16Gbps级,AI推理常见32Gbps级,定制HBM接口超40Gbps,而训练及大型交换芯片拆分则需达到64Gbps级。速率越高,单位芯片边缘带宽越大,但信号损耗、功耗、封装布线及验证难度也随之增加。
选择背后涉及实际权衡:训练系统需大量计算Die并行交换数据,留给每颗Die的I/O边缘有限;推理系统流量结构不同,无需复制训练芯片的连接方式。Chiplet无法依赖单一接口规格,需先确定系统分工,再定互连速率。
从边缘计算到训练,数据速率逐步提升,芯片边缘空间日益紧张。
封装前置:3D堆叠对架构设计的挑战
有机基板、RDL扇出、硅桥、硅中介层及混合键合等技术,互连密度逐级递增,成本、散热及设计复杂度亦同步上升。
面向面堆叠(F2F)使两颗Die金属层直接相对,互连密度可达每平方毫米百万级,功耗约0.05pJ/bit。面向背堆叠(F2B)主要依赖TSV,密度为每平方毫米万级,功耗约0.1pJ/bit。
F2F虽连接更密、更省电,但要求设计团队早期介入电源网络、热传导、Die朝向及物理实现。在传统2D设计中,封装处于后端;而在3D设计中,封装反向决定模块布局及连接可行性。
F2F在连接密度和单位互连功耗上更具优势,但从2D迁移需大幅调整设计流程。

功耗博弈:互连能耗随带宽激增
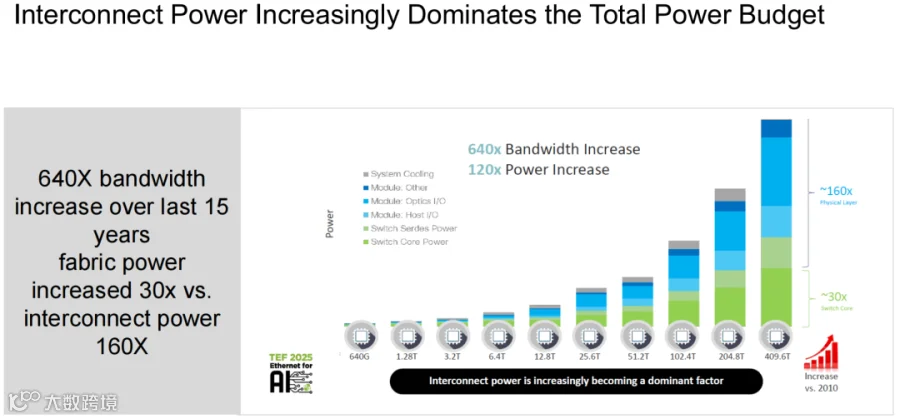
Synopsys引用Cisco数据显示,过去15年间,互连带宽增长640倍,Fabric功耗增长约30倍,而互连功耗增长约160倍。随着算力向机柜集中,数据搬运能耗占比显著提升。
带宽、Fabric功耗与互连功耗增速不一,互连已成为总功耗中增长最快的部分。
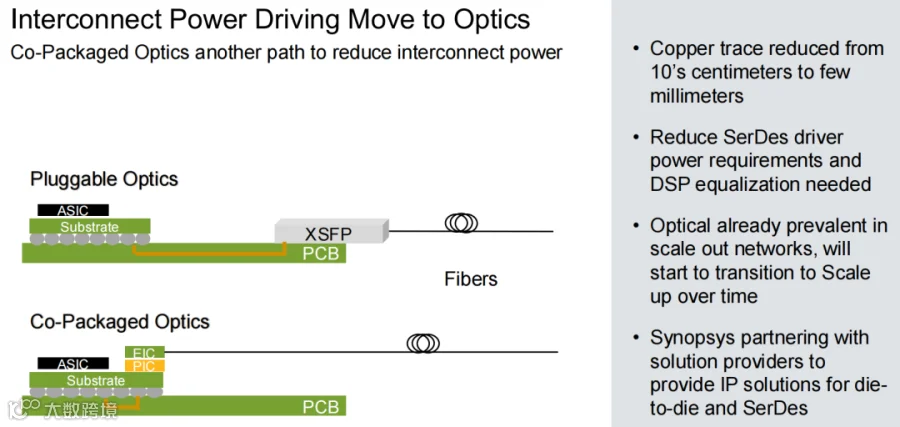
传统可插拔光模块通过PCB和基板传输电信号至前面板转换,铜路径长达数十厘米。共封装光学(CPO)将电子芯片(EIC)与光子芯片(PIC)置于同一封装附近,铜走线缩短至几毫米,降低SerDes驱动和DSP均衡负担。
光互连在Scale-out网络中已成熟,但在Scale-up领域仍面临光源、封装、测试、良率及维护等挑战,并非简单地将光引擎靠近ASIC即可解决。
CPO将铜路径从数十厘米缩短至几毫米,光电转换更靠近ASIC,减轻高速电连接负担。
结语:封装决定AI芯片扩展上限
Chiplet并未简化AI芯片设计,而是将架构、版图、封装、供电及软件团队的约束整合。Die拆分越细,首版硅片成功与否越取决于流片前对上述问题的厘清。随着AI芯片规模扩大,封装不再是最后工序,而是决定系统扩展方向的关键前置环节。