


OpenAI 把 GPT-6.1 Sol 放出来,官方话说能力接近 Astra、价格只有五分之一。我第一反应是:吹的吧?差五倍的钱,分数得掉多少?这篇把账算清楚——你省下的钱,到底对应多少分差距,哪些活值得多花那笔。
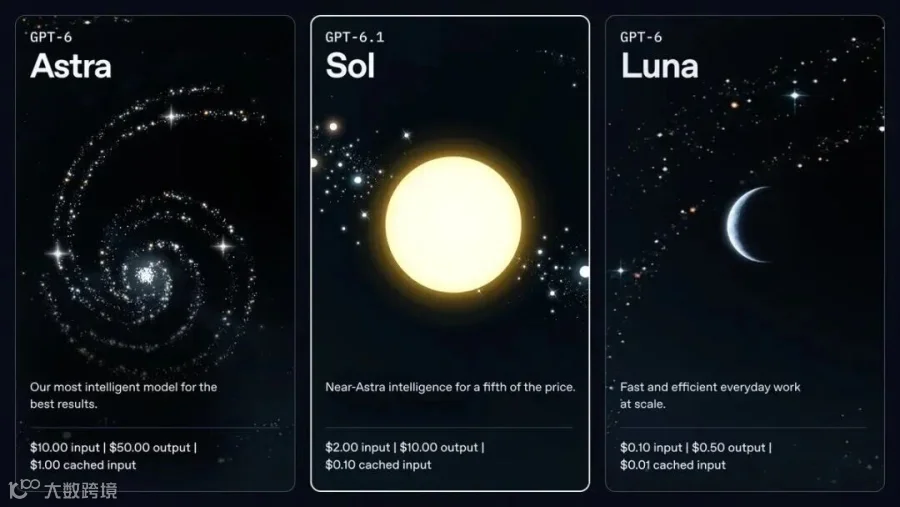
两款都有多个推理档位,比能力先统一看 max,再单独拆新 Sol 的五档表现。
01
价格差五倍,账单也有实证
先摆价。Standard API、输入不超过27.2万 token 时,单位是美元每百万 token:

普通输入输出差五倍,缓存读取差十倍。举个实在例子:一次请求 10万普通输入、2万输出,Sol 花 0.40 美元,Astra 花 2.00 美元。这还没算模型自己生成多少推理 token、调几次工具,那会继续叠账单。
输入超过 27.2万 token,整次请求的输入和缓存费率翻倍、输出变 1.5 倍。Fast 费率是 Standard 的两倍,Batch、Flex 是它的一半。这些 API 费率跟 Codex 订阅额度分开算,订阅里还能跑多少任务,得看产品里显示的实时额度。
独立机构 Artificial Analysis(简称 AA)的 max 测评给了另一组数:Sol 综合 51.83,Astra 52.67;加权任务成本分别 0.72、3.26 美元。这组任务里 Sol 成本约 Astra 的 22%,总分只差 0.84。AA 在 221 个可比配置里把 Sol 排第 10、Astra 排第 7。
02
同样开 max,哪些项目拉开了差距
AA 当前综合指数 v4.3.2,由 10 项评测组成,下面另补了科研终端和视觉推理。所有百分比都是各自测试内的,Elo 也只在同一行里比:

Astra 的优势集中在连续操作:终端、科研、软件工作流。Sol 在 GDPval 的 1575 高于 Astra 的 1542,AA-LCR 的 83.0% 也高于 80.7%——整理文档、啃长材料时,Sol 完全够用。Briefcase 那几分 Elo 重叠,不足以单独定夺。
拿 Terminal-Bench 4.0 说,AA 用同一个 mini-swe-agent 环境,66 个任务各跑三次。Sol 56.1%、Astra 59.1%;每题费用分别是 1.82 美元、8.50 美元。这差价足够让常规开发先试 Sol,再用本项目的测试结果决定要不要升级。
03
LiveBench 也测到了新 Sol
LiveBench 当前下载表用 2026-06-25 题集,已加入新 Sol。按网站七类均值再平均复算,Astra max 82.16 分、第 4,Sol max 81.62 分、第 6:
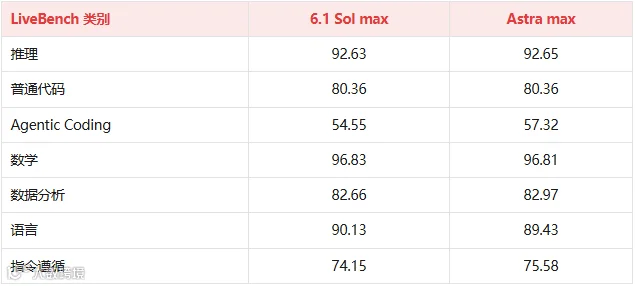
两者普通代码都是 80.36,Agentic Coding 是 54.55 对 57.32。结合 AA 的终端测试,Astra 在要持续动手的代码任务上仍占优;光看补全生成代码,差距很小。LiveBench 还收了 Sol xhigh:综合 81.11,但 Agentic Coding 56.77 比 max 的 54.55 还高。
04
Arena、Vals、ARC 这些榜怎么看
新 Sol 刚发布,各榜收录进度不一,下面是目前能核对到的:

Arena 两张榜测的不同,第 2 和第 26 不矛盾:前者比网页开发作品,后者比用户对文本回答的偏好,都还缺新 Sol 直接对照。Vals 要认版本,v2.1 的 63.13% 才是当前可比的,榜里 GPT-6 Sol 是上一代。
DeepSWE 独立榜 9月22日还没新 Sol;OpenAI 在新 Sol 发布文里说它在 DeepSWE 1.1 比旧 Sol 高 6.4 个百分点、约五分之一成本接近 Astra——那是发布方测评,分开读。

ARC-AGI-3 看运行环境:Astra 在 Standard harness 下最佳 62.7%(max),换保留推理状态、支持长对话压缩的 Provider Adapter 后最佳 99.9%(high),引这张榜必须带框架。OSWorld、SWE-bench 目前没有可直接比的新 Sol 成绩。
05
6.1 Sol 究竟用哪档推理
官方 API 支持 low、medium、high、xhigh、max,默认 medium,不收 none 或 minimal。下面是 AA 同一版本指数的结果,费用是那套评测的加权平均每任务成本:

high 当日常起点。比 medium 综合多约 2.45 分、成本多约 49%——理解项目、改代码、查文档我接受这预算;纯改格式文案、提取明确字段,先 medium,特别简单的降到 low。
复杂代码从 xhigh 起。high 到 xhigh,终端通过率 51.5% 升到 54.0%,成本多约 23%。涉及多文件、疑难排错、多步工具操作,这个档位值得先试。
xhigh 升 max,综合只多约 0.80 分、成本多约 84%,两次升档增量接近、后一次贵得多,留给已经明确卡住的任务。
时间也得算。AA 按输出 token 和生成速度估,high、xhigh、max 加权每任务生成约 3.45、4.67、9.11 分钟,这指标不含首 token 等待和工具开销,日常总等待会另有差异。
如果 Sol xhigh 连续卡在同一处,先看失败原因:缺文件、权限或测试环境就补齐;题目清楚、材料齐全却推不动,再比 Sol max 和 Astra。AA 科研终端测评里 Astra max 领先新 Sol 约 5.2 个百分点,遇困难科研流程我会更早切 Astra。
最后提醒一句:推理档位和速度模式是两件事。选 high 还是 xhigh 决定模型投多少推理预算;Standard、Fast、Ultrafast 是速度与计费模式。新 Sol 的 Ultrafast 发布时还说随后开放,当前入口以产品为准。
想 get 互通行业一手资讯、交流踩坑经验,免费领取【2026 大模型全套资料】+【AI 全套学习资源】👇
图片/素材来源于网络,其版权归原作者所有,侵删
⭐“点赞、分享、推荐”三连↓