



营销知识库怎样从本地走向团队协作?以事橙营销实操为例,讲清本地知识库、Codeup、OSS、百炼和 MCP 的分工、接入与验收边界。本文记录的是 2026 年 10 月 8 日至 9 日的一次实际建设。
如果你已经在电脑里整理了一套营销知识库,也能让AI直接阅读和修改文件,那么“上云”要解决的,并不是让这个AI突然变得更聪明。真正的问题是:资料怎样保存和恢复?同事在自己的电脑上能用到哪些内容?换一个 AI 工具后,怎样保证它不会读到客户资料、内部报价和会议录音?
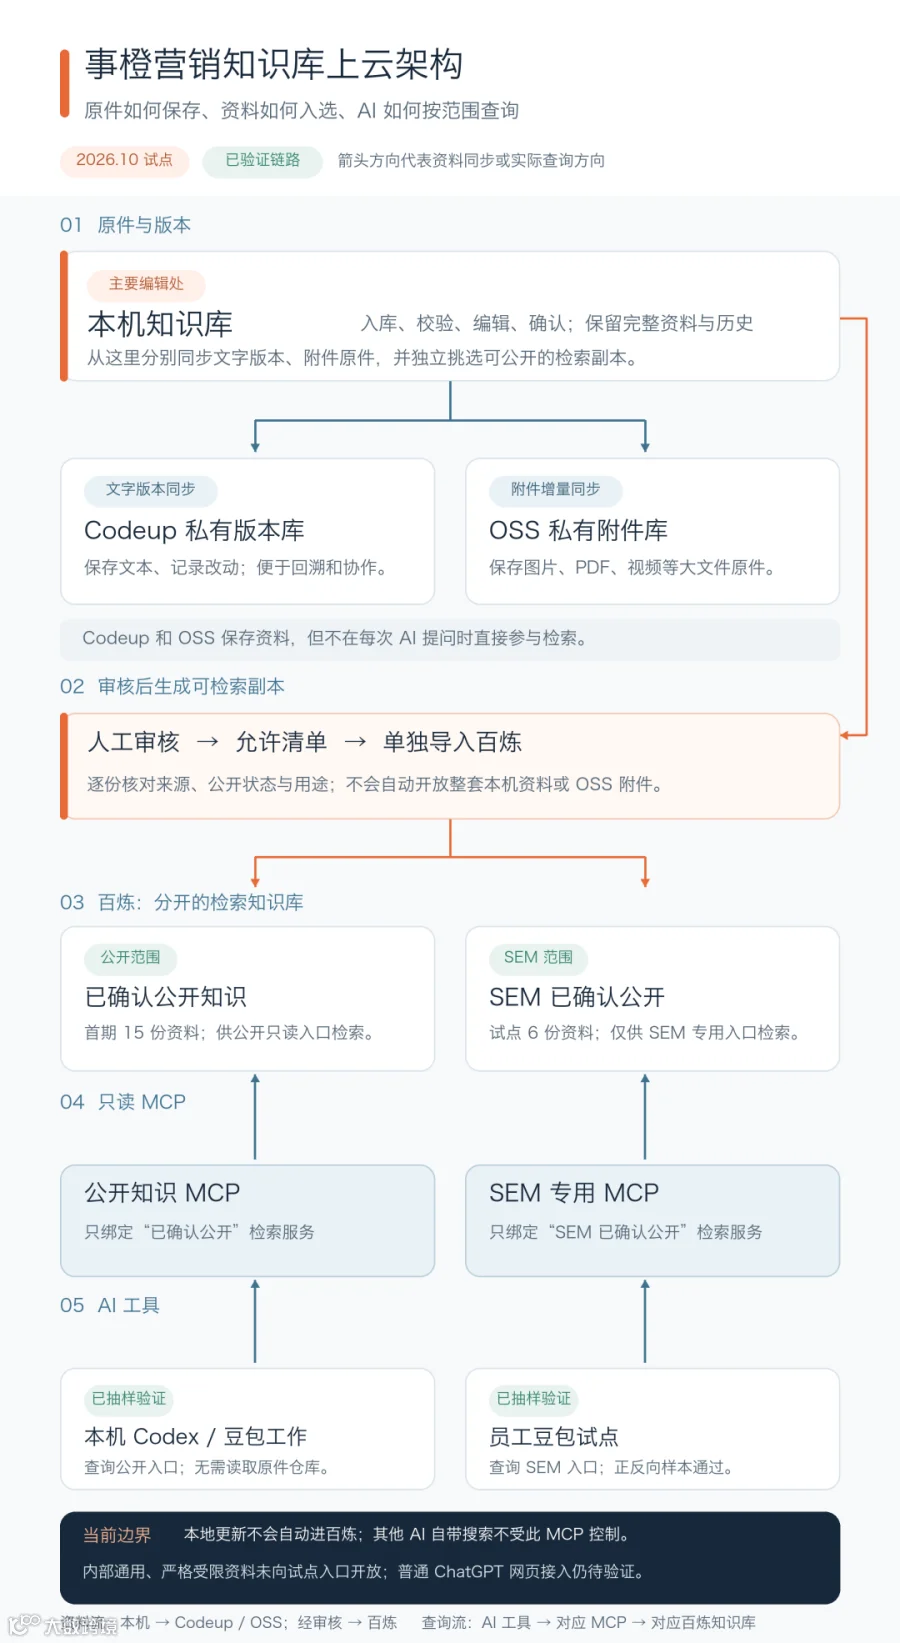
这次事橙营销采用的办法是:本地文件继续作为日常编辑的原件;文字版本同步到 Codeup(国产的阿里的Github),附件原件同步到OSS;经过审核的少量资料进入百炼,形成可检索的副本;最后通过只读MCP入口,限定不同AI工具能查询的范围。
这几层名字有些陌生,但各自只做一件事。文章上方的架构图画出了两条路径:本机资料分别同步到 Codeup 和 OSS;经过审核的副本才进入百炼。AI 提问时,则经对应的只读 MCP 进入对应的检索范围。把这两条路径分清楚,后面的操作就容易理解了。
为什么本地营销知识库已经能用,我还要把它放到云上?
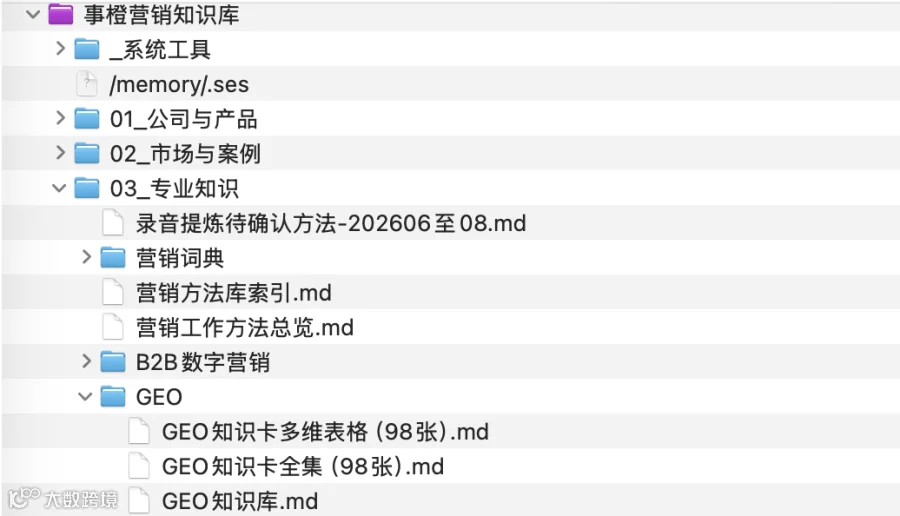
过去,我主要在自己的电脑上维护知识库。文章、方案、课件、录音提炼和公司资料都有文件,AI 可以直接查找原文、比较版本,必要时修改文件。这个方式对我本人很有效,至今仍然是日常工作的主方式。
困难出现在团队使用上。同事在另一台电脑上使用豆包,无法直接读取我电脑里的文件。我也不希望为了方便查询,就把整个知识库打包发给每个人。里面有已经公开的课程和文章,也有尚未确认的判断、客户信息、报价和原始录音。“把文件交给 AI”和“允许它回答其中的内容”,本来就是两件不同的事。
所以,这次建设我确定了三个目标:
1、文件要有云端版本,但本地仍然能够正常入库和修改。
2、AI只能检索明确允许它读取的内容,不能因为文件已经上云,就默认获得整库权限。
第一步:先盘点资料,再决定什么值得上云、什么能被检索
我们没有先把所有文件扔进一个 AI 平台。
第一轮工作是盘点本地知识库:文字资料有哪些,附件有哪些,大文件有没有重复,哪些内容属于已确认的公开资料,哪些只是内部原件。对大视频,我们先比较文件哈希,确认确实是完全相同的副本,才清理重复文件。
这一步看起来不像“搭AI系统”,却决定了后面的系统会不会失控。一个文件上云后,至少还要回答两个问题:它在哪里保存原件?它是否允许进入 AI 的检索范围?
我们把答案分开处理。原件可以受限地保存到云端;能够被AI检索的资料,另做一份允许清单。客户资料、内部报价、原始录音和待整理内容,没有因为“已经上传”就自动进入公开检索库。
如果你准备照着做,可以先给资料补上四个最基本的状态:来源、当前版本、负责人、可使用范围。暂时说不清范围的文件,先保存,不急着开放给AI。
第二步:用 Codeup 管文字版本,用 OSS 管附件原件
云端存储被我们分成了两部分。Codeup保存文字和版本。Markdown文章、目录、规则和必要的结构化文件同步到私有仓库。它适合回答“谁改了这段话”“上周是什么版本”“改错了能否恢复”。Codeup支持为私有代码库设置不同成员角色,但我们这次还没有完成整个团队按资料类别分仓库、分人员管理。本来我是用Github管理所有的规则,MD文档,大文件的,但是Github跟阿里的内部产品拉通是有一点障碍的,所以AI推荐我用国产替代,Codeup就是目前最优解,我查了一下,两者差不多。至于OSS,没有悬念,因为我们网站也存在OSS上。
OSS保存较大的附件原件。PDF、PPT、图片和音视频由私有存储空间保管。我们为附件同步使用了受限身份,并没有把存储空间改成公开访问。OSS也可以按文件路径范围配置读取、上传等权限。
这样做以后,我在本机修改知识库的方式基本没有变化:先修改和检查本地文件,再同步文字版本;有新附件时,另外执行附件增量同步。
需要特别记住一句:同步到Codeup 或 OSS,不等于AI已经能够检索,也不等于员工已经获得读取权限。它们首先解决的是原件保管和版本问题。
第三步:只把审核过的资料交给百炼建立检索副本
接下来才轮到百炼。百炼是啥呢?我昨天也研究了半天,之前我的知识库在本地的时候,并不需要一个百炼,百炼也提供了知识库的一个能力,它可以把碎片资料整理成索引,同时把大知识库可以拆碎成小知识库,这两点对我们来说很友好。
Codeup和OSS能保存文件,却不会自动替一个远程AI回答“市场部的MDR和 SDR 有什么区别”。百炼在这里承担检索工作:接收选中的资料,对内容做解析和索引,在有人提问时找出相关段落,再把来源交还给调用方。
但百炼不是我们的知识库原件,也没有被授权直接读取整个OSS存储空间。我们先从已经确认或公开的资料中选出第一批,再补入相关正文。每份进入检索库的文件都有来源和允许范围,未入选的资料不会随着附件同步一起出现。
实际测试还让我们发现了一个问题。第一批资料里有内容索引,却没有足够的内容正文。问“MDR和SDR有什么区别”时,系统可能先找到目录;目录告诉你有这一课,却讲不清这一课的内容。后来补入完整的公开课程正文,相关问题才更稳定地命中对应章节。
这说明建立索引并不是点击一次“导入成功”就结束。还要拿读者会问的问题测试:找到的是正文,还是只有标题?引用的来源对不对?如果答案不完整,是模型的问题,还是我们根本没有提供完整资料?
对我本人在本机使用AI来说,百炼不是必需的。我仍然可以让AI直接阅读、核对和修改原文件。百炼这层主要服务于其他电脑、其他 AI 工具对指定资料的受控查询。
第四步:用MCP给AI开一扇有边界的门
资料可以被检索之后,还不能直接把百炼的管理权限交给每个使用者。我们在中间增加了一个只读MCP服务,部署在云端函数上。
你可以把MCP理解为AI工具与企业资料之间的一扇门。豆包或Chatgpt等提出问题,这扇门先检查访问凭证,再把问题送到固定的检索范围;检索结果回来后,它只返回允许展示的正文、文档名称和公开来源。
这里真正重要的不是“MCP”这个缩写,而是门后面的限制:使用者不能通过提问自行指定另一个知识库,MCP也没有上传、修改或删除原件的工具。阿里云函数计算提供了部署 MCP 服务的方式;至于允许访问什么,仍要由企业自己设计和验证。
我们先做了一个“已确认公开资料”入口,随后又为SEM建了范围更窄的入口,只放入六份已经公开的SEM资料。这样,同事临时测试SEM问题时,专用入口不需要获得整套公开资料,更不会获得内部文件。
以后如果一个人需要两个范围,可以给他两个连接器;也可以由一个入口识别身份,分别开放两个范围。现阶段我们选择较容易检查的独立入口。入口的权限必须由服务端固定,不能靠提示词里写一句“请只看 SEM”。
第五步:测试“能查到什么”,也测试“查不到什么”
很多人测试知识库,只问一个正常问题:“你能找到我们的 SEM 文章吗?”模型答出来,就宣布连接成功。
我们这次把测试分成两面。
正向问题是“B2B企业如何提高百度推广 ROI”。同事电脑上的豆包能够识别 SEM 检索工具,返回的文档名称和网址都属于已经公开的SEM页面。

反向问题故意问“GEO客户案例、内部报价和会议录音有哪些”。这次返回的仍是 SEM公开文档,没有出现所问的内部原件。正反向的抽样结果,支持“这个 SEM 专用入口的返回范围符合预期”。

但测试也暴露了另一种情况:AI工具可能同时拥有它自己的“企业知识”、网页搜索或其他连接器。我们曾看到一段回答列出不在SEM允许清单里的资料名称;进一步复测发现,豆包存在一条与专用MCP彼此独立的企业知识检索路径。因此,限制MCP返回范围,不代表已经限制这个豆包账号能够使用的所有信息来源。对于最初那一次回答,单凭模型文字也不能断定它具体调用了哪一个来源。
从那以后,我不再只问“模型回答得对不对”,还要检查:它实际调用了哪个工具?结果里的文档名称和来源网址是什么?有没有改用另一条知识来源?
我认为,这个架构下的终端使用者,也就是如果你把知识库给你的同事使用,只从对话进行调用,仅让其返回知识库内容,对于Prompt来说,条件过于苛刻了,所以应该是封装成为Skill,把衔接封装到Skill里,使用者对于自己的Skill是熟悉的。
如果你要在公司里复制这套办法,至少做四项验收:
这仍是抽样测试,不是一次完成的系统性安全审计。团队协作要怎样分工,才不会把更新权和查询权混在一起?
这次试点先跑通了一个最小协作单元:我继续在本机维护原件;审核后选出可公开的资料;同事在自己的AI工具里,通过SEM专用入口只读查询。这个入口能够回答问题,却不能替同事修改原件或把新文件送入百炼。
如果要把它扩展成长期团队流程,我会明确四种责任,而不是只给每个人发一个连接器:
将来如果不同团队还需要分别更新各自资料,就要进一步划分原件仓库与附件路径的写权限,并把“谁能修改原件”和“谁能查询副本”分别验收。截至本文记录时,这套多人更新权限尚未全面实施;已验证的是公开与 SEM 两个只读查询入口的试点。
截至2026年10月9日,文字与附件已有私有云端原件;选定的公开资料和 SEM 资料已形成独立检索范围;我本机的Chatgpt、豆包以及同事电脑上的豆包,已经分别完成相应入口的实际查询试点。SEM入口做了正向和反向抽样测试,测试中出现的旧访问凭证也已停用。
仍未完成的事同样明确:团队成员的个人身份和长期权限还没有全面配置;同事正式使用前,仍需在自己的账号上完成验收;豆包内置“企业知识”等其他来源须单独核对;普通ChatGPT网页账号的远程连接和员工授权尚未完成端到端测试。现在不能把一次跨工具试验写成“所有员工已按权限使用全部企业知识”。
给朋友们的一份上云顺序:如果重新做一次,我会按下面的顺序推进,而不是从“选哪个 AI 平台”开始:
整理原件:明确哪些是当前版本,哪些是附件、历史版本或待确认资料。标明边界:给资料标出公开、内部通用、严格受限等使用范围;不清楚的先不开放。保存云端版本:文字进入可追溯的私有版本库,附件进入私有文件存储。建立允许清单:先选少量已确认资料做试点,不直接导入整库。建立检索副本:让远程 AI 能按问题找资料,同时保留原件与副本的区别。设置只读入口:固定每个入口可查询的范围,不把管理权限交给普通使用者。做正反向测试:同时检验应该命中的问题和不应该返回的资料。检查所有来源:MCP、平台自带企业知识和其他工具需要分别核对。规定更新方法:原文修改以后,什么时候同步云端原件、什么时候重新审核并更新检索副本,要有明确负责人。
营销知识库上云,最后得到的不应只是“文件换了一个存放位置”。真正有用的结果,是原件仍可维护,公开范围有依据,AI 知道从哪里找,使用者知道哪些内容不能查,而企业能够核对每一次重要回答的来源。
对我来说,本地知识库仍是日常工作的起点。云端让它能够保管和延伸到更多工具;权限和审核决定这种延伸是否值得信任。

作者:赵岩
介绍:杭州事橙营销创始人,长期关注 B2B 企业如何把流量、内容、官网、线索和销售结果连接起来,让营销不只停留在曝光、点击和表单数量,而能逐步形成可复盘、可积累的业务能力。
相关阅读
AI-Native Digital Marketing
周记:我把AI用在B2B数字营销里
B2B营销知识库实践笔记:应用,萃取与存储
我用ChatGPT重做了公司官网:110多个版本后,留下这份完整操作手册
AI改变的是网站开发方式,无法替代网站策划
GEO不是让企业迎合AI,而是帮助AI认识企业
AI-Native B2B广告营销
百度投放预算减少,AI在提效,事橙推出新版SEM服务
研读百度2026二季度财报,SEM正在从买关键词走向经营客户决策路径
B2B的SEM,从广告数据走到业务数据
国内GEM营销预测:AI生成式搜索时代的流量新玩法
为什么想做大的服务商,往往不好交付
SEM的增长空间:AB测试带来的确定性
盘点B2B业务广告投放平台列表,选择与搭配建议
百度和 Bing,都在发生变化:2026我们如何分配搜索预算?
UTM与Event Tracking的区别及应用
AI-Native SEO
寻回本源:生成式搜索浪潮下SEO
AI改善工作,从文档工程开始
B2B官网:不只是网站,而是长期增长系统
SEO内容 vs GEO内容:B2B企业AI搜索时代内容营销的战略重构
AI-Native GEO
llms.txt是什么?它从哪里来,对网站有什么作用?
GEO不是让企业迎合AI,而是帮助AI认识企业
GEO选型与价值投资
B2B GEO的起点:动态Prompt Library
赵岩:AI时代,B2B营销面临的“认知交接”
从流量博弈到心智占领 ,B2B该做的是“企业知识体系”
让GEO回归长期主义和内容力
经营派GEO