Empirical Analyses Using Secondary Supply Chain Data
供应链二手数据的实证研究
二手数据在供应链管理实证研究中的应用广泛,本期公众号推文基于发表在《运营管理杂志》(Journal of Operations Management, JOM)上的一篇最新研究,对二手供应链数据的应用进行引申介绍。该文以2010—2017年美国制造业上市企业为例,系统梳理并对比了Bloomberg、FactSet和CompuStat三大主流数据库的特点,并探讨了数据源、分析单元与计量处理的匹配逻辑。
随着 Bloomberg SPLC、FactSet、CompuStat 等数据库被广泛应用于供应链创新、风险、生产率、环境治理和企业绩效等研究,不同数据源之间的覆盖差异以及供应链网络本身的复杂性,也逐渐成为影响研究结论的重要因素。同一个供应链问题既可以在企业供应商集合层面(supply-base level)进行研究,也可以保留具体供应商—客户关系层面(dyad level)进行分析,而两种做法对应着不同的数据粒度和理论含义。因此,供应链二手数据的实证研究主要产生以下三个问题:
不同供应链数据库是否会产生不同的估计结果;
将供应商—客户关系数据聚合到企业供应商集合层面是否会改变结论;
在供应链关系存在内生性、选择性和网络相互依赖的情况下,应当采用怎样的计量处理方法。
01

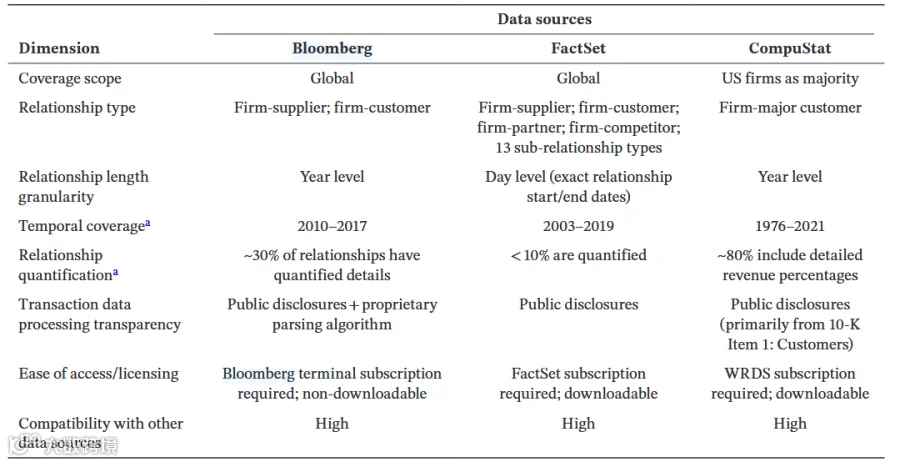
以 2010—2017 年美国制造业上市企业为主要研究对象,分别从 Bloomberg SPLC、FactSet 和 CompuStat 获取供应链关系信息,并将其与企业财务数据进行匹配。数据库比较显示,三类数据源存在明显差异。Bloomberg 的供应商及供应链关系覆盖最广,同时拥有较丰富的交易关系信息;FactSet 在关系类型和时间识别方面具有优势,但具有交易金额信息的关系相对较少;CompuStat 历史跨度较长、获取便利,但主要覆盖企业披露的重要客户,因此供应链关系范围相对有限。从实际数据覆盖来看,这种差距十分明显。在初始样本中,Bloomberg 包含71,827个供应商—焦点企业二元关系,FactSet 为38,611个,而 CompuStat 仅为1,884个;如果进一步要求供应链关系具有交易量等量化信息,三类数据库的有效覆盖又会发生明显变化。
02

将供应商—客户关系数据聚合到企业供应商集合层面是否会改变结论?
测试关系:
供应商研发强度 → 核心企业财务绩效(ROA)
结果显示,分析单位的选择会显著影响实证结果。相比将供应商信息聚合到供应商集合层面,供应商—客户关系层面分析能够保留具体 供应商与客户关系的异质性,在完整样本下也表现出更好的稳定性。并且,当供应商—客户关系数据被进一步聚合时,部分结果的显著性会减弱,甚至可能出现方向变化。这说明,数据聚合并不是一个简单的技术处理,而可能同时带来信息损失,并加剧内生性和选择偏差。
原因
聚合会丢失关系层面的异质性,掩盖不同供应商的差异。
聚合会加剧内生性和选择偏差,因为供应基础层面的遗漏变量更多。
量化关系子样本还会引入选择偏差:只有大企业、大供应商才被量化。
启示
研究关系动态、契约治理、信任 → 用供应商—客户关系层面,更稳健。
研究供应组合特征、风险分散、创新强度 → 可用供应商集合层面,但必须加强计量处理。
不要默认“聚合更干净”,它可能让结论完全反转。
03

在供应链关系存在内生性、选择性和网络相互依赖的情况下,应当采用怎样的计量处理方法?
延用上述关系研究为例:
内生性 → 工具变量(IV)
做法:用二级供应商的特征(规模、资产收益率等)作为一级供应商研发 强度的工具变量。
效果:在供应商集合层面尤其有效。Bloomberg 全样本从 0.001(不显著)变为 0.130**。
要求:第一阶段 F 值 > 10
选择偏差 → 选择校正(SL)
做法:构建条件逻辑回归模型,包含实际二元关系和伪二元关系(焦点企业与供应商竞争对手的潜在匹配),计算选择校正项加入主模型。
效果:忽略会导致效应量被高估。加入选择校正后,系数普遍下降。
注意:行业固定效应可处理时不变选择偏差,但时变偏差需选择校正。
网络相互依赖 → 二元聚类(DC)
做法:在二元关系层面进行二元聚类,因为共享供应商或焦点企业会导致误差项相关。
效果:忽略会低估标准误,夸大显著性。二元聚类后置信区间变宽,显著性水平下降。
适用:仅在二元关系层面分析中需要。
推荐处理顺序:
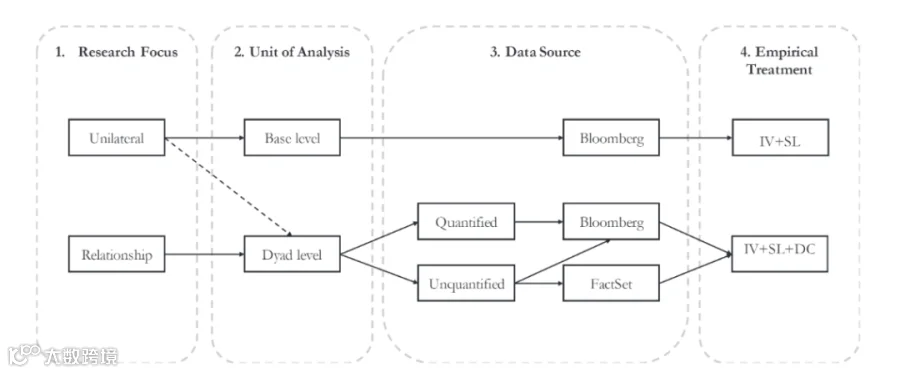
供应基础层面:工具变量+ 选择校正
二元关系层面:工具变量+选择校正+二元聚类
-
总结启示
研究问题应该先于数据选择,而不是有什么数据就研究什么问题。
1.实证研究路线:
Research Focus → Unit of Analysis → Data Source → Empirical Treatment
即:研究者首先应明确研究对象究竟是企业整体特征还是具体企业间关系,再据此决定采用供应商集合层面还是供应商—客户关系层面;之后选择能够支持相应研究问题的数据来源,并根据供应链数据的结构特征处理内生性、样本选择和误差相关问题。
2.供应链实证研究的可信度,不仅取决于模型是否复杂,更取决于研究问题、数据来源、分析层级和计量处理是否真正匹配。
内容来源
Dong, Y., Zou, F., Song, S., Peng, Y., & Xu, K. (2026). Empirical analyses using secondary supply chain data. Journal of Operations Management, 72(4), 627-650.
研究团队录制的《供应链金融》课程慕课在“学堂在线”正式上线
(点击图片即可获取课堂链接)