


会自己改自己的 AI,到底改了什么、凭什么说它真的变强了,还是只是把同一件事重复跑了很多遍。
最近一两年,AI 智能体已经能自己做实验、读反馈、改自己的工作流,「递归自我改进(Recursive Self-Improvement,RSI)」这个原本停留在思想实验里的词,开始变成一个能动手的工程问题。哈工大(深圳)联合港大、新加坡国立大学和上海科创学院,写了这篇 49 页的综述,想解决一个很基础却一直没说清的事,到底什么才算 RSI,怎么判断一个改进循环有没有真的在递归。它的态度很明确,与其争论 AI 会不会哪天突然智能爆炸,不如先把"自我改进"这四个字拆到能被验收。
图|论文首页。
一条主线,四个阶段
综述最实用的地方,是给自我改进画了四级台阶。第一级叫 evolution 进化,只改当前这一次的输出或轨迹,改完不留存。第二级 self-evolution 自我进化,会把一个被接受的改进存下来,在后面的任务或运行里复用。第三级 meta-evolution 元进化,改动动到了那个产生、评估、挑选改进的机制本身,比如换了评估器、换了更新规则。第四级才是 RSI,一轮被接受并保留的改进,成了下一轮改进的起点,下一轮从这个更好的状态接着往下优化,而不是每次都回到同一个初始状态。
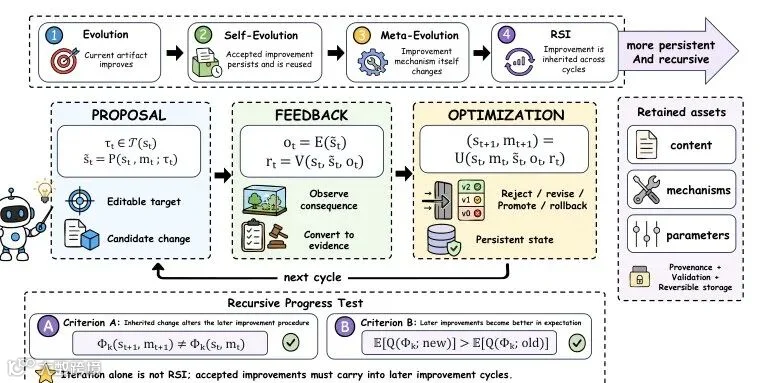
图|四阶段与 Proposal、Feedback、Optimization 循环,下方是递归进度的两条判据。
这四级的分界,不在"持不持久",在"继没继承"。作者反复强调,反复迭代不等于递归。让它称得上递归的,是状态继承,也就是上一轮被当成改进接受下来的东西,要成为下一轮的起点,而且这个继承要显式、可重载、有版本、可追溯。一次临时的上下文效应、一个随机种子、一条缓存,都不算。
更狠的是,他们把「递归进度(recursive progress)」单拎出来当作更强的主张。光继承了还不够,得能证明这个继承下来的状态,确实让后面那个负责改进的流程本身变好了,而不只是让某一次任务的分高了一点。这条门槛,把很多号称自我进化的系统挡在了外面。
一个统一的循环,六个组件
不管改什么,综述用一个三步循环来描述,Proposal、Feedback、Optimization。Proposal 负责选题和生成候选改动,Feedback 负责把候选放进环境里跑、再用测试或裁判把结果变成证据,Optimization 负责决定这条改动是保留、修改、拒绝、晋升还是回滚,并把该留的东西写进记忆和版本。

图|把循环拆成六个组件,目标选择、候选生成、执行环境、验证信号、更新策略、记忆更新。
再往下,这六步各自对应一个可改的部件,选哪个目标来改、用什么方式生成候选、在什么执行环境里跑、拿什么信号来验证、用什么更新策略、怎么更新记忆。作者特别点了一句容易被忽略的话,验证和优化是两回事,证据好看,不等于授权你把改动固化下来。很多翻车就翻在这一步,把一个只是"分数高"的改动,当成了"被验证过的改进"。
四类进化对象,从改输出到改科研
有了阶段和循环,综述再把一堆方法按改的是什么分成四类,并给了一张分类地图。
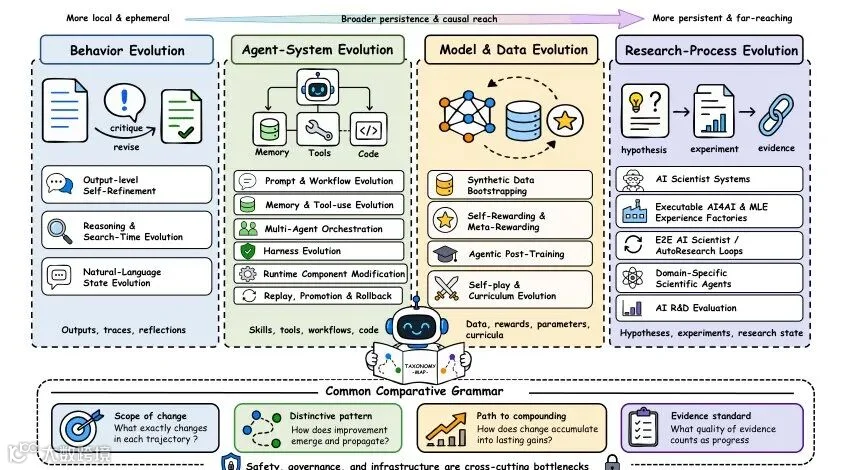
图|四类进化对象,从局部易逝的改输出,到更持久、影响更远的改科研流程。
第一类改行为,反复修订输出、推理、计划,模型参数和结构不动。代表是 Self-Refine、Self-Debugging、Chain-of-Verification 这类自我批评加反思,往深了走有树搜索、过程奖励、SEAL 这种把搜索轨迹回灌进后续更新的,再往持久走有 ExpeL 把经验蒸成规则、PromptBreeder 进化提示、Voyager 存技能库、MemGPT 管外部记忆。第二类改智能体系统,动的是提示与工作流、harness、记忆与工具、多智能体编排、运行时组件,以及回放、晋升、回滚这套机制。第三类改模型与数据,合成数据自举、自我奖励与元奖励、智能体后训练、self-play 与课程进化。第四类改科研流程,让系统自己提假设、跑实验、写论文,代表是 AI Scientist 这类端到端自动科研和面向领域的科研智能体。四类共用同一套循环,区别只在能改的对象、留存的资产,以及算不算进步的证据标准。
光会提改动没用,能不能"接受"才是瓶颈
这篇最锋利的判断是,现代 RSI 卡住的地方,是能否可靠地接受那些能留存、能迁移的改动,提出候选反而不是最难的。理由很实在,反复优化很容易过拟合基准、钻评估器的空子、或者只是把裁判的反馈刷满。综述点出一个 RSI 特有的难题,验证器本身会变成被优化的目标,一个学会猜裁判口味的候选,可以看着很成功,实际上在削弱系统发现和评估未来改进的能力。更糟的是,一次假成功一旦被写进记忆、技能库、数据管线或某个发布版本,后面的循环会把它当成能力的证据继续放大。所以作者主张,把 LLM 裁判当成一个参考信号,别当神谕,得配上确定性的验收、隔离的执行、冻结的留出集和金丝雀样本。
一套可审计的验收协议
为了让"我做了 RSI"这句话可查,综述给了一套最小实验记录,论文要声称递归进度,得交五样东西。一是说清旧状态、新状态和被改的那个部件,证明下一轮确实加载并依赖了这个被接受的改动。二是做反事实对照,把继承了状态的循环,跟冻结的旧版本、跟不做保留的消融、跟取历史最优的祖先去比,其它资源对齐。三是跨轮回放和迁移,在以前做对和做错的题上都重跑,再上留出任务、环境、随机种子或裁判,看这份改动出了当初那个评测场景还成不成立。四是统计证据,报跑的次数、方差或置信区间、显著性或等效性检验,单次结果只能算演示。五是失败判据,一旦收益在匹配的算力下消失、依赖了更强的底座、只是搜索更宽样本更多、削弱了独立验证器、或者只讨好当初那个准入裁判,就不许声称递归进度。
历史脉络,从思想实验到能跑的循环
综述把这条线拉得很长。思想源头是 Butler 的"机器间的达尔文主义"、图灵谈机器在交互中改进、以及 I.J. Good 形式化的智能爆炸,一个机器设计出更强的后继者,后继者又是更好的设计者,关键在那个正反馈。到了机器学习时代,AutoML、NAS、self-play、元学习把这些想法变成有界、可执行的优化,但目标、搜索空间、发布门槛多是外部固定的。到今天,能写代码、调工具、读失败反馈的智能体,才让"提出改动、跑实验、决定保留还是回滚"真正循环起来。作者的落点是,现在该问的,是这个改进循环里到底哪几环真的递归、真的在复利、真的被系统自己掌控,智能爆炸有没有发生反而是其次。
七个还没解决的方向
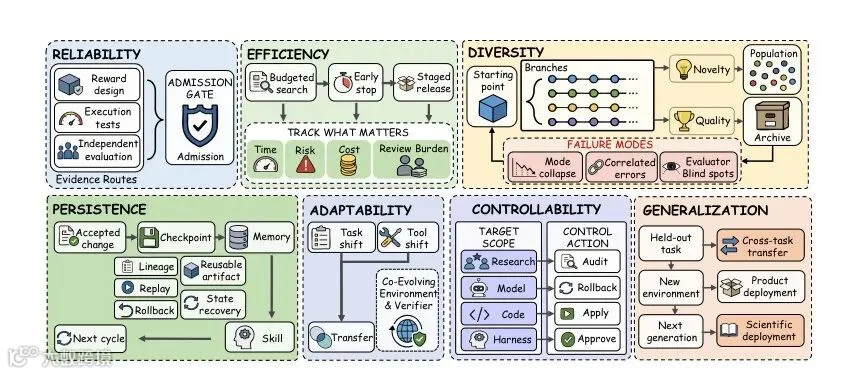
图|七个维度和典型的失败模式,可靠性、效率、多样性、持久性、适应性、可控性、泛化。
结尾综述列了七个维度。可靠性,看改动是不是真提升了该提升的能力,而不是只涨了分。效率,在有限算力、时间和人力评审预算里怎么分配搜索。多样性,警惕模式坍缩、错误相关、评估器盲区把有用的分支抹平。持久性,测被接受的改动到下一轮还留不留得住、会不会回滚。适应性,环境和评估器一起变时还能不能跟上。可控性,谁能批准、回滚、审计,防止篡改混进最优血脉。泛化,收益能不能跨任务、跨环境、跨代传出去。这七条其实都绕回同一个动作,接受、复用、迁移,一步没做扎实,所谓递归就只是把同一件事重复了很多遍。
这篇的分量,和它的边界
它给一个被用滥的词重新立了标尺,把"AI 会不会越改越强"这个大问题,落到状态继承、验收证据和迁移这三件能查的事上。对做智能体和自动科研的人,这更像一张地图,告诉你哪些所谓自我进化只是重复迭代,哪些才配叫递归。
这是一篇综述,它给的是框架和验收标准,不是某个刷了榜的新方法;四类对象里大量工作还停在有界的自我进化,真正闭环、且能证明改进者本身变强的例子很少;而它反复强调的证据门槛,恰恰是当前论文最普遍缺的东西,这也意味着,接下来一段时间,RSI 的进展要看的是有没有人愿意按这套协议,把"我真的在递归变强"这件事,做成能被别人复现和推翻的实验。
论文信息
标题 Towards AI That Improves Itself: A Survey of Recursive Self-Improvement
资源 github.com/Lee1003-lee/Awesome-RSI-Research