自回归视频模型里,同一个DiT既要"记住刚才画了什么",又要"画好现在这一帧"。清华大学联合京东Joy Future Academy、港中文发现这两个角色的梯度方向夹角超过90度、在共享参数上互相抵消,于是给它们各配一套参数(SGF+)。只训5秒视频窗口,模型能连续生成到24小时;240秒长视频的主体一致性从96.36提到98.74,训练开销只增加8.2%,推理速度几乎不变。
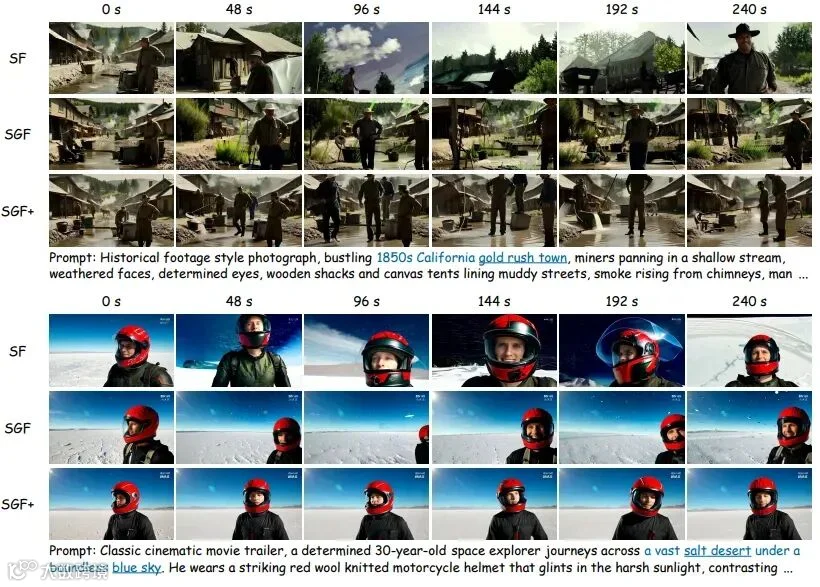
 上排:240秒内SGF+与SF、SGF的画质对比;下排:只用5秒视频训练,24小时连续 rollout 的画面仍然稳定。
现有自回归视频扩散模型的通病是:短窗口训练,长窗口就崩——画面漂移、主体变形、绿条纹伪影,训练窗口之外每多生成一秒都在赌运气。常规解法是堆长视频数据做微调,成本高且治标。
SGF+(Self Gradient Forcing Plus)走的另一条路:不改数据、不加长训练,只动参数结构。作者在SGF训练框架里测量发现,"写上下文"(把已生成帧编码成KV cache供未来用)和"去噪"(把当前噪声latent还原成画面)这两类token的梯度在Attention和FFN里平均方向夹角分别达到104.2度和106.3度,512对配对余弦相似度全部为负——两个角色在同一套参数上互相拆台。SGF+给两个角色各配一套完整参数,靠因果注意力保持前向交互,用原有的DMD生成目标联合优化,不加任何辅助损失。
效果:240秒(训练窗口的48倍)生成中,主体一致性、背景一致性、时序闪烁、运动平滑等指标全面优于Self Forcing和SGF两个基线;只训5秒视频窗口即可连续生成24小时。代码、推理脚本、训练代码和checkpoint已于10月7日全量开源,协议Apache-2.0,底座是Wan2.1-T2V-1.3B,一张高显存卡即可推理。
相关链接
-
论文:https://arxiv.org/abs/2610.10429 -
代码:https://github.com/Zihan-Su/Self_Gradient_Forcing_Plus -
主页:https://zihan-su.github.io/self-gradient-forcing-plus -
模型权重:https://huggingface.co/ZihanSu/Self_Gradient_Forcing_Plus -
开源协议:Apache-2.0(底座Wan2.1遵循其自身协议)
内容介绍

一句话:SGF+是一个自回归视频扩散训练框架,输入文本提示,输出可无限外推的长视频——训练窗口只有5秒,推理时能稳定外推48倍(240秒)直至24小时。
与"堆数据微调长视频"的常规路线不同,它的卖点是:
-
只拆参数,不加数据:不引入辅助损失、不用长视频训练、不延长训练时长,240秒内一致性指标全面领先。 -
推理几乎不花钱:generator参数量从1.4B翻倍到2.8B,但每个token前向只走自己角色的那套参数,81帧推理耗时4.969秒,对比SGF的4.962秒基本不变。 -
角色冲突可以提前诊断:梯度夹角在teacher forcing初始化阶段就已经超过90度,不用等训练崩了再找原因。
适用场景:长视频/直播流式生成、交互式世界模型训练、以及任何用"自回归+KV cache"结构的视频扩散改造。
方法概述
一套机制管发现冲突,一套机制管解决冲突。
1. 两次 pass 的训练框架(Self Gradient Forcing 回顾)
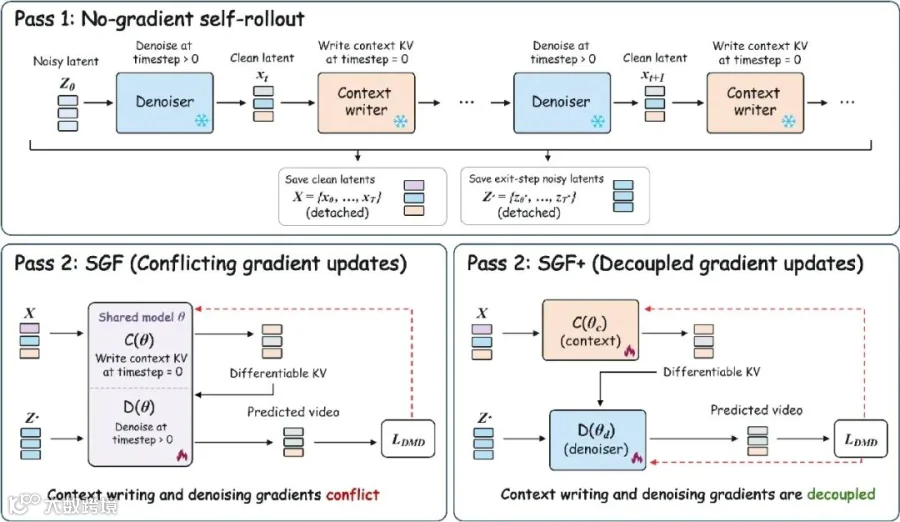
自回归视频扩散的每一步要干两件事:把当前块的噪声latent去噪成干净估计,再把干净估计编码进KV cache给后面的块用。SGF用两次pass解决"上下文写入没有监督"的问题:Pass 1做无梯度的自回归rollout,记录每步的出口噪声latent和干净估计;Pass 2在单次并行前向里重建计算图,干净估计以stop-gradient进入,KV投影带梯度,用DMD损失同时训练"读历史"和"写历史"。这样上下文写入路径有了监督,又不用反传整个rollout。
2. 梯度冲突的测量(核心发现)
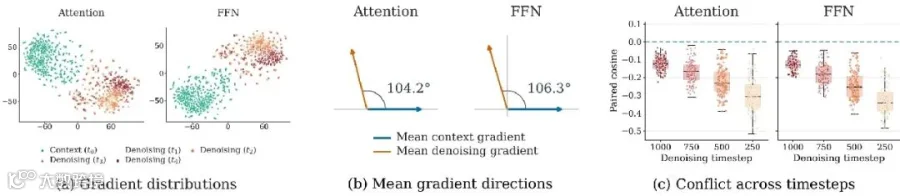 左:t-SNE上两类token的梯度分布明显分开;中:平均梯度方向夹角Attention 104.2度、FFN 106.3度;右:512对配对余弦相似度全部为负。
把Pass 2里同一个线性层的梯度按token角色拆成两部分:g_C(上下文写入)和g_D(去噪),算余弦相似度。结果在Attention和FFN两个模块族里,两类token的梯度分布用t-SNE看是明显分开的两团,平均方向夹角一个104.2度、一个106.3度,全部512对配对余弦相似度为负。由于共享参数收到的更新是g_C+g_D,负对齐意味着两个角色的梯度在共享权重上互相抵消——这就是长视频外推时质量劣化的优化层根源。更有意思的是,这个冲突在teacher forcing初始化阶段(还没开始SGF训练)就存在:128个真实视频、50个去噪时间步的测量里,Attention和FFN的平均梯度夹角分别达到95.1度和105.1度。
3. 角色参数分离(SGF+)
解决方式直接:给上下文写入器C(θc)和去噪器D(θd)各配一套完整参数,都从同一个自回归扩散模型初始化。Pass 1里D(θd)负责生成、C(θc)负责写cache,Pass 2里各自只收自己角色的梯度,前向仍通过因果注意力交互。作者也试过用两个LoRA adapter做轻量分离(论文里提了这条路),正式版本用的是两套完整参数。消融显示只在Attention分离、或只在FFN分离(MoE式角色专家)都不如全模型分离——冲突在两个模块族里都存在,只拆一边不够。
 左:SGF共享参数,两类梯度在更新里互相抵消;右:SGF+参数分离,梯度各走各路,前向交互不变。
实验结果

底座:Wan2.1-T2V-1.3B学生 + 冻结的Wan2.1-T2V-14B teacher + 从Wan2.1-1.3B初始化的fake-score网络。训练数据是VidProM过滤扩展后的提示词,5秒视频窗口,64张GPU无梯度累积——framewise训1900步、chunkwise训700步就到位。60秒评测用VBench-Long提示词,240秒用128条MovieGen提示词,所有方法共享相同初始化、提示词和随机种子。
240秒长视频(framewise,分数x100,越高越好)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
98.74 |
|
|
|
|
97.81 |
|
|
|
|
98.24 |
|
|
|
|
98.94 |
|
|
67.04 |
|
|
六项质量与一致性指标SGF+全部第一。唯一的例外是动态程度:SF和SGF分数更高,但论文给出的解释是,基线在长视频里出现的场景跳切、物体形变、主体消失、凭空多出人来,都会制造"大而无当"的表观运动刷高这项分数——SGF+画面稳定、运动连贯,低分不等于动作差。这个解释合理,但终究是作者自己的解读,论文没有用人工评测单独验证它,读者看演示视频时可以自己判断。
效率(81帧推理,Wan2.1-1.3B量级)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参数量翻倍(generator 1.4B→2.8B)换来的代价是训练每步慢8.2%、推理显存多3GB,推理延迟几乎不动——因为每个token在一次前向里只经过自己角色的参数,计算量没有翻倍。
24小时外推

只用5秒窗口训练的SGF+,在论文附录里展示了4个24小时连续生成的例子,全程无长视频微调。推理侧配合sink+FIFO的KV cache管理(framewise窗口21帧、chunkwise窗口12帧),仓库默认配置一次生成963个latent帧,即16帧率下约240秒,可循环外推。项目还提供了Reactor Runtime集成:单张B200起交互式服务,生成过程中可以实时改提示词。
结论
SGF+证明了一件事:自回归视频生成的长程崩坏,有一部分根源不在数据、不在算力,而在优化——两个角色的梯度在共享参数上互相抵消。把参数拆开,5秒的训练窗口就能撑起48倍的外推。
对于做视频生成或世界模型训练的研究者,这篇的价值不只是一个SOTA点,而是"先测梯度夹角、再决定参数结构"的诊断流程,值得搬到自己的pipeline里;对于普通创作者,直接拉HuggingFace上的checkpoint做240秒级长视频即可,Apache-2.0协议商用无忧,但注意底座Wan2.1自身协议的约束,且训练复现需要64卡的预算。
长视频的尽头未必是更大的模型,可能只是让模型里的每个角色各司其职。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~