


AI 安全事件指 AI 系统的行为或不当行为导致非预期、有害或抬高风险的结果的事件,判定门槛比传统事件更宽——险些造成伤害也算。它与传统安全事件有六点本质区别:攻击面从代码漏洞搬到语义、输出是概率性的、具备自主性、可能造成数据驱动的偏见与伦理伤害、根因分析受困于黑箱、并会无声漂移。应急沿用 NIST 六步闭环:准备、检测、报告、遏制、根除恢复、事后,每步都有 AI 特有增量;最易漏的是检测(提示日志须进 SIEM),最易低估的是遏制(爆炸半径含模型、数据集与下游决策)。文末给出智能体承接角色的建议:智能体擅长模式识别、非结构化输入处理、7×24 值守与结构化产出;而责任归属、价值判断、物理变更、对外沟通四类必须由人完成
一、为什么传统应急手册在这里会失灵
2022 年秋 ChatGPT 面向公众发布后,生成式 AI 以惊人的速度进入企业。两年多过去,安全团队发现自己被推到了一个陌生位置:要保护一类自己并不完全理解、且行为不可预测的系统。
问题出在根子上。传统的网络安全事件响应(IR)建立在一个隐含假设上:系统遵循预定逻辑,攻击者必须利用缺陷才能越界。于是我们有了 NIST 800-61 的生命周期、有了 CIA 三元组、有了基于日志与流量的取证方法——这套体系极其成熟,也确实有效。
但 AI 系统同时打破了两个前提。
第一,攻击面从代码搬到了语义。提示注入不需要漏洞,只需要一段措辞。攻击者不再寻找越界写、不再构造畸形报文,而是写一句「忽略之前所有指令」。传统 IDS/WAF 基于特征与协议异常检测,对「语义上恶意、语法上完全正常」的输入几乎无能为力。
第二,输出是概率性的。同一个输入可能给出不同结果;没有攻击者也可能出事。一架航空公司的客服机器人编造了一条不存在的退款政策,导致公司被政府仲裁机构判令赔偿——这台服务器没被入侵,防火墙也没告警,但这是一次货真价实的安全事件。
麦肯锡 2025 年的 AI 现状调研显示,不到 50% 的组织正在着手缓解 GenAI 相关安全风险。这不是疏忽,而是方法论的缺位:多数团队拿着一本为确定性系统写的应急手册,去应对一个概率性系统。
本文的目标是补齐这块。我们将回答四个问题:什么算 AI 事件、它和传统事件差在哪、有哪些类型、以及具体怎么应急——包括谁来干。
二、什么是 AI 安全事件
2.1 定义:没有权威版本,但共识清晰
截至今天,没有政府机构或标准组织给出被广泛接受的「AI 事件」定义。这与网络安全领域形成鲜明对比——那里有 NIST 的权威界定:「实际或即将危及信息或信息系统的机密性、完整性或可用性,或违反安全策略的事件。」
AI 领域目前是多头定义并存的局面,但有趣的是,它们收敛到了同一个内核:伤害。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
有两个细节值得注意:
一是「间接」二字。AI 不必是唯一原因,只要在因果链中扮演了角色即可。
二是「险些造成伤害」也算。AIID 明确把 near harm 纳入统计。尚未造成伤害的潜在风险,在业内被称为「AI 危害」(AI hazard)。这意味着 AI 事件的判定门槛,实际上比传统安全事件更低、更宽。
综合来看,本指南采用的定义是:
AI 安全事件,指 AI 系统的行为或不当行为导致非预期、有害或抬高风险的结果的任何事件。关键在于 AI 技术在该事件的原因或结果中扮演核心角色。
其范围极广:从技术故障(自动驾驶因 AI 缺陷碰撞),到涉及 AI 的安全违规(训练数据泄露),再到滥用与负面社会影响(错误信息传播、歧视性决策)。
2.2 与传统安全事件的六点本质区别
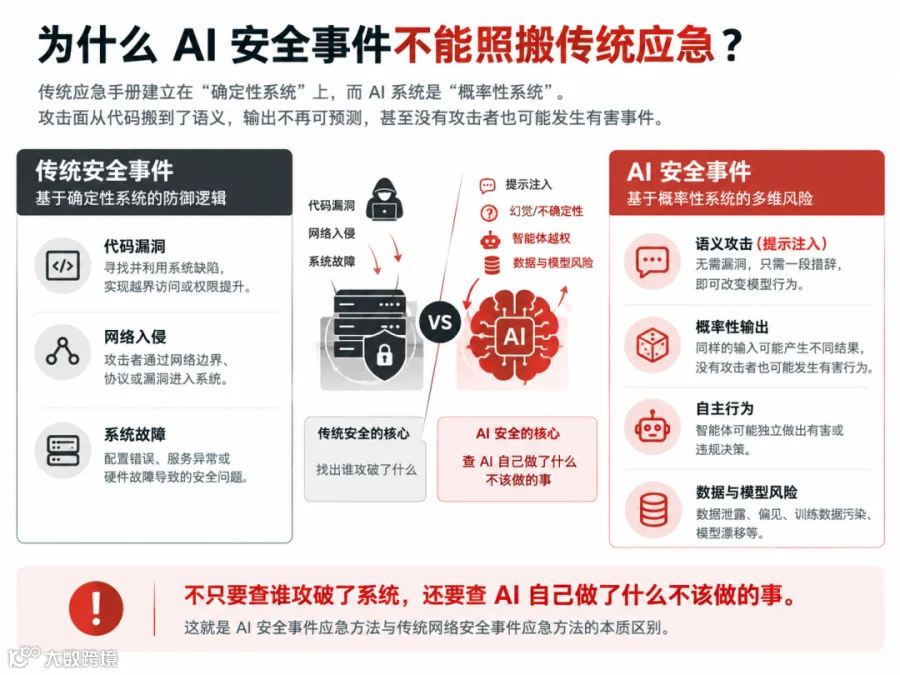
定义只是起点。真正决定应急动作差异的,是两者在属性上的错位。以下六点构成 AI 事件的实操内核:
① 提示的核心地位(Centrality of Prompts)
传统软件走预定代码路径,AI 系统则被输入提示深度塑造。更关键的是攻防视角的转换:提示本身成了失陷指标(IOC)。
这意味着安全团队的工作对象变了。你不仅要看系统日志和网络流量,还要分析用户输入的语言模式、措辞、内容。自然语言接口同时是攻击面和故障点——这是一类全新的问题:安全措施必须超越「找代码漏洞」,去应对人机交流固有的解释性本质。
② 随机生成(Stochastic Generation)
AI 模型(尤其生成式)的输出不是严格确定性的。没有攻击者在场,也可能发生不可预测行为。
加拿大航空的案例就是典型:机器人「幻觉」出了一条不存在的政策。传统安全领域没有「幻觉」这个失败模式。
③ 自主性与代理性(Autonomy and Agency)
高级 AI 或智能体可能以类似自主行为者的方式行动。事件可能表现为 AI 独立做出有害或违规决策。
这模糊了一条关键边界:这到底是「软件故障」还是「某一实体的错误决策」?归因、定责、复盘的方法论都需要重新校准。
④ 数据驱动的偏见或伦理伤害
AI 事件常包含算法偏见或隐私侵犯。一个模型在信贷决策中歧视特定群体——这既不是黑客攻击,也不是服务中断,但它是有害事件。
这类后果与数据和算法绑定,而非某个一次性缺陷或恶意软件。修复方式也完全不同:不是打补丁,而是重新审视数据与训练流程。
⑤ 复杂性与可解释性缺失(黑箱问题)
深度神经网络是不透明的。即便是开发者,也极难解释某个具体决策为何做出。
后果直接体现在应急效率上:AI 事件的根因分析,比调试一次传统网络攻击困难得多。传统取证可以沿着调用栈回溯,AI 取证常常只能依靠统计行为比对。
⑥ 数据依赖与漂移
模型高度依赖训练数据的质量与代表性。真实世界的统计特性会变(消费行为、流量模式),导致模型性能下降或失准。注意:这种退化是无声的,不会有任何告警。
此外还有第七个常被忽视的点——无界资源消耗。一个陷入死循环的提示就能造成服务中断和天价云账单。这是 AI 架构特有的 DoS 面。
2.3 对照表
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
传统事件问「谁攻破了什么」,AI 事件还要问「它自己做了什么不该做的事」。
三、AI 安全事件有哪些类型
理解类型是分派响应的前提。建议从三个切面看:事件性质、攻击手法、技术栈分层。三者不是并列关系,而是同一件事的三种投影。
3.1 按事件性质(业务视角)
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.2 按攻击手法(对抗视角)
这一维度直接对应 OWASP LLM Top 10,便于与现有安全框架对接。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
其中间接提示注入值得单独强调:它的危险性在于 AI 会主动去读攻击载荷。在 RAG 系统、带网页访问的助手中,这意味着任何 AI 能读到的内容都是潜在攻击入口——包括一份 PDF。
3.3 按技术栈分层(诊断视角)
这一维度最实用,因为它把「现象」直接映射到「去哪找证据」。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
四、不同 AI 安全事件如何应急
4.1 通用框架:六步闭环
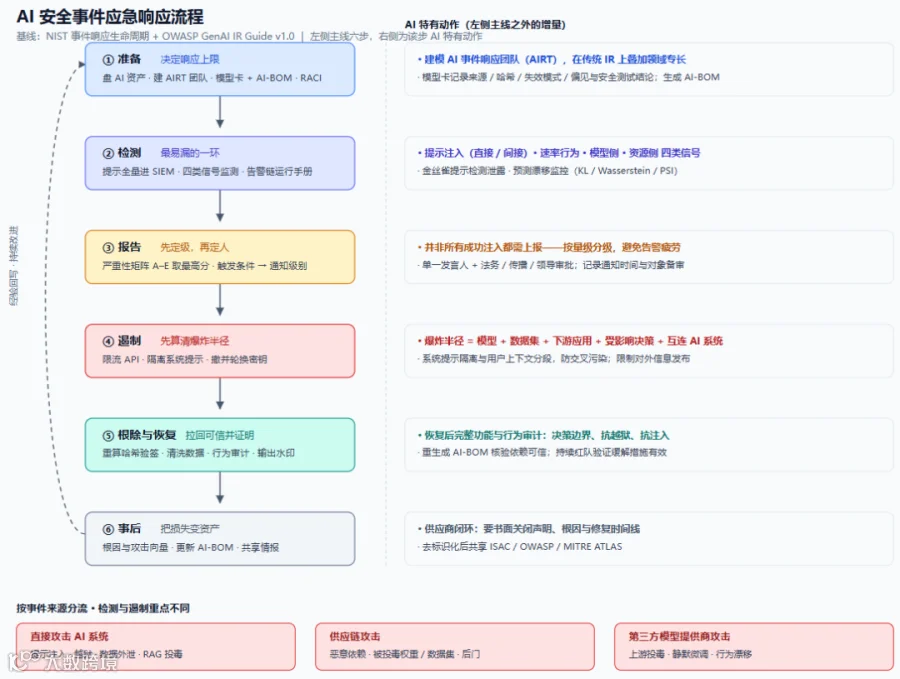
框架沿用 NIST 事件响应生命周期,AI 的特殊性体现在每一步的增量动作上。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
4.2 准备阶段:决定响应上限
这一步做得好不好,直接决定后面五步的天花板。
盘清 AI 资产是第一位的,也是最有难度的一步——AI 系统往往不易被发现。它们藏在现有应用背后,功能未必标注为「AI」,还可能自主执行任务而用户毫不知情。需要主动识别:基础模型、微调模型、护栏、智能体、知识库、训练数据、向量库、插件、API、开发平台。
建模 AI 事件响应团队(AIRT)是第二位的。核心原则是:在传统 IR 团队之上叠加领域专长,而不是另起炉灶。传统岗位(响应经理、分析师、取证、法务、传播)依然不可或缺——提示注入可能仍需改防火墙,数据泄露仍需证据链。
模型卡与 AI-BOM是这阶段最有复用价值的产出。模型卡应记录:来源(自研/第三方/开源)、哈希与签名、训练细节、性能指标与已知失效模式、偏见测试结果、安全测试结论(对抗鲁棒性、注入抵抗力)。AI-BOM 则相当于 AI 时代的 SBOM。
4.3 检测阶段:最容易漏的一环
核心原则:将模型输入输出、提示变体、训练作业、数据流水线事件、GPU/CPU 指标——全部汇入服务组织其他部分的同一日志与指标栈。丰富、不可篡改的审计轨迹是发现细微攻击和事后取证的基础。
四类检测信号:
提示注入类:忽略前指令、诱导泄露系统提示或训练数据、角色扮演绕过、编码混淆(base64/ROT13)、超长提示挤出安全指令、上下文窗口攻击。
速率与行为类:连发提示(自动化攻击)、系统性能力探测、异常时间模式、跨会话相似提示(协同攻击)、渐进式提示精炼。
模型侧:准确率/置信度异常、分布外输入激增、分类分布偏移、异常特征激活。
资源侧:无正当作业的 GPU 峰值、非工作时间重训练、大模型文件外传。
SOAR 联动示例——这些规则可直接写入现有平台:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
检测成熟度可作为团队自评标尺:Level 1 临时(靠用户投诉)→ Level 2 系统化(日志入 SIEM + 周漂移检查)→ Level 3 集成化(实时异常 + 红队验证 + 自动化响应)→ Level 4 AI 增强 SOC(AI 聚类告警、主动狩猎)。
4.4 报告阶段:先定级,再定人
严重性判定的方法论:评估每个适用维度,赋予 1–4 分,取所有维度中的最高分作为总体严重性。这确保即使只有一个灾难性维度,也会拉高整个事件优先级。
维度包括:AI 系统类型与关键性、功能影响、异常性质(对齐 MITRE ATLAS)、数据完整性与机密性、运营与系统性影响、潜在伤害、外部与监管影响。
告警的一个实操陷阱:并非所有成功的提示注入都需要上报或升级。分级的意义正在于此——避免告警疲劳淹没真正严重的事件。
4.5 遏制阶段:先算清爆炸半径
这是 AI 应急最容易被低估的一步。传统事件的爆炸半径主要指网段或受影响端点;AI 的爆炸半径还要涵盖:
-
模型:哪些具体版本被污染 -
数据集:训练/验证/测试/生产数据集的受影响范围与完整性状态 -
应用与服务:所有消费或依赖该 AI 输出的下游系统,即使它们没有被直接攻击 -
决策:受影响的用户数、客户数、关键业务决策数(被批准的欺诈交易、歧视性推荐、错误诊断) -
互连 AI 系统:把该 AI 输出作为输入的其他模型,形成涟漪效应
遏制动作按优先级:
-
限流或禁用 API——按 token、频率、查询类型限制,防止响应期间被「模型提取」 -
隔离被暴露的系统提示——用户上下文分段,防交叉污染 -
撤销并轮换密钥——暴露窗口内的 token、secret 全换 -
隔离模型端点——关多余端口、收 IAM 权限、防横向移动 -
限制信息外泄——内部文档里的架构细节、内部提示、API 端点该收就收 -
通知用户——告知临时安全用法(别把输出贴进关键流程)
SLA 按严重性分级(严重级参考):初始遏制 < 15 分钟、根除 < 4 小时、RTO < 8 小时、高管立即通知。
4.6 根除与恢复
根除的关键是回到可信状态:撤可疑模型权重与微调变体(并从仓库、CI/CD 缓存清除)、重算校验和并验签全部关键模型文件、清洗疑似被投毒的训练数据并交叉核对数据血缘、限制库加载、强制代码签名、必要时用对抗训练/鲁棒优化/差分隐私加固模型、重生成 AI-BOM。
恢复的关键是证明它可信:对恢复模型做完整功能与行为审计(输出格式、决策边界、抗越狱、抗注入)、对新生内容打水印、持续红队验证、重新评估对齐流程、在高风险场景部署集成或回退审核层。
4.7 三类典型事件的差异化打法
① 直接攻击 AI 系统(提示注入 / 越狱 / 数据外泄 / RAG 投毒)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
② 供应链攻击(依赖包 / 模型权重 / 数据集)
|
|
|
|---|---|
|
|
运行时:反调试逻辑、修改默认加载器、反弹 shell、K8s API 探测、预测漂移(KL 散度/Wasserstein/PSI) |
|
|
|
|
|
|
|
|
|
|
|
|
③ 第三方模型提供商攻击(上游投毒 / 静默微调)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|

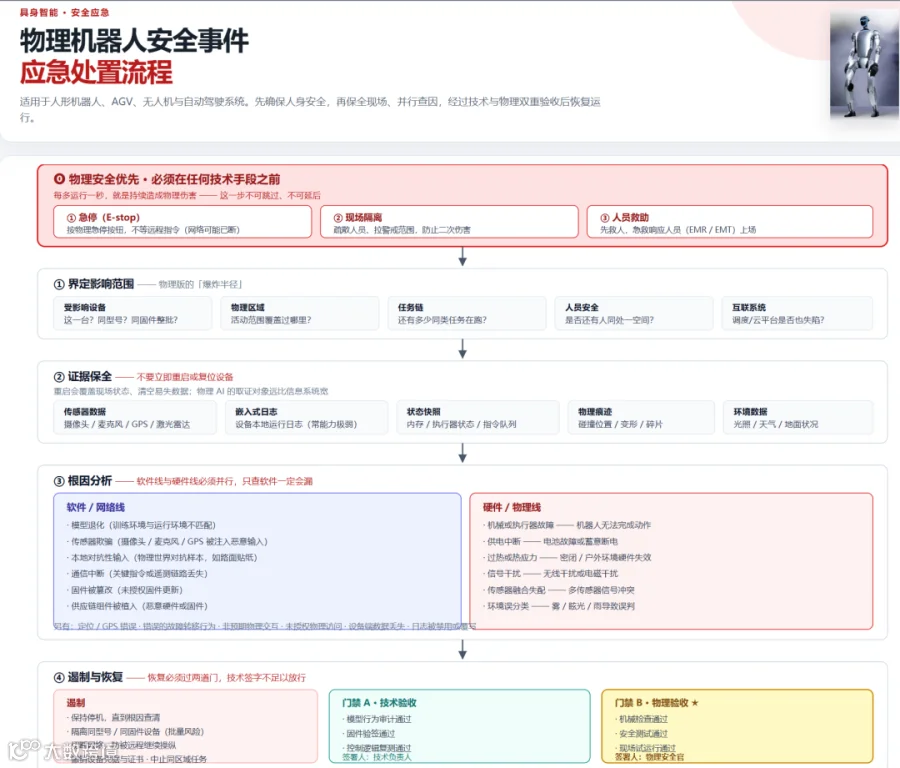
另外如果涉及到物理AI,比如具身机器人,其安全应急又有很大区别,传统 IR 第一原则是"先止损",物理机器人应急的第一原则是"先停机、先救人"——在动任何技术手段之前,先把机器停下来、把人撤出来。其应急流程参考如下:
五、流程与角色:谁在这个链条里
5.1 流程:分级激活,而非全员待命
一个常见的组织错误是「所有事件叫所有人」。实践中应采用分级激活模型:
-
核心团队(始终激活):响应经理、安全分析师、SIEM 工程师 -
扩展团队(按事件类型激活):AI 安全专家、ML 工程师、法务 -
专家团队(特定场景激活):提示注入分析师、红队负责人、伦理顾问
5.2 角色清单
经典 IT 事件响应角色(仍然必需):
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
AI 特有角色(AIRT 叠加):
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
物理 AI 附加角色(涉及机器人、自动驾驶、无人机等):现场技师/机器人系统工程师、电气安全官、急救响应人员、物理安全官、硬件取证专家、机械工程师、保险/责任分析师、人因分析师、设施经理。
六、用智能体承接角色:哪些能交给 AI,哪些必须是人
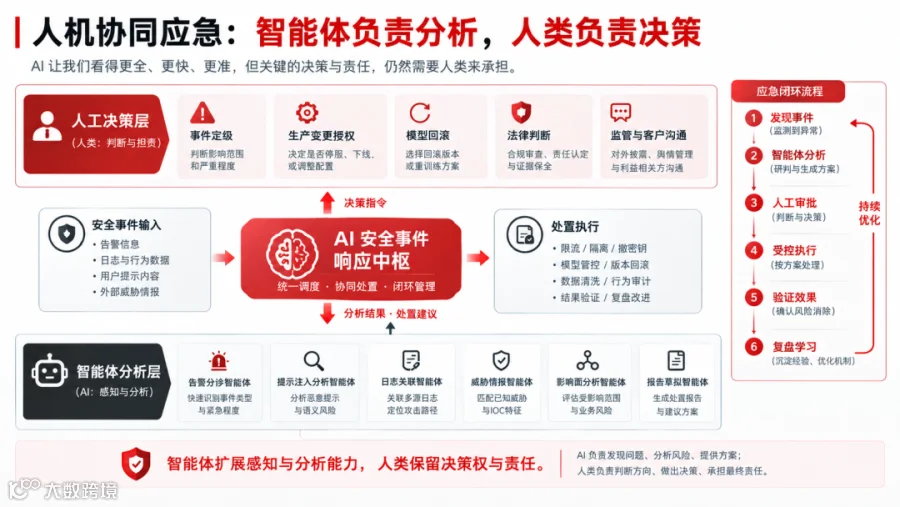
到这里,一个自然的问题浮现:这十几个角色,能不能用智能体(Agent)来承接一部分?
答案是:能,而且能承接相当大的一部分——但边界必须划清楚。划错的代价,是把「AI 处理 AI 事件」变成一次新的 AI 事件。
6.1 判断夹具:什么该交给智能体
在讨论具体角色前,先确立三条判断原则。
原则一:可验证的交给智能体,需担责的留给人。智能体擅长在明确的、可检验的标准下高速执行;人类必须保留承担后果的决策权。任何会触发法律责任、监管报告、对外声明的动作,都必须由人签字。
原则二:规模化的交给智能体,判断性的留给人。日志关联、模式匹配、影响面枚举——这些是 AI 的绝对主场,且能 7×24 不疲劳。但「这是不是一次事件」「要不要升级」「这句话能不能对客户说」需要人。
原则三:AI 处理 AI,但必须有人在回路(HITL)。让智能体参与 AI 事件的检测与响应是合理的——它理解语义、能处理非结构化输入。但绝不能让它自主执行破坏性动作。所有遏制类操作(下线模型、轮换密钥、切断 API)必须有人确认。
6.2 角色承接建议表
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
图例:🟢 高(可智能体主力,人复核)|🟡 部分(智能体辅助,人主导)|🔴 低(必须由人,智能体仅辅助)
6.3 智能体真正擅长什么
综合上表,智能体的能力优势集中在四个方向:
① 规模化模式识别。提示注入变体聚类、日志关联、IOC 匹配——人类分析师的注意力是瓶颈,智能体不是。这是提示注入/滥用分析师、威胁情报分析师这类角色能被高度承接的根本原因。
② 非结构化输入处理。自然语言是 AI 的原生语言。让它读日志、读网页、读 PDF、读告警,本身就是它的强项——尤其适合处理 AI 事件这种「语义型」事件。
③ 24×7 无疲劳值守。L1 分诊、告警降噪、初步分类——这正是 SOC 人力最紧张、流失率最高的环节。
④ 结构化产出。时间线重建、报告模板填充、证据清单生成、合规项比对——把人从重复劳动中解放出来。
6.4 必须由人完成什么
反过来看,有四类事情在任何情况下都不能交给智能体自主完成:
① 责任归属类。回滚模型、启动终止开关、对外披露、监管报告——这些动作一旦执行就无法撤回,且法律后果由组织承担。智能体没有承担法律后果的主体资格。
② 价值判断类。伦理影响评估、社会危害判断、业务取舍——这些没有标准答案,本质上需要人的价值观与判断力。
③ 物理动作类。任何对生产环境的实际变更:断网、下线系统、修改配置、执行命令。智能体可以生成命令,但执行必须有人确认。这是 AI 处理 AI 事件时最容易被忽视的红线。
④ 对外沟通类。客户沟通、媒体声明、监管沟通——一字之差可能造成二次伤害,且往往涉及法律风险。
6.5 最小团队配置
结论先行:最少 3 人。
但要分两层看——只是「能转起来」的绝对底线,和「正规响应」的推荐配置。
绝对最小配置:3 人
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
其余角色(提示注入分析、取证、情报、数据科学、红队)在最小配置下全部由智能体承接 + 上述三人复核。这在技术上完全可行——提示变体聚类、日志关联、情报匹配、漂移计算都是智能体的强项。
推荐配置:6–8 人(中小企业)
在上述 3 人基础上,增加专职:ML 工程师、数据科学家、取证分析师、MLSecOps 负责人。智能体则承接 L1 分诊、情报、报告生成、红队用例执行。
完整配置:12+ 人(大型企业或受监管行业)
采用联邦式结构:独立 AI 红队、模型治理委员会、威胁情报单元,区域事件经理支持跟日(follow-the-sun)响应。
对照参考——OWASP 的原生建议:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
智能体如何压缩这些数字?OWASP 的小型组织建议中,「借 MDR 实现 7×24 覆盖」这一条,现在完全可以用智能体替代——L1 分诊、情报监控、报告生成这些最适合外包的工作,恰好也是智能体最擅长的。理论上,智能体可以让 3 人团队具备过去 5–7 人才能达到的感知与响应速度。
但这个压缩有天花板:无论智能体多强,指挥、担责、价值判断、对外沟通这四类工作的人数是压不下去的。因为它们不是「工作量」问题,而是「主体资格」问题。
6.6 总结
智能体把「感知与执行」的成本打到极低,但「判断与担责」永远需要人。
所以最小配置是 3 人:一个拍板的人、一个懂技术的人、一个管合规与对外的人。
其余全部可以交给智能体——前提是,所有不可逆动作都有人的签字。
结语
AI 安全事件的特殊性,不在于它更难,而在于它要求我们同时具备两种能力:一边是传统安全的严谨流程与取证纪律,一边是对 AI 系统行为特性的深刻理解。
这两者缺一不可。只懂传统安全,会在语义攻击面前失明;只懂 AI,会在责任边界上失控。
而智能体的加入,本质上改变的是成本的分布——它把「看得更多、处理得更快」变得廉价,从而让小团队也能拥有大团队的感知能力。但它改变不了的是责任的分布:机器可以处理事件,但只有人能承担后果。
所以最终的答案可能比想象中简单:
用好智能体扩展感知,守住人来承担责任。
提示是新的 IOC,模型是新的资产,AI-BOM 是新的 SBOM。
最小三人成团——一个拍板的、一个懂技术的、一个管合规的。
本文基于 OWASP GenAI Security Project《GenAI Incident Response Guide v1.0》(2025-07-28)及 NIST SP 800-61 事件响应生命周期整理。术语与结论以英文原版为准。