

BIOAIDESIGN 论文精读 · bioRxiv
● ● ● IN BRIEF
结构与共进化信息能补强部分未见突变的预测,但跨位置、跨骨架与新功能外推,并不是同一道题。
埃因霍温理工大学 Francesca Grisoni 团队与曼彻斯特大学 · 2026-10-07
用已有突变数据训练一个模型,再让它推荐下一轮实验,是蛋白工程中的常见思路。但下一轮往往会故意走向新区域:改没试过的位置、叠加更多突变,甚至换一种蛋白骨架。在旧范围里预测得准,不代表离开这个范围后仍然可靠。
这篇预印本尝试给蛋白语言模型补充结构与共进化信息。它没有提出一个包打天下的新模型,而是比较:什么信息能帮助哪一种外推?结果最清楚的部分,是对未见突变位置的预测;同时,论文也留下了不少没有解决的难题。
● ● ● SOURCE · 原文信息
Generalizing Protein Fitness Prediction across Distribution Shifts via Structural and Co-evolutionary Priors
JOURNALbioRxiv
POSTED2026-10-07
https://doi.org/10.64898/2026.10.06.756934
ROUTE · 本文路线
01把结构模型的中间信息,接到功能预测上 METHOD
02跨位置预测变好了,但涨分不能全算给结构 BENCHMARK
03帮助来自空间关系,也来自进化留下的线索 EVIDENCE
04换蛋白、换性质之后,优势还剩多少 TRANSFER
05先问要跨过哪道边界,再决定加什么模型 LIMITS
01 METHOD
把结构模型的中间信息,接到功能预测上
这里的“适应度”是实验关注的性质,可以是酶活、稳定性、结合表现,甚至吸收波长,并非统一的“蛋白好坏分数”。研究主要借助 FLIP2 基准,把未知拆成不同类型:更多突变、不同位置、不同替换类型、更高性质值,以及未见过的野生型骨架。
方法分两路取信息。一路来自 ESM-C、ESM2 等蛋白语言模型,或额外读取结构的 SaProt、ProSST、ESM-3、多模态 DPLM-2;另一路来自 Protenix-v2 的主干网络,即生成最终结构之前的中间计算模块。
Protenix-v2 接收序列和多序列比对(MSA),产生单残基表征,以及描述残基两两关系的表征。可以理解为,它不仅看“这个位置是什么”,还保留“它与其他位置处在怎样的关系中”。这些关系同时受到共进化信息与结构学习目标的影响,不能直接等同于真实物理相互作用。
作者将两路表征汇总成固定长度向量,再交给小型多层感知机(MLP)预测实验分数。三个特征块概括整条蛋白,另六个聚焦突变位置及相关残基对;无法确定对应野生型和突变位置时,只使用全局信息。
编码器冻结,不代表无需训练。大模型参数不更新,但最后的预测头仍需实验标签来训练;训练集的均值和标准差也会用于特征标准化。

FIG 1序列与结构感知编码器提供一组表征,结构预测主干提供另一组;全局和突变位置特征经汇总后,由轻量预测头学习实验性质。
02 BENCHMARK
跨位置预测变好了,但涨分不能全算给结构
在淀粉酶任务中,“近到远”是用靠近活性位点的突变训练,再预测较远位置的突变;“远到近”则反过来。这比在相似突变之间随机切分,更接近模型帮助实验开拓新位置的要求。
主表里,ESM-3 加主干特征在近到远测试上的 Spearman 相关系数为 0.712,超过原基准报告的最佳值 0.617。这个指标衡量预测排序与实验排序是否一致,不是“71.2% 的预测正确”。主表多数列的最佳配置超过既有基线,但每列冠军并非同一个模型。

TABLE 1不同蛋白与分布偏移下的排序表现。主干特征在淀粉酶位置外推中收益明显,但部分跨骨架任务下降,各列最佳结果来自不同配置。
不过,主表的纯语言模型使用未标准化特征,融合模型使用标准化特征,两个因素同时变化。标准化就是把不同维度调整到可比较的数值尺度,避免某一路仅因数值大而主导训练。
补表给出了更接近同条件的对照:同样标准化后,ESM-C 在近到远任务中从 0.481 升至 0.698。主干信息的收益仍在,但比直接拿主表 0.289 与 0.698 比较要小。因此,主表的全部差值不能直接解释成结构信息的净贡献。
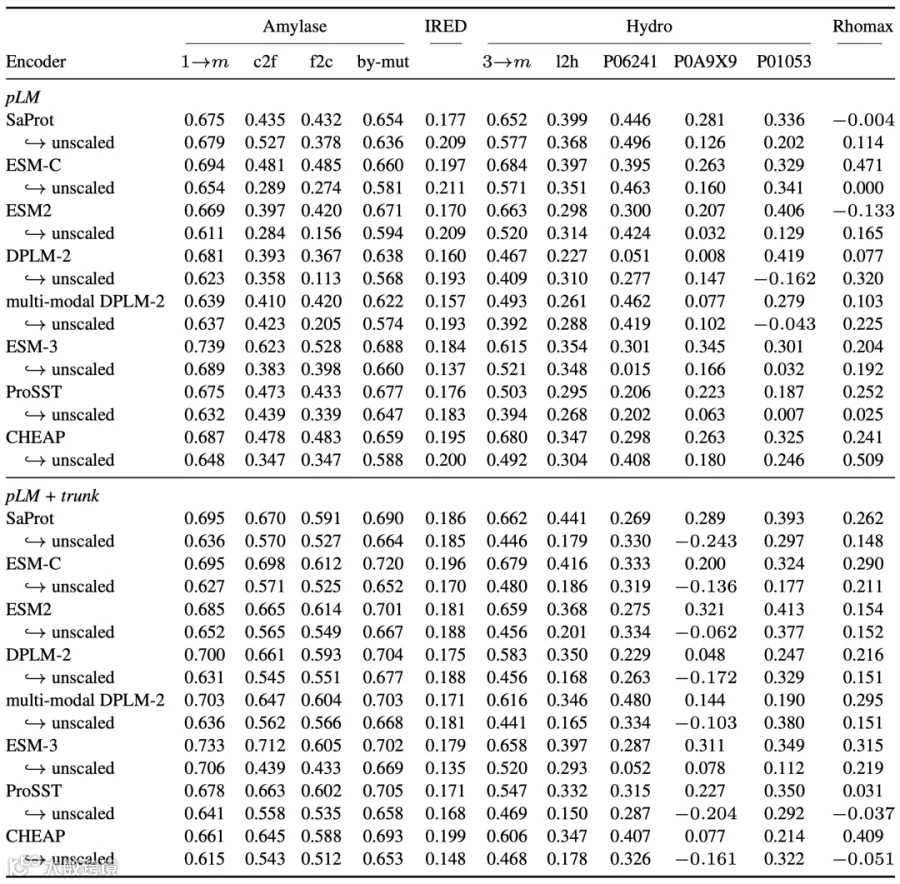
TABLE C6 标准化本身也会改变预测表现。将相同预处理条件下的语言模型与融合模型比较,才能更清楚判断新增主干特征带来的收益。
另一个问题是:模型只是更会拟合旧范围,还是确实更能走出去?作者分别测试同分布和分布外样本。在淀粉酶近到远任务中,加主干后的平均收益为同分布+0.073、分布外+0.282;远到近也有类似差异。这支持位置外推受益,但其他任务并不遵循同一趋势。

TABLE 2同分布与分布外收益并列比较。淀粉酶位置测试的外推收益更大,而更多突变或跨野生型任务未呈现一致趋势。
03 EVIDENCE
帮助来自空间关系,也来自进化留下的线索
结构预测网络读取了 MSA,那么收益会不会主要来自进化信息,而不是结构本身?作者加入 MSA-Pairformer 作为对照:同样读取比对信息,但不以结构预测为训练目标。
在淀粉酶两个位置划分上,它获得的增益约相当于完整主干增益的 60%–70%;剩余差异与主干提供额外几何上下文的解释相容。不过,两种网络及训练方式不同,这只是对照证据,不能严格分账为“七成进化、三成结构”。在单突变到多突变任务中,MSA 对照甚至优于主干。

TABLE 4使用相同比对信息的对照能取得相当部分位置外推收益,完整主干仍有额外优势;但增益比例不是结构与进化贡献的严格因果分解。
还有一个实用设计:不要把所有残基简单平均。明确告诉预测器“改动发生在哪里”,可以保留与本次突变直接相关的信息。在淀粉酶近到远对照中,全局三块特征得到 0.552,加入突变相关信息的九块特征达到 0.670。这也解释了为何同一套输入不能原样迁移到缺少参照野生型的任务。
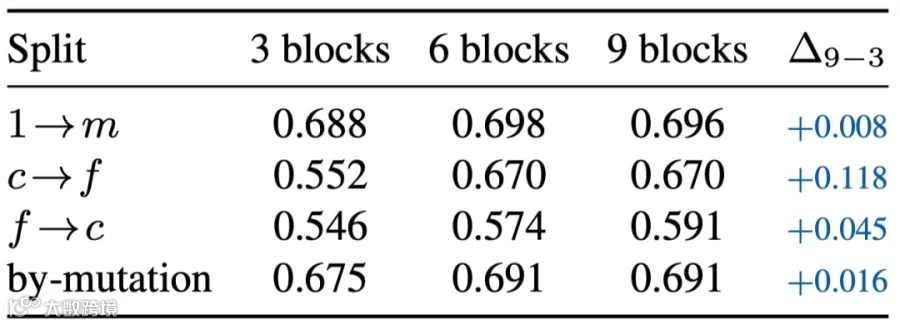
TABLE 5全局、突变相关及两者合并的特征比较。显式利用突变位置对近到远外推帮助较大,但在其他划分上的收益较小。
04 TRANSFER
换蛋白、换性质之后,优势还剩多少
淀粉酶上的规律并不能照搬。在仅使用原训练集 10% 的 TrpB 子集上,加入主干让 SaProt 从 0.236 升至 0.319,却让 ESM-C 从 0.332 降至 0.280。换一种编码器,增加同一类信息也可能起反作用。
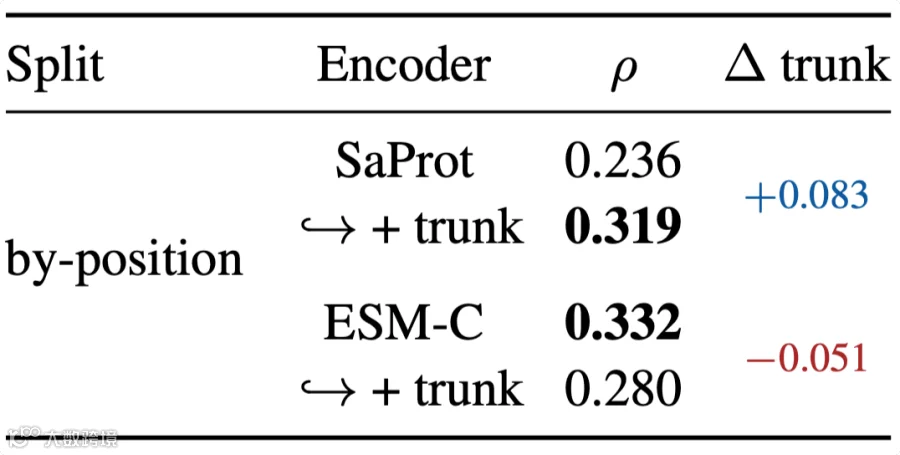
TABLE 3在下采样后的 TrpB 位置测试中,主干增强了 SaProt,却降低 ESM-C 的表现,说明新增信息的价值取决于原有表征与具体任务。
稳定性测试也体现了这种边界。用 Megascale 训练、在 FireProt 无同源重叠测试集评估时,ProSST 加主干的相关系数从 0.399 升至 0.590,但仍低于专门预测稳定性的 ThermoMPNN 所获 0.650。增加多模态信息有帮助,不等于击败任务专用模型。

FIG 2FireProt 同时比较排序相关性与预测误差。ProSST 加入主干后明显改善,但两项指标仍未超过专门的稳定性模型 ThermoMPNN。
更难的是预测天然进化中未有的新功能。原图有三个案例,不能把其中一个结果当成总体表现:在 12 个磷酸三酯酶变体上,SaProt 加主干后从 0.17 升至 0.35;ESM-3 从−0.60 改善到−0.15,仍是负相关。另一个只有 5 个变体的 P450 案例中,两种模型加主干后反而更差。
所以,这组小样本测试支持的是“部分案例得到缓解”,并未证明模型已经能可靠评估全新功能,更没有前瞻湿实验验证设计命中率。
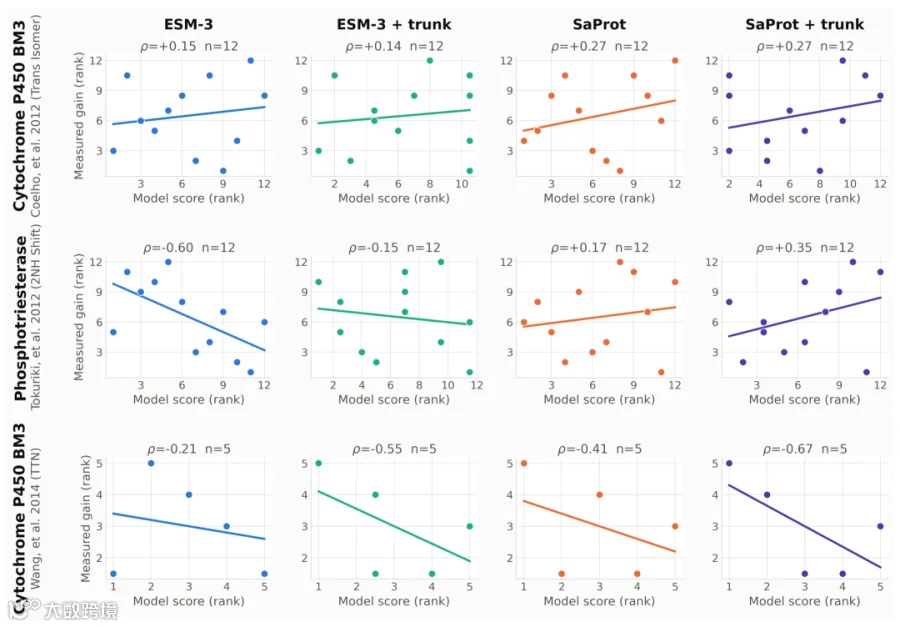
FIG 3三个新功能案例的排序散点图呈现不同结果:磷酸三酯酶有改善,另一个 P450 案例却下降,小样本外推仍不稳定。
05 LIMITS
先问要跨过哪道边界,再决定加什么模型
这项研究提供的更像一份选型思路:探索同一蛋白的新突变位置时,主干关系表征值得测试;跨骨架时,结构感知表征可能有帮助,但追加主干未必获益;面对新功能,任何高分都仍需谨慎验证。IRED 等任务上的低相关性,也说明现有表征没有捕捉到所有必要信息。
“轻量”主要指最后的预测头,不是整条流程便宜。逐个变体提取 Protenix-v2 表征成本较高。附录的淀粉酶对照提示,复用野生型主干与逐个重算的差异很小,为降低成本提供了线索,但尚不能推广到所有蛋白。
论文当前为预印本,作者表示将在接收后发布代码与结果,所给 PDF 未提供仓库链接。对实验决策而言,最有价值的提醒是:不要只问榜单分数有多高,先问测试集里的“未知”,是不是下一轮实验真正面对的未知。
● ● ●
END
#蛋白功能预测 #分布外泛化 #结构表征 #共进化 #BioAIDesign