同一个问题问DeepSeek,有时候答得头头是道,有时候却像换了个人,答非所问?听不懂说什么

不少人以为是服务器太忙,或者自己运气不好。
字节Seed团队最近的一篇论文提到,发现了deepseek“抽风”的原因。
一道代码题,答案反复横跳
字节Seed的研究人员做了个实验。
他们从DeepSeek-V4的官方推理代码里截了一段FP8量化函数,让模型补全最后一个Token。正确答案是8,但模型有时候偏偏说32。
按理说这也不稀奇,模型偶尔犯错很正常。但研究人员觉得不对劲,开始排查原因。他们在代码前面加了一段毫无意义的文档字符串,里面放了一排等号,然后调整等号的数量。
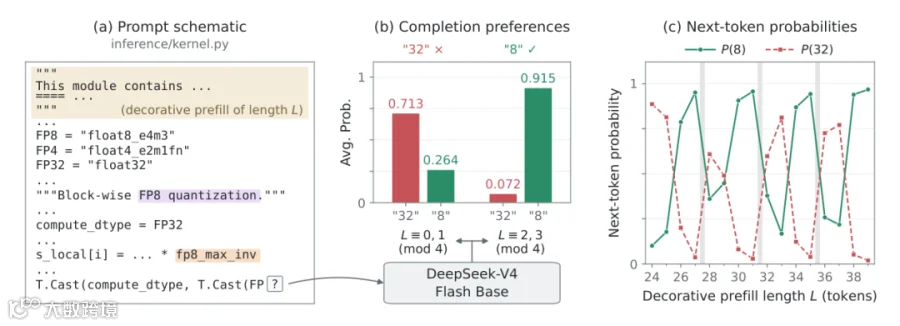
代码一个字没改,要补全的位置没改,正确答案当然也没改。唯一变的,就是前面多了几个等号。

结果,DeepSeek的答案开始反复横跳:当填充长度落在某些位置时,模型倾向于回答错误的32;往前挪一两个Token,又开始答对;再挪,错误答案又回来了——整个过程以4个Token为周期重复。
大海捞针,准确率能差40%
单一个代码案例还不够有说服力。
研究团队接着做了长上下文检索的经典测试——“大海捞针”,他们构造了一段长达128K Token的上下文,里面塞了约1.6万个键值对,然后让模型从中找出指定Key对应的Value。

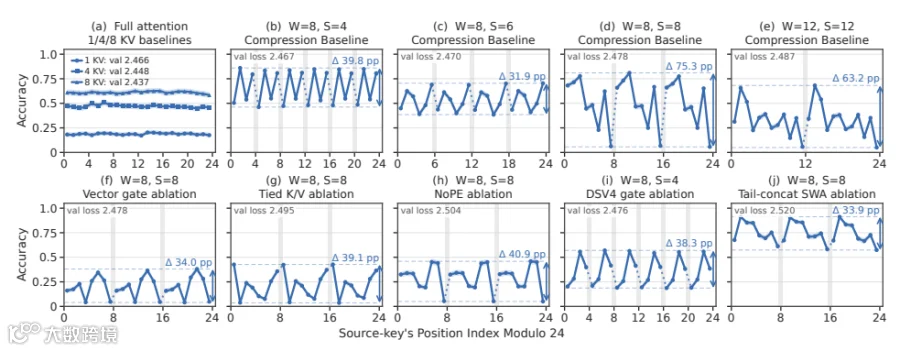
键值关系不变、问题不变、上下文长度也不变,研究人员只调整目标信息相对于压缩窗口边界的位置。

结果,DeepSeek-V4系列的准确率曲线呈现出明显的周期性起伏。DeepSeek-V4-Flash-Base在不同位置之间的最大准确率差距达到40.2个百分点,DeepSeek-V4-Pro-Base也达到34.8个百分点。

压缩了上下文,但埋了个雷
问题的根源,出在一种叫“分块KV缓存压缩”的技术上。
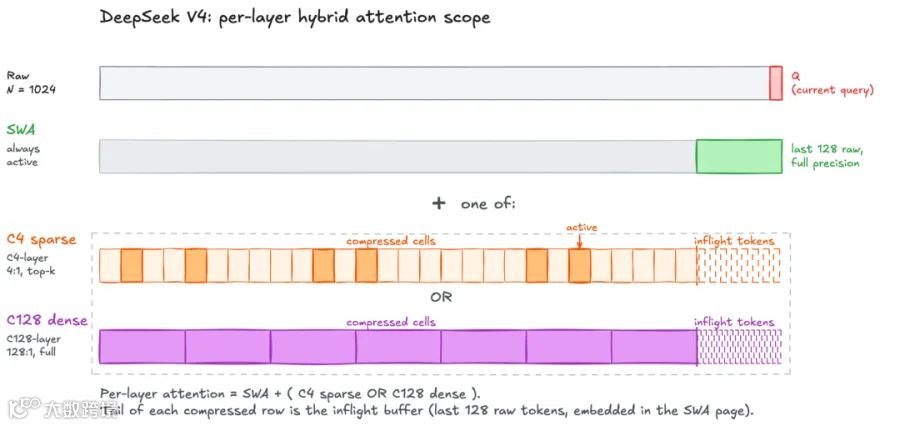
大模型处理长上下文时,需要保存大量历史Token的Key和Value信息供后续注意力计算使用。
打个比方,就像把一本厚书每页的内容摘要压缩到半页纸——省了空间,但细节精度有损失。

模型在不同相位下的检索能力存在系统性不对称,同样的信息,落在“幸运相位”时检索几乎不出错,落在“倒霉相位”时就像失忆了一样。#deepseeek