

今天凌晨,纳德拉发了一条帖子。我看完第一反应是:微软怎么发了个这么“不起眼”的模型?
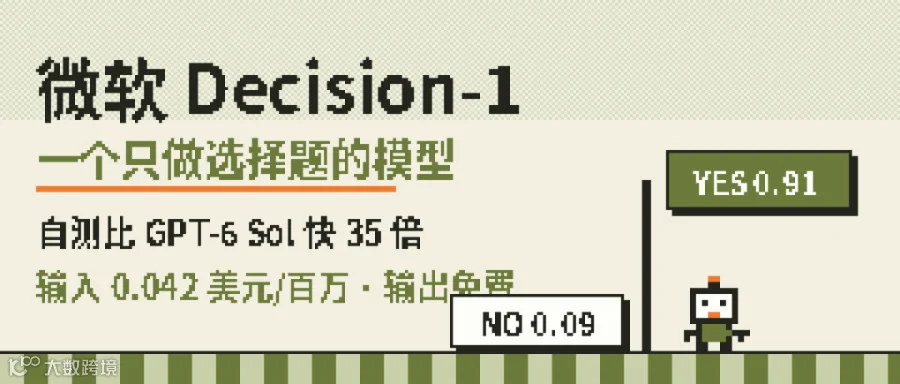
它叫 Microsoft-Decision-1。不聊天,不写代码,也不生成图片,只干一件事:给它一道题和几个固定选项,它给每个选项打一个概率。说白了,就是一个专门做选择题的模型。
帖子发出几个小时,浏览就过了 60 万,6000 多人点赞,2100 多人收藏。我把发布说明和几家报道对着看了一遍,越看越觉得,这东西比名字有意思得多。
01
PART
它到底干什么
WHAT IT DOES
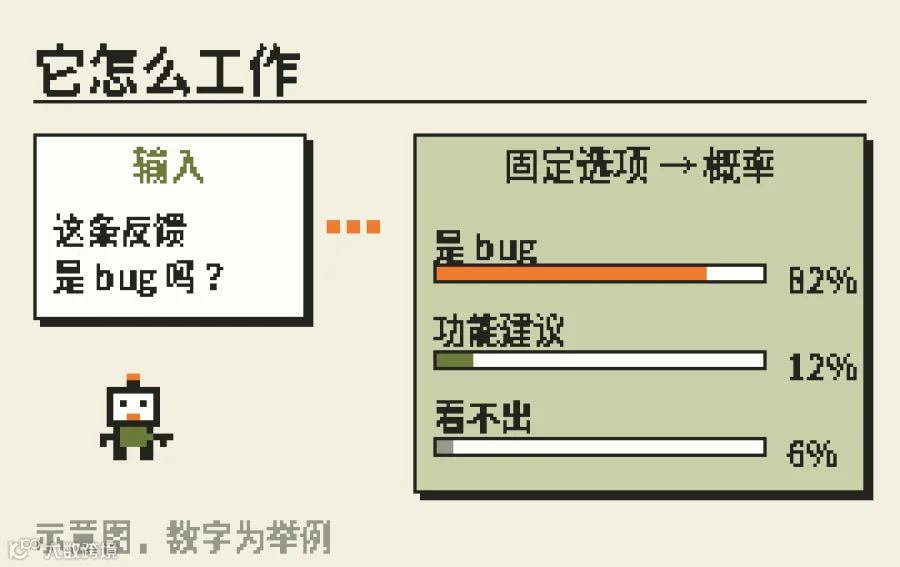
普通大模型回答问题,是一个字一个字往外写。你问“这条用户反馈是不是 bug”,它可能先铺垫两句,再给结论,程序还得从一段话里把答案抠出来。
Decision-1 的做法是:选项你先定好,比如“是 bug / 功能建议 / 看不出”,它一次前向计算就给每个选项一个校准过的概率。支持是非题、多选题、打分,还能按评分细则给 AI 的回答和 Agent 的动作打分。
底座有点意思:它是在阿里的 Qwen3.5-9B 上做后训练得来的,微软说之后还会换到自家 MAI 和 OpenAI 的模型上。一个 9B 的开源底座,被微软拿来做成了正式产品,开源模型的价值又被证明了一次。
9B
底座参数
0.042$
每百万输入
0$
输出费用
02
PART
快 35 倍,是怎么比出来的
BENCHMARKS

微软给的成绩单:在 36 个测试集、将近 15 万道训练时没见过的题上,它的准确率在参比模型里最高;延迟中位数比第二名 Quyet-1.0-Large 快 4.5 倍,比 GPT-6 Sol 快 35 倍。
我更在意的是稳定性这一项。同一个问题换 8 种问法,它平均只有 1.3% 的时候改了答案;把选项描述换个说法、把选项顺序倒过来或打乱,答案一次都没变。用过大模型做分类的人都知道,选项一换顺序结论就跟着变,是很头疼的事。
内部试用的例子也挺实在。Xbox 研究团队用它给 1 万多条玩家反馈打标签,质量和 GPT-6 Sol 差不多,速度快 14 倍以上,成本低 200 倍。Copilot 团队拿它评估 AI 回答,效果和 GPT-5.6 Luna 接近,速度快了约 100 倍。
不过冷水也得泼:这些数字全是微软自己测的。已经有媒体指出,公告没给出完整的数据集和延迟测试条件,外人暂时没法复现。“比 GPT-6 Sol 快 35 倍”这句话也要看清楚,拿一个专门打分的小模型去比一个写长文的大模型,快是意料之中的,真正要看的是准不准。
03
PART
一个月,冒出一串“决策模型”
THE WAVE

如果只有微软在做,这事可能就是个小产品。但把时间线拉出来看,就不一样了。
TIMELINE
OpenAI 的 Decisions API 用的是 GPT-6 Luna,每百万输入 0.10 美元,输出同样不收费;微软这次直接报到 0.042 美元。同一周,还有团队开源了 4B 的 cribl-decision-1.0,Nace AI 开源了不到 10B 的 Drex 1.5,都能本地跑。
X 上有人一句话总结:决策模型正在批量出现。也有人调侃,Decision-1 的第一个任务,应该是给自己挑个好点的名字。
04
PART
对做应用的人意味着什么
WHY IT MATTERS
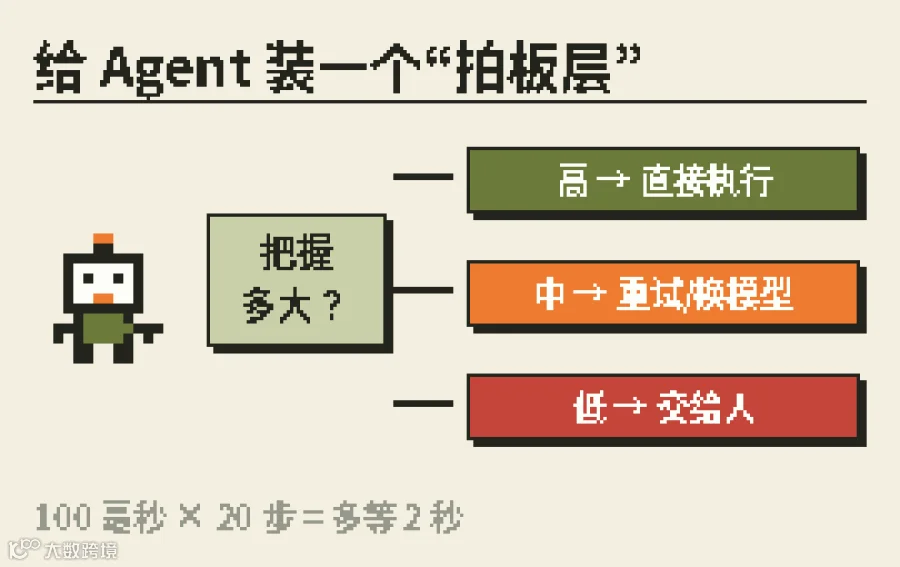
我觉得这才是重点。现在的 Agent 要连着做很多小判断:这条消息该交给谁、这一步做完了没有、这个回答合不合格。每个判断都去问一遍大模型,又慢又贵。
发布说明里算过一笔账:每个判断多 100 毫秒,连着 20 个判断,整个流程就多等 2 秒。决策模型的思路是把“拍板”这件事单独拎出来,用小模型快速出结论,再按把握大小决定下一步:把握高就直接执行,一般就重试或换个模型,把握低就交给人。
这个分工我很喜欢。大模型负责想和写,小模型负责快速判断,能省下的不只是钱,还有用户等待的那几秒。如果你在做客服分流、内容审核、工单分类,或者给自己的 Agent 加检查点,值得拿真实数据测一测。
要注意的地方也很明确:现在只在微软 Foundry 上能用,OpenRouter 说是很快接入;概率准不准,得拿自己的标注数据校一遍,不能直接信成绩单。要求数据不出本地的,可以先看那几个开源的小模型。
ONE MORE THING
模型越来越大的时候,有人开始把一件小事做到极致。我挺期待这条路线,但前提是有第三方把成绩单重新测一遍。
你手上有哪些活,适合交给这种只做选择题的模型?评论区聊聊。
往期 · 接着看
Step 5:600B 只激活 27B
最近刷屏的 AI 模型,到底哪些是真有用,哪些只是热闹?
信息来源:Satya Nadella 与微软官方 X 账号、微软 Foundry 发布说明及 TestingCatalog、Windows Report 等报道、OpenAI Decisions API 公开信息、X 用户公开讨论。
觉得有用的话,点个赞或在看,我们下篇见
THANKS FOR READING