


题目:DiffusionNFT: Online Diffusion Reinforcement with Forward Process
论文地址:https://arxiv.org/pdf/2509.16117

创新点
•全新前向过程在线强化学习范式:现有 GRPO 类扩散 RL 需要在反向采样轨迹上优化,受求解器限制、存在前向反向不一致问题;DiffusionNFT 基于流匹配,直接在扩散前向过程做 RL 优化,不再把图像生成看成多步马尔可夫决策过程,规避似然难以计算的难题。
•正负样本对比的隐式策略提升:利用高分正样本、低分负样本之间的差异定义隐式策略更新方向,把强化信号嵌入监督式流匹配损失,不需要价值网络、不用估计似然;仅需要最终干净图像 + 奖励,不需要保存完整反向采样中间轨迹,大幅节省显存与计算开销。
方法
本文构建了基于扩散前向过程的在线强化学习框架,依托流匹配范式,不再在反向采样轨迹上执行强化学习优化,直接利用扩散前向加噪过程完成策略更新,该方法不需要价值网络,也无需估计轨迹似然,仅依靠最终生成图像对应的奖励信号,通过正负样本之间的奖励差异构造隐式梯度,并将强化学习的奖励信号嵌入流匹配监督损失之中,训练时不需要存储反向采样的全部中间轨迹,大幅降低显存消耗,同时该框架与各类 ODE 或 SDE 黑盒采样求解器解耦,训练阶段不依赖 CFG 引导,推理阶段也可舍弃 CFG,在 SD3.5-Medium 基础模型上执行多奖励模型联合微调,通过前向过程的梯度更新持续优化图像生成策略,最终在图像生成评测基准上实现图像质量提升,同时达成远高于 FlowGRPO 的训练效率。
DiffusionNFT 与基线模型的训练效率及多维度生成质量对比
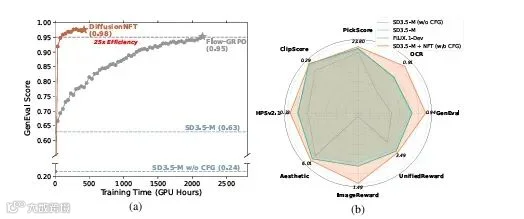
本图子图 (a) 为 GenEval 分数随 GPU 训练时长变化的收敛曲线,横轴代表训练 GPU 小时数,纵轴为 GenEval 评分,原始 SD3.5-M 与无 CFG 的 SD3.5-M 基线分数较低,Flow-GRPO 需要大量训练耗时才能缓慢收敛至 0.95,而 DiffusionNFT 仅消耗极少训练资源就能快速收敛到 0.98,直观体现其训练效率达到 Flow-GRPO 的 25 倍,子图 (b) 为雷达图,从 PickScore、OCR、GenEval、UnifiedReward、ImageReward、Aesthetic、MPSv2、CLIPScore 共八个指标维度,对比 SD3.5-M 无 CFG、SD3.5-M、FLUX.1-Dev 以及本文 SD3.5-M+NFT 无 CFG 模型,可见 DiffusionNFT 在绝大多数评价维度上均超过其他基线模型,综合图像生成能力更强,两张子图共同验证 DiffusionNFT 兼具超高训练效率与全面的图像生成性能提升。
DiffusionNFT 整体算法框架图
 本图以文本提示作为条件输入,由旧策略(\pi^{old})生成多张图像样本,使用奖励模型对图像打分得到取值区间在 0 到 1 之间的最优性奖励,随后对原始干净图像执行前向加噪获得带噪图像(x_t),同时送入待更新网络(v_\theta)与冻结的旧网络(v^{old}),基于参数(\beta)分别构造隐式正策略项与隐式负策略项,利用奖励权重r与(1-r)对两项流匹配损失加权,最小化整体损失J,引导模型在扩散前向过程学习向着高分样本的速度场靠拢、远离低分样本对应的速度场,全程无需存储反向采样轨迹,直接借助前向加噪过程完成带奖励信号的流匹配强化学习更新。
SD3.5-M、FlowGRPO 与 DiffusionNFT 的生成样例可视化对比

本图选取 5 组具有挑战性的文本提示,分别展示原始 SD3.5-M、FlowGRPO 以及 DiffusionNFT 三个模型的生成图像,对比可以发现基础 SD3.5-M 在部分提示词细节上存在瑕疵,FlowGRPO 能一定程度提升画面效果但仍存在物体形态、文字与细节匹配问题,DiffusionNFT 生成的图像在文本对齐、物体结构、细节还原与画面真实感上表现更优,能够更精准遵循提示词描述完成图像生成,直观验证 DiffusionNFT 经过强化学习微调后在文本到图像生成的细节遵循能力上优于基线模型与 FlowGRPO。
实验
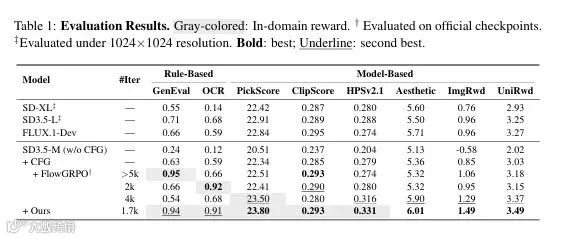
该表格在 1024×1024 分辨率下,采用 GenEval、OCR、PickScore、ClipScore、HPSv2.1、Aesthetic、ImgRwd、UniRwd 等多维度指标,对比 SD-XL、SD3.5-L、FLUX.1-Dev、SD3.5-M 有无 CFG、FlowGRPO 以及本文 DiffusionNFT 模型,粗体代表最优结果、下划线代表次优结果,灰色单元格为域内奖励指标,结果表明 DiffusionNFT 仅使用 1.7k 迭代,就在大部分评测指标上取得最优成绩,性能优于 FlowGRPO 与其他基线模型,证明该方法能用更少迭代步数获得更高的图文对齐能力、图像审美质量与综合生成效果。