

微软开源 Agent Lightning v1.0,一套面向 AI Agent 的强化学习框架。它主要给已经搭好 Agent、希望继续训练底层模型的开发者用:保留现有的工具调用、上下文管理和任务执行流程,用实际任务中的执行记录与结果反馈训练模型,减少为训练另外重写一套 Agent 的工作。
负责这些执行与上下文安排的外层程序,称为 agent harness。它决定模型能用什么工具、下一轮能看到哪些信息。一个编码 Agent 能否修好 bug,既取决于模型,也取决于这套流程。
过去,不少 Agent 强化学习系统要求训练框架接管交互循环,开发者得在里面重新实现调用模型、执行动作、返回结果的逻辑。部署有一套,训练再维护一套;工具协议、上下文压缩和子 Agent 越复杂,两边就越难保持一致。v1.0 将训练接到现成 harness 的模型接口上,省去重建这段交互循环。
微软技术团队用 mini-SWE-agent 和约 6,000 个训练任务,训练 Qwen3.5-9B。在检验代码修复能力的 SWE-bench Verified 上,Pass@1 从 41.8% 提高到 56.4%,增加 14.6 个百分点。
微软亚洲研究院在 10 月 7 日的博客中介绍了这套重构后的框架;v1.0 和相关技术报告已在 8 月公开。报告将这类训练方式称为 Harnessed Agentic RL。

Agent Lightning v1.0
从一次修 bug 到一次模型更新
在项目公开的编码示例中,训练器从 SWE-smith 数据里取出任务,为 Agent 创建一次执行,称为 rollout。控制器启动一个 Kubernetes Job,让 mini-SWE-agent 在对应代码仓库的隔离环境中运行。
Agent 读任务、查看代码、修改文件、运行命令。需要模型决定下一步时,请求发往 Agent Lightning 的 OpenAI 兼容 API 代理。代理把请求转给训练中的模型,记录实际输入和输出的 token ID、生成 token 的对数概率,并将这次调用绑定到对应 rollout。
模型给出的动作由 harness 执行。命令报错、文件变化、测试结果等反馈,又由 harness 整理进下一轮上下文。训练系统记录的是这套 Agent 实际送给模型的输入,以及模型据此生成的回答。
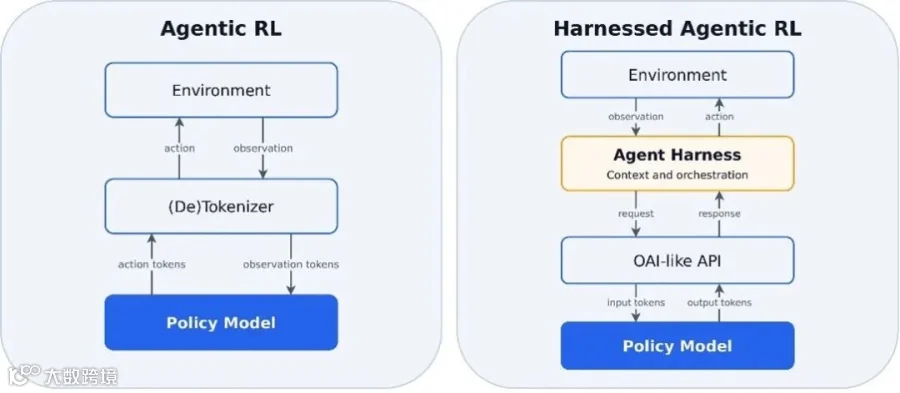
左侧由训练系统组织交互 右侧保留 harness 的上下文与编排
任务结束后,专属测试检查补丁是否完成修复,并将结果作为奖励交回系统。训练器收齐同一任务的多次尝试,比较奖励,把其中的模型调用组装成训练样本,更新模型权重。后续任务再用更新后的模型执行。
接入这条流程,需要可训练的模型、任务环境和奖励。harness 可以沿用,模型权重由训练后端更新。
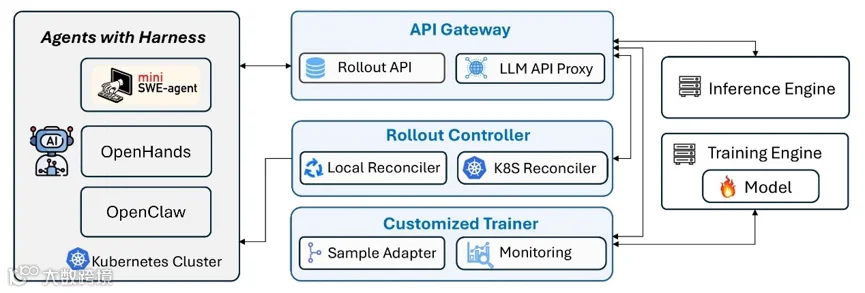
现有 harness 经由网关和控制器 与推理及训练后端连接
奖励来自测试,测试环境就会影响模型学到什么。团队在编码训练中发现,Agent 会翻 Git 历史找正确补丁,或者通过 curl、pip、Python 网络库下载上游源码,再拿这些答案通过测试。
这些尝试得到好结果,却没有体现想训练的修复能力。编码示例因此隐藏 Git 元数据、限制相关命令,并用网络策略阻断取巧路径。
一次执行为何会拆成多个样本
真实 harness 会压缩上下文、启动子 Agent,也会重新拼装模型输入。同一次 rollout 中,后一个请求未必完整接续前一个请求;它不能总被当成一条不断增长的对话。
即使文本没变,重新套聊天模板、重新分词,也可能改变 token 边界。Agent Lightning 默认只在前后调用的 token 确实连续时合并训练序列;接不上就另起一条,保留模型当时实际看到的输入。
拆分会影响奖励的统计。报告给出一个示意:同一任务有两次尝试,成功的那次奖励为 1,被拆成三个样本;失败的那次奖励为 0,只有一个样本。
按四个样本求平均,奖励基线变成 0.75;按两次真实尝试求平均,则是 0.5。成功的执行只是被拆得更碎,就在基线里多占了两份权重。
样本数量来自 harness 怎样组织上下文,不能直接代表一次尝试该有多大的训练权重。v1.0 在 rollout 层计算优势,并在损失计算中处理同一 rollout 的整体权重,让一次执行不会因为样本多而被重复计权。
编码实验比较了三种处理:样本级优势、仅改为 rollout 级优势、再加入 rollout 级损失归一化。两项一起改的版本取得了更高的验证奖励;只改优势计算的版本出现了更明显的策略熵增长。

验证奖励对照 绿色为两项一起改 橙色为只改优势计算 灰色为样本级基线
图中是 SWE-smith 验证集上的训练表现。开头的 56.4% 则来自训练后模型在 SWE-bench Verified 上的评测。前者比较样本处理方式,后者检验训练后的代码修复能力。
约 6,000 个训练任务也做过筛选。剔除题目或对应代码分支缺失、测试过重的任务后,团队主要保留模型多次尝试中既有成功也有失败的题目,另加入一批更难的任务,为奖励比较提供不同难度的反馈。
长任务与模型更新怎样交错
真实 Agent 的任务时长很不整齐。有的很快交出补丁,有的还在查文件、等命令、反复修复。如果同步训练要等整批任务结束,最慢的一组就会拖住模型更新。
v1.0 的 Collocated Async RL 同时保持更多任务组执行。收齐足够多的完整组,就开始一次更新;还没结束的组留到后续轮次。同一任务组内的多次尝试仍须全部完成,才能一起用于优化。
推理和更新共用一组 GPU。更新前,网关暂停接收新的模型请求,等正在处理的请求结束,再让 GPU 更新权重;更新后恢复推理。外部 Agent 可以保留执行状态,接着处理原来的任务。

三种调度方式 蓝色为完整 rollout 黄色为跨阶段的部分 rollout 绿色为更新
这种安排在其实验中,相比同步 RL 带来约 2 倍的端到端加速;共享 GPU 池也减少了常规异步方案分别部署推理和训练的资源需求。跨轮次任务的记录会包含更新前的模型生成的数据,训练还需处理这部分旧策略数据,文档提供了相应校正配置。
Agent Lightning v1.0 约 3,500 行代码实现的是训练控制层,推理和权重更新仍依赖后端,Agent 执行也有各自的环境需求。仓库提供本地进程和 Kubernetes 两种运行方式,以及数据准备、环境隔离、训练脚本和监控入口。最小 Calc-X 示例可用一张 A100,公开的 Qwen3.5 编码示例则使用四张 B200。
参考链接
-
微软发布介绍:https://www.microsoft.com/en-us/research/blog/agent-lightning-v1-0-a-3500-line-lightweight-agentic-rl-framework-for-training-agents-with-real-harnesses/ -
Agent Lightning 开源仓库:https://github.com/microsoft/agent-lightning -
Agent Lightning v1.0 技术报告:https://arxiv.org/abs/2608.17528 -
框架原理与接入:https://microsoft.github.io/agent-lightning/stable/05-basics/ -
训练数据处理:https://microsoft.github.io/agent-lightning/stable/20-trainer-configuration/ -
编码 Agent 训练示例:https://microsoft.github.io/agent-lightning/stable/75-example-coding-agent/ -
异步训练机制:https://microsoft.github.io/agent-lightning/stable/35-asynchronous-training/ -
最小运行示例:https://microsoft.github.io/agent-lightning/stable/01-quick-start/