

Baseten 工程师 Shawn Rushefsky 记录了一次让 Claude Code 持续优化推理引擎的实验:从 Qwen 的文本生成,到 SAM 的图像分割,他把目标、约束和测量方法交给 Agent,让它反复尝试。以下为全文翻译,文中的“我”和“我们”均指原作者及其团队。
借助 MetaInfer skills,搭载 Fable 5 的 Claude Code 在一张 B200 上构建了一个 Qwen 3.6 推理引擎:解码速度比 vLLM 最高快 90%,而 vLLM 的首 token 等待时间约是它的 2.3 倍。

用 Agent 优化推理引擎
在 Baseten,我们会建一些名字叫 #ai-papers-discuss 和 #model-performance-reading-group 的 Slack 频道。最近,我就在其中一个频道里看到了一篇引起我注意的论文:《MetaInfer: A Knowledge Only LLM Inference Engine Generator SKILL Toolbox》(MetaInfer:仅依靠知识的 LLM 推理引擎生成技能工具箱)。
论文作者提供了一个只靠 skills、从零构建定制推理引擎的框架。他们声称,在每个输出 token 的耗时(TPOT)等常见推理性能指标上,生成的引擎超过了 vLLM 这类当前最先进的开源方案。这里的“只靠 skills”,是指不对模型做后训练,也不使用专门的 harness。坦白说,我有些怀疑。不过,他们提供了包含这套技能工具的代码仓库,而且我们这里还过着 token 管够的好日子,于是我想,找个热门模型试一试,看看它究竟能做到什么程度。
我们在一张 B200 上,以 NVFP4 精度运行 Qwen-3.6-35B-A3B。LLM 生成的推理引擎,单流解码速度比 vLLM 0.25.1(实验时的最新版本)最高快了 90%;而 vLLM 的首 token 等待时间(TTFT)是它的 2.33 倍。这让这个模型可以用于一些此前并不现实的超低延迟场景。
AI 辅助推理优化正在兴起
眼下,几股大趋势正在汇合,为 MetaInfer 这样的发现和技术创造条件。
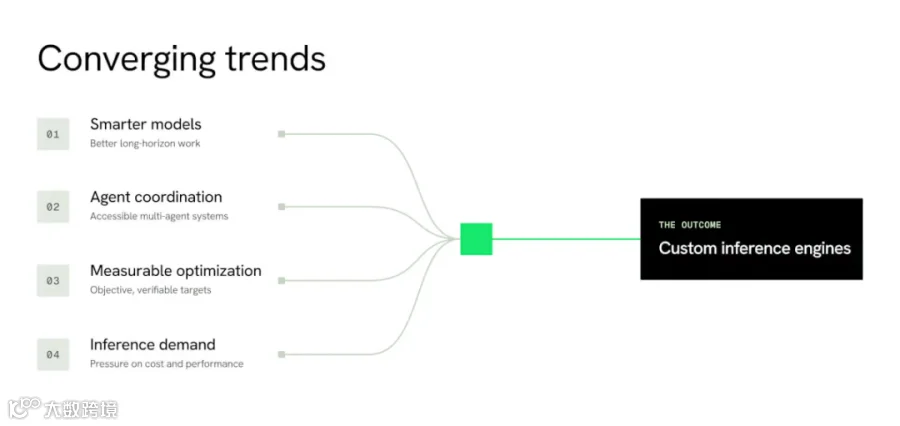
更聪明的模型、Agent 协作、可衡量的优化目标,以及推理需求,共同推动定制推理引擎的出现。
模型越来越聪明,也越来越擅长长程任务。Anthropic 发布 Mythos 5 和 Fable 5,意味着能够放心交给 AI 系统的任务又向前迈了一步。我记忆中,上一次出现这样的转折点,是 2025 年底 Opus 4.5 发布的时候。当时,许多工程师,包括我自己,都不再只是把 AI 编程工具当作加强版自动补全,而是开始把 Claude Code 这样的编程 harness 当作主要的工作入口。
与此同时,Agent 协作流程及其基础能力正在直接集成进主流 harness,让复杂的多 Agent 工作流更容易使用和管理。其中一个重要功能是“Goals”:Claude Code 和 Codex 都提供了它,让模型能够长时间围绕可衡量的目标持续工作,不偏离任务。我第一次接触这种“实验—测量—迭代”的循环,是大约半年前在 Karpathy 的 Autoresearch 项目里。如今,它已经成了常规编程 harness 的一部分。

Google 产品每月处理的 token:2024 年 5 月为 9.7 万亿,2025 年 5 月约 480 万亿,2026 年 5 月超过 3200 万亿。
AI 系统的能力不断提高,市场对推理服务的需求也随之增长,带来了持续改善成本和性能的巨大压力。
这些因素叠加起来,把明确的优化问题交给 LLM,让它们持续打磨解决方案,就越来越合理了。推理性能恰好很适合这种自动优化:问题可以用 TTFT、TPOT、每张芯片的吞吐量、所需内存等量化指标来定义。甚至正确性也可以通过与模型的全精度参考实现进行数值对比来验证,确保性能提升没有牺牲准确性。
这种客观可验证性,是自主优化能成功的关键。我们也知道,当前最先进的实际性能与理论性能极限之间,还存在巨大差距。此外,推理本身极其复杂,可探索的优化空间非常大,从底层 CUDA kernel 的编写,一直到动态批处理等服务层优化,都在其中。
约束解空间
LLM 或许很擅长解决定义明确的优化问题,但接下来的挑战,就变成了如何把你的问题定义成这样的优化问题。你需要把约束讲清楚,也需要谨慎选择优化目标。Agent 肯定会尝试钻规则的空子来“达标”,所以,工程师要把规则设计好,让 Agent 的成功确实符合自己的需要。举个例子,如果你没有设置保持准确性的约束,你的“模型”最后就会变成这样:
while True:
    yield "a"
如此简单的模型,TTFT 和 TPOT 分数都会好得难以置信,但它已经没有任何实际用处了。
vLLM、SGLang 和 TensorRT-LLM 等现有开源推理引擎,总体上做得很好:它们能够在各类加速器上服务大量不同模型,性能也能满足商业应用的要求。不过,通用性和易用性带来的好处也有代价:它们不会针对每一个特定的“模型+加速器+工作负载”组合做到极致优化。MetaInfer 的出发点是,对任何一个具体部署场景,高度专用、也就是受到明确约束的引擎,有机会超过这些通用引擎。
把 MetaInfer 用到生产应用中
在 MetaInfer 原论文里,作者让现成的 Agent 根据一套由规范和约束组成的知识库来构建推理引擎,不允许它们直接访问开源引擎的源代码。这些源代码很可能出现在模型的训练数据里,但 Agent 无法直接读取源码文件。工作过程中,Agent 会不断扩充知识库,主动发现缺口,再通过结构化实验和验证把这些缺口补上。
论文作者对实验纯粹性的追求很值得敬佩,也很有意思,但在 Baseten,我们更看重最终结果。我允许自己的 Agent 在需要时参考当前最先进的开源方案,包括从 vLLM 和 TensorRT-LLM 中寻找已经优化好的 kernel,只有找不到合适实现时才自己写。另外,原论文只关注推理引擎这一部分,我则把范围扩大到了完整的服务栈:最终在负载均衡器后部署多副本服务,用 AIPerf 产生负载并测量性能。
无论是原论文,还是我的扩展实验,最终都有两份交付物:推理引擎本身,以及可供后续运行复用的知识库扩展。
第一个实验:Qwen-3.6-35B-A3B 推理
实验设置
启动实验时,我让搭载 Fable 5 的 Claude Code 读取论文和 MetaInfer 仓库,并允许它通过 SSH 访问一台 NVIDIA B200 工作站。我告诉它目标硬件是什么,提供了两个 Hugging Face 仓库链接:一个是我想使用的 Qwen-3.6-35B-A3B NVFP4 量化权重,另一个是原始全精度权重,用来校验准确性。Agent 还可以把候选引擎部署到 Baseten,并对部署后的端点运行 AIPerf 性能测试。
我们内部有一些 Agent skills 和 MCP 工具,能够完成所需的 Baseten 交互,Agent 也有权使用它们。我设置了一条 /goal:在相对于 NVFP4 基线不损失准确性的前提下,在所有性能指标上超过 vLLM 20%。
最终结果,以及整个过程只需要这么少的人工介入,都让我惊喜。Claude 在这个项目上基本自主工作了约一周。我偶尔引导一下,避免它过度纠结于某一种请求负载模式,并让它始终关注生产推理性能,而不是只盯着孤立的引擎基准测试。MetaInfer 框架设置了一系列不可修改的验收关卡和检查,使这种长时间持续工作能够有效推进。
Claude 会不时停下来,请我批准那些会让准确性发生变化的改动。最后,我允许它的输出与 NVFP4 参考实现存在细微的数值差异,但前提是,以 BF16 基线为参照衡量时,整体准确性至少不变差。
实验结果
在 Agent 协作和上下文管理方面,我几乎没做什么手动管理。唯一比较明确的要求是:早期使用较小模型的结果让人失望,所以我要求所有子 Agent 都使用 Fable 5。整个过程中,它多次自动压缩上下文,消耗了约 17 亿个 token,其中绝大多数是缓存输入 token,另用了约 200 个 B200 GPU 小时。其实它很快就追平了 vLLM,在最初几天内就做到了;不过,出于做实验的好奇,我让它继续优化下去。
最终,这个名为 VibeQwen 的生成引擎,在所有测试过的负载模式下都超过了 vLLM,其中一些场景的差距相当大。在单张 B200 的直接对比中,对适合推测解码的文本——也就是重复性强、结构规整的文本——VibeQwen 的单流解码速度达到每秒 1,792 个 token,而经过充分调优的 vLLM 部署为每秒 943 个 token,提升了 90%。在测试语料上,VibeQwen 用 12 毫秒返回首个 token,vLLM 则需要 28 毫秒,vLLM 的等待时间约是前者的 2.3 倍。并发数为 32 时,VibeQwen 的单副本输出吞吐量为每秒 10,307 个 token,vLLM 为每秒 6,030 个 token,前者高出 71%。
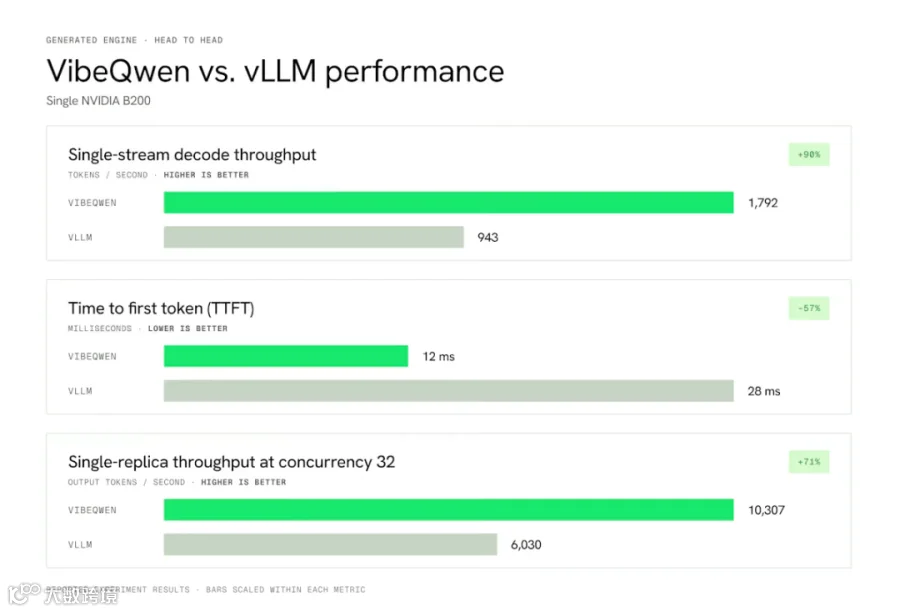
单张 B200 上的三项对照:单流解码每秒 1,792 对 943 个 token;首 token 等待时间 12 对 28 毫秒;并发 32 时,单副本每秒输出 10,307 对 6,030 个 token。
第二个实验:用 SAM 3.1 做图像分割
第一个实验的结果很鼓舞人,所以我决定把 VibeQwen 实验中新扩充的知识库,用到另一个类型完全不同的模型上。这一次,我想为 SAM 3.1 构建一个优化过的推理服务。SAM 3.1 是一个当前最先进的图像分割模型。
这次,我以 Facebook 的参考服务作为基线。虽然模型架构和模态完全不同,这套流程依然表现很好:仅用了几天、约 2 亿个 token,我们就在一张 H100 上实现了每秒处理 91 张图像,比基线的吞吐量高出 50%。
第二个实验叫 Sammie,比最初的 VibeQwen 项目更快,成本也更低。不过,由于两个实验的模型架构和加速器类型不同,又没有做对照实验,它只能提示知识库复用可能有价值,还不能提供确定的证据。

Sammie 的分割示例:输入图像与“水瓶”“椅子”“人”等文本提示,得到对应物体的分割掩码。
走向自主推理优化
VibeQwen 和 Sammie 目前仍然是实验项目,都还没有承接生产流量,但相对于当前最先进基线的性能提升相当显著。它们完成得也很快,只用了几天;人工投入很少,只有几小时;成本也足够低,Sammie 为数百美元,VibeQwen 为数千美元。对于那些每年在推理上花费数千万、甚至数亿美元的公司来说,这很有吸引力。在如此大的规模下,哪怕只有个位数百分比的提升,也可能省下数百万美元,足以让这笔投入显得划算。
AI 能够在优化问题上创造价值的空间非常大。正如我们已经看到的,AI 系统自身就是这类自主优化的理想对象。随着推理系统效率提高,以及越来越多模型达到完成这类任务所需的智能水平,优化的成本还会继续下降。
VibeQwen 和 Sammie 是我们在 7 月下旬用 Fable 5 构建的。现在已经是 10 月,开源前沿模型几乎追了上来,Kimi K3、GLM-5.3 等模型在许多基准测试上的得分,已经非常接近最好的闭源模型。模型越来越聪明,推理成本不断下降,可复用知识库又带来了效率提升。在这些因素共同推动下,不难想象,在不太遥远的将来,这类优化会变得足够便宜、足够可靠,成为模型部署生命周期里的标准环节。
我们正在招聘
加入我们,一起为生产级 AI 构建推理平台。
参考链接
-
原文:https://www.baseten.co/blog/agentic-inference-optimization-faster-than-sota/ -
MetaInfer 论文:https://arxiv.org/abs/2607.12875v1 -
Karpathy 的 Autoresearch 项目:https://github.com/karpathy/autoresearch -
实际推理性能与理论上限的研究:https://arxiv.org/pdf/2606.26383 -
AIPerf 性能测试工具:https://github.com/ai-dynamo/aiperf -
MetaInfer 代码仓库:https://github.com/HuangPuStar/MetaInfer -
Qwen-3.6-35B-A3B 的 NVFP4 量化权重:https://huggingface.co/nvidia/Qwen3.6-35B-A3B-NVFP4 -
Qwen-3.6-35B-A3B 原始全精度权重:https://huggingface.co/Qwen/Qwen3.6-35B-A3B -
SAM 3.1 模型:https://huggingface.co/facebook/sam3.1 -
Facebook 的 SAM 参考实现:https://github.com/facebookresearch/sam3 -
Baseten 上的 Kimi K3:https://www.baseten.co/library/kimi-k3/ -
Baseten 上的 GLM-5.3:https://www.baseten.co/library/glm-53/ -
Baseten 招聘:https://www.baseten.co/resources/careers/