编辑 / Jeffie
编辑 / Jeffie
一个厨房里的日常场景,或许比任何实验室数据都更能说明当前具身智能的困境:一个人正在煮鸡蛋,左手倒着牛奶,右手同时去拿面包。视觉该盯住哪只手?如果视觉跟着右手去找面包,左手凭借什么还能准确地把牛奶倒进杯子?答案藏在人的耳朵和手腕里——听着水声判断倒没倒满,感受腕部的力觉变化确认重量,视觉可以暂时离开,任务却不会中断。
近日,在由荣格工业传媒主办的“人形机器人产业链协同峰会”上,清华大学赵明国教授从这个场景切入,提出了一个与主流VLA(视觉-语言-动作)路线不尽相同的思考:人脑处理多任务的方式,或许能为具身智能打开另一条技术路径。本期会客室,我们通过整理赵明国教授在脑启发多传感器多任务操作与机器人足球方面的研究实践,探讨“仿脑”能否成为具身智能的第三条路线,希望能为读者带来一些新的思考。
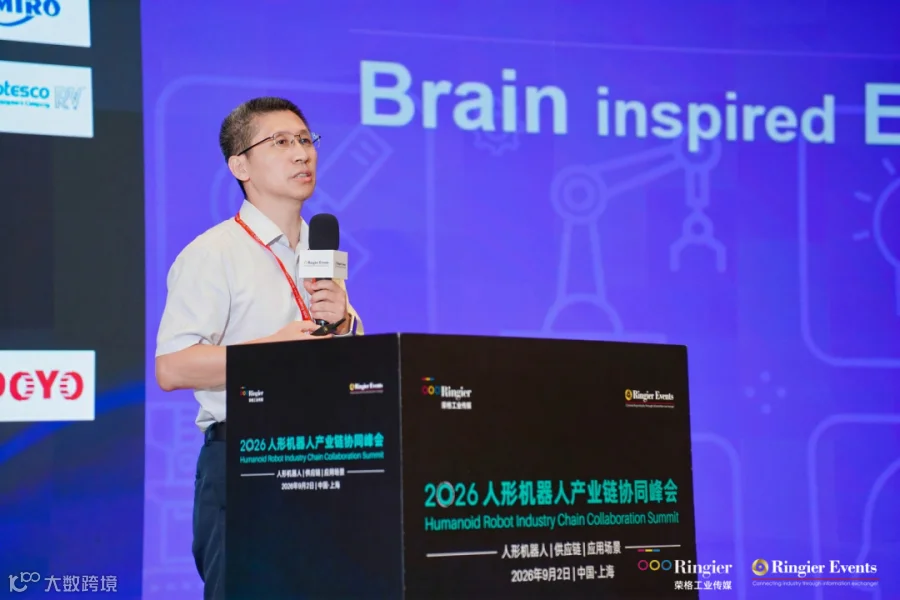
清华大学赵明国教授
Part 1
多模态操作:人脑的调度逻辑
当前人形机器人具身智能主流路线 VLA、WAM(世界动作模型) 几乎都是以视觉为核心感知输入,感知与控制解耦,难以应对真实场景中的噪声、延迟与遮挡,动态任务稳定性不足。相比之下,人类操作依赖本体感、视觉、触觉与听觉等多模态信号的巧妙处理,感知与动作端到端耦合。
他举了一个简单的例子:从衣服兜里掏房卡,人几乎不需要视觉参与;把遥控器放在桌上,更多靠的是触觉和力觉,而非盯着看。“视觉只是我们最重要的一个感知来源,但它并不是全部。”赵明国教授指出,人的多传感器系统并非因为某个任务特别难才需要这么多感觉,而是因为人要同时完成很多任务,不同传感器在不同任务上各司其职。
这就引出了一个关键的技术分歧:如果将多传感器信号硬编码到同一个表达空间,本质上等于把多个传感器压缩成一个更宽的传感器。而赵明国教授团队的做法不同,其团队提出“借鉴人脑多模态感知处理机制,构建感知-操作端到端一体化系统”来突破视觉主导范式局限性并实现对环境的高度适应性。这样的做法可以让传感器在不同任务之间动态分配、灵活调换。
为了验证这一思路,团队设计了一个双手机器人实验:左手倒水,右手同时去拿另一个杯子。视觉附加在左手上时,右手没有视觉;视觉跟着右手走,左手就失去了视觉。在这个刻意制造的“视觉不可能同时覆盖两个任务”的场景中,机器人依靠腕部力觉和听觉传感器,仍然完成了倒水任务。“当左手倒水的时候,视觉、力觉和听觉都附加在这个任务上;当视觉跟着右手走了,左手靠听觉和力觉仍然能够完成。这是我们的生活经验。”赵明国教授表示道。
据介绍,团队进行了近200组实验,设置了44种干扰条件,包括遮挡视觉、长时间遮挡、声音干扰等。统计结果给出了一个耐人寻味的排序:全模态感知、全模态操作效果最好;全模态感知、单模态操作其次;单模态感知、单模态操作效果最差。赵明国教授特别解释了第二个结论的深意:“就像后天失明的人和先天盲人不一样。后天失明的人对世界有过完整的认知,局部观测受限时,他仍然能调动已有的理解去完成任务。”
实验还带来了一个额外的发现:多模态并行不仅提升了鲁棒性,还显著提高了效率。在双手交叠操作的对比实验中,允许传感器动态调度的方案比纯视觉方案节约了约30%的时间。“能够并行的全部并行,能够一起做的全部放在一起做,效率就特别高了。”
赵明国教授强调,这条路线与VLA并不矛盾。“VLA是把单一视觉的能力发挥到极致,我们是在另一个维度上增加对世界的理解。这两个任务可以叠加在一起做,互相也不冲突。”但他也直言:“仅靠视觉去理解世界,显然是不够的。”
Part 2
机器人踢足球:从模块化流水线到反应式决策
如果说多传感器操作解决的是“手”的问题,那么机器人踢足球则是“腿”的具身智能。赵明国教授选择足球作为研究载体,背后有一个清晰的判断:静态博弈已被AlphaGo证明,动态对抗才是下一个标准问题。
机器人足球被视为检验人工智能在动态、多代理、高对抗环境下综合能力的终极挑战之一。传统方法采用“视觉-定位-决策-规划”的分模块线性流程,导致响应缓慢且难以适应高动态变化。“设计机器人踢足球,如果在这个任务上能战胜人类,大概标志着人工智能达到一个新的高度。”他提到,机器人足球世界杯设定了2050年机器人足球队战胜人类的目标,这个时间跨度本身就说明问题的难度。
转折出现在2024年。Alpha Go背后的公司用纯强化学习在一个小机器人上取得了突破性结果,这对赵明国团队触动很大。他们面临一个路线选择:继续沿着传统模块化的线性发展曲线,还是切换到强化学习驱动的指数型增长曲线?
2025年,团队完成了四项核心工作:让机器人去掉身后的人为保护、能够摔倒后自己爬起来、能够抗冲撞、实现全自主的反应式决策。相关成果于2026年8月发表于Science Robotics,论文提出了一套将真机视觉不确定性直接纳入强化学习训练回路的学习框架。真机仅凭本体视觉即可连贯执行搜球、追球与多方向踢球,球位置估计误差降低了46%,触球时间最多缩短64%,前场射门成功率约达90%。
赵明国教授播放了一段比赛片段:蓝色机器人面对一次机会,传统方法会先跑到球后面对着球门再做射门动作,而他们的机器人没有做任何调整,直接射门。但问题也随之而来:什么时候该快,什么时候该慢?赵明国教授提出了一个更深层的思考:人为什么在该快的时候快、该慢的时候慢?“人一定是基于常规的训练,在当场不做那么多决策,把经验和当场的信息融合在一起,最快速做出决策。”
这又回到了脑启发的核心命题。赵明国教授认为,无论是倒水还是踢球,核心困难在于选择太多。“你可以从左边转杯子,也可以从右边转,你有太多的选择。人为什么选择了其中某一种是最好的?我们一定通过训练和在线的两种方式可以出来一个结论,而这个结论我们现有的方法是不太存在的,但脑科学会解释这些事情。”
赵明国教授团队对反应式踢球与双臂多任务并发操作两个场景展开研究,复现与人类相似的的多模态感知处理,并实现从感知到操作的端到端训练和部署框架。“近期,我们的反应式踢球成果发表于Science Robotics,充分说明了该思路的可行性。”他表示道。值得一提的是,该控制器作为核心技术模块,已支撑清华大学火神队连续斩获近两年RoboCup人形组比赛冠军与2025世界人形机器人运动会5V5比赛冠军。
Part 3
结语
从厨房里的倒水场景,到绿茵场上的对抗射门,赵明国教授的研究始终围绕一个朴素的问题展开:人脑是怎么做到的?
在VLA和世界模型占据主流话语的当下,他大胆提出:“在具身智能里面,除了VLA、世界模型这些之外,应该还有一个仿脑的技术路线可以长期去做这件事情。”这条路线不是对现有方法的否定,而是一种补充——当视觉被发挥到极致之后,听觉、力觉、触觉这些被长期忽视的模态,以及人脑在多任务之间动态调度传感器的能力,或许正是机器人从“能干活”走向“会干活”的关键一步。
人形机器人发展之快,已经不以年计、而以季度为单位。在这样一场加速奔跑中,回头看看人脑这个已经进化了数百万年的“最优解”,或许比一味向前冲更有价值。
· END ·
欢迎持续关注荣格智能制造