



10 个关键问题Q&A
-
Q:d1-3B 和普通 VL 大模型本质差别? A:普通 VL 模型逐 token 生成文本;d1 是决策模型,一次前向,0 输出 token,只返回预定义选项的概率,没有文本生成过程。 -
Q:0 输出 Token 是什么含义?输入 token 还计费吗? A:模型不输出任何生成 token;但输入文本 / 图像编码仍消耗输入 token。 -
Q:能不能一个请求同时做多条不同问题? A:可以, system_one,同一个 state 只编码一次,一次性返回多个判定结果,是核心优势。 -
Q:必须预先写死候选选项吗? A:是的,choice/score 必须提前定义候选标签和说明;适合确定集合的判断,不适合开放问题。 -
Q:能不能用来做 Agent 的 guardrail 安全校验? A:非常适合,低延迟 + 概率输出,用来判断用户提问是否违规、是否允许调用工具。 -
Q:为什么视觉任务去掉图片后分数暴跌? A:证明模型不是靠文本猜答案,图像特征真正参与决策。 -
Q:模型支持 batch 批量请求吗? A:支持 system_one_batch,无 padding 打包,批量吞吐很高。 -
Q:什么硬件可以跑 d1-3B? A:RTX 消费卡、AMD MI 系列、Jetson、Apple Silicon(MPS)均可。 -
Q:商用许可是什么? A:LFM Open License v1.0,年收入低于 1000 万美金企业免费商用。 -
Q:d1-3B 可以替换 LLM-as-judge 吗? A:在打分、偏好判断、结果校验场景可以替代,延迟远低于通用 LLM。

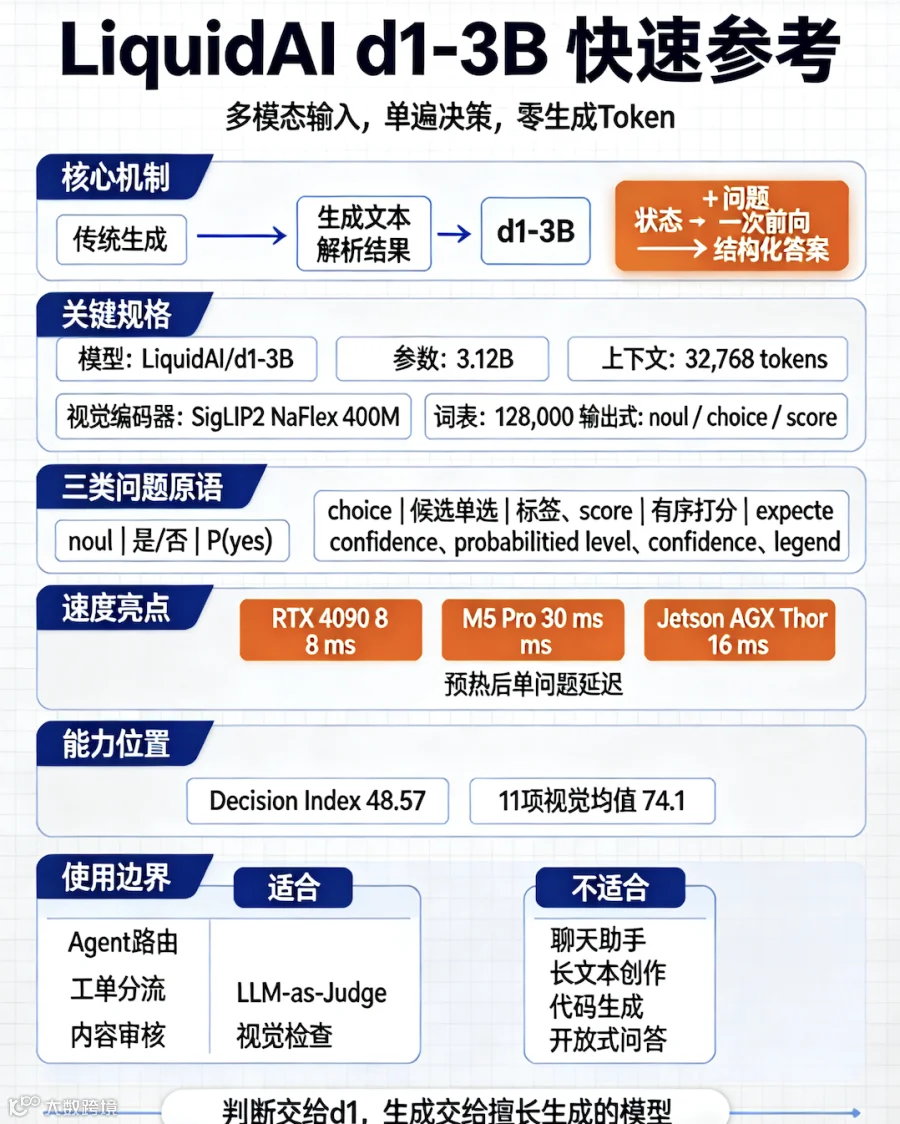
一句话:d1-3B 不是聊天生成式大模型,是「单前向、0 输出 Token 的多模态决策模型」。一次前向推理直接输出结构化概率决策,不逐 Token 生成文本,主打超低延迟,面向 Agent 路由、内容审核、意图分类、视觉质检等确定性判断场景
一、基础模型信息
-
全称:d1-3B,3.12B 参数,基于 LFM2.5-VL-3B 多模态基座后训练得到 -
视觉编码器:SigLIP2 NaFlex,400M 参数 -
上下文窗口:32768 token,词表大小 128k -
能力:文本 + 图片多模态决策;不写文本、不能对话,只做判定、分类、打分 -
权重开源,HuggingFace 可直接下载;支持 vLLM/SGLang/Docker 本地部署、Colab/Kaggle 一键 Demo -
许可:LFM Open License v1.0,年收入低于 1000 万美元企业可免费商用
二、创新:0 输出 Token,单遍多问题推理
传统 LLM:输入 → 逐 token 生成文本 → 再解析 JSON / 标签,延迟随输出长度增加,还会出现格式错误。 d1 决策范式:
-
输入:State 状态(文本 / JSON / 图片,或图文混合) + 一组结构化 Question 定义 -
一次 forward 前向传播,0 输出 token,直接返回带概率、置信度的结构化决策 -
同一个 state 可以一次性并行回答多个独立问题,只计算一次输入编码(极大降本提速)
三类原生 Question 类型(Decision Index 规范)
- noul
Yes/No 二分类,返回 P (yes) 概率 - choice
从给定候选标签中选 1 项;返回选中标签、confidence、全概率分布 - score
有序等级打分(2~10 级);返回期望分值、置信度、概率分布、等级说明
返回结果固定结构:{"answers":{各个问题结果}, "usage":{"input_tokens":N, "output_tokens":0}}
三、性能基准
1)Decision Index 0.2.1(决策任务主榜单)
d1-3B 得分 48.57,10B 以下参数模型第一名
-
超过 Decider 35B-A3B(47.11)、JPT-9B(46.89)、Decider 4B(40.70)
说明:这个榜单专门衡量模型做决策、判断、检索、工具调用、艺术类判定综合能力,不是通用对话能力。
2)文本类公共 Benchmark
SQuAD2.0、BoolQ、XNLI、PAWS-X、Civil Comments 等,均值 77.1,优于 Decider 4B(76.2)、Decider2B(71.5)
3)多模态视觉 Benchmark
11 个图像评测集综合均值 74.1,略高于基座 LFM2.5-VL-3B 的 73.9;可直接基于图片做判断、质检、真假识别。
对照组:去掉图片只保留文字提问,分数暴跌至 45.1,证明视觉信息真正参与决策。
四、推理速度(核心优势,warm 预热后)
GPU
-
RTX4090(bf16,开启 CUDA Graph compile):单问题仅8ms;3 问题同 state:21ms;64 个 state 批量吞吐 475/s -
AMD MI325X:单问题 9ms,批量吞吐高达 1106/s
边缘设备
-
Apple M5 Pro:单问题 30ms -
Jetson AGX Thor:16ms;AGX Orin64GB:26ms;Orin Nano:50ms
要点:新形状首次推理会有编译开销,生产环境需要提前预热;支持无 padding 批量打包
system_one_batch,批量效率很高。
五、推荐落地场景 & 不适合场景
✅ 适合
-
Agent 系统路由、工单分流、意图识别 -
内容审核、风险判定、LLM-as-a-judge 打分 -
抽取校验、重排打分、Agent 护栏(guardrail) -
工业视觉质检、图片合规检查 -
低延迟边缘端判定(Jetson、Apple Silicon 设备)
❌ 不适合
-
聊天对话、写文章、代码生成、长文本创作(模型本身不生成文字) -
开放式自由问答,只能在预先定义候选集 /yesno/ 有序打分场景使用
六、极简使用代码要点
依赖:transformers>=5.14,torch、pillow
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True, dtype=dtype).to(device)
# 核心两个API
model.system_one(state, questions, images=None) # 单状态多问题
model.system_one_batch([(state, questions, images)]) # 批量打包
七、同系列补充
Liquid 同步发布 d1-omni-600M(600M 参数,额外支持音频输入),属于实验版本;d1-3B 是当前主推稳定开源多模态决策模型。
八、关键价值总结(面向 AI Agent 研发视角)
- 消除生成解码延迟
Agent 链路里大量判断类任务(是否调用工具、是否拒绝回答、路由到哪个子系统)不再走 token 生成,延迟从几百 ms 压到个位数~几十 ms - 天然结构化输出
不存在 JSON 解析失败、格式错乱问题,直接输出概率分布,适合做可校准风险判定 - 多问题一次编码
同一个输入 state 一次性做多维度判断,显著降低 token 成本 - 端侧可用
3B 规模 + 极低延迟,Jetson/M 系列 Mac 上可以本地跑决策服务,不用上云