



编者摘要:GPT‑5.6 Sol、Claude Opus 5、DeepSeek V4 Pro、Kimi K3、Qwen3.8‑Max,一众高价闭源 API 同台对标。 上海 AI 实验室基于 GLM‑5.2 744B MoE 基座,训练出 Atria Dawn Preview:专为长链路 Agent 任务打造,而非聊天模型。 自主拆解科研问题、查资料、写代码跑实验、试错迭代直到交付。16 个基准,5 项登顶,DeepSearchQA 高达 96.0。 评估里 1/3 任务:没有 AI 就无法完成,不只是提速。 短板:跑分自报、无第三方复现;SWE-bench Pro 中等,256K 上下文落后竞品。 最大亮点:MIT 协议开放完整 744B 权重(BF16/FP8),本地集群可跑。 闭源 API 卖黑盒结果;Atria Dawn Preview 交付整套 Agent 管线,数据不出自有环境。
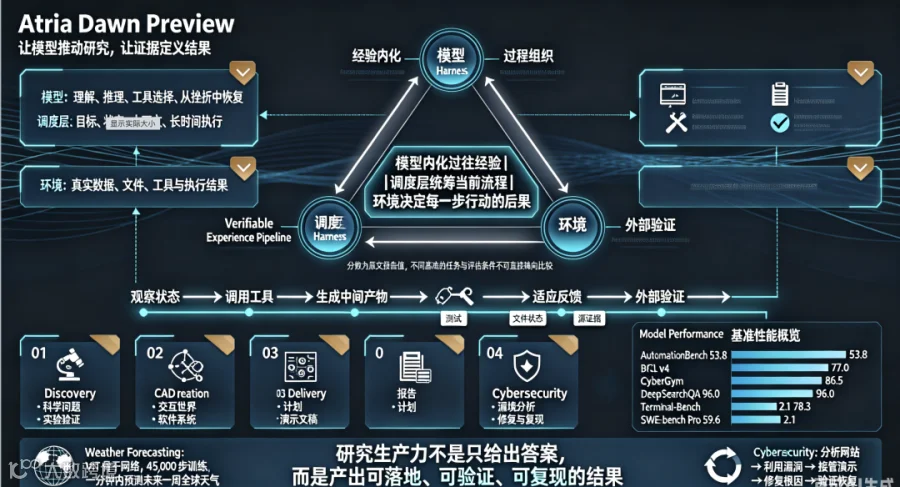
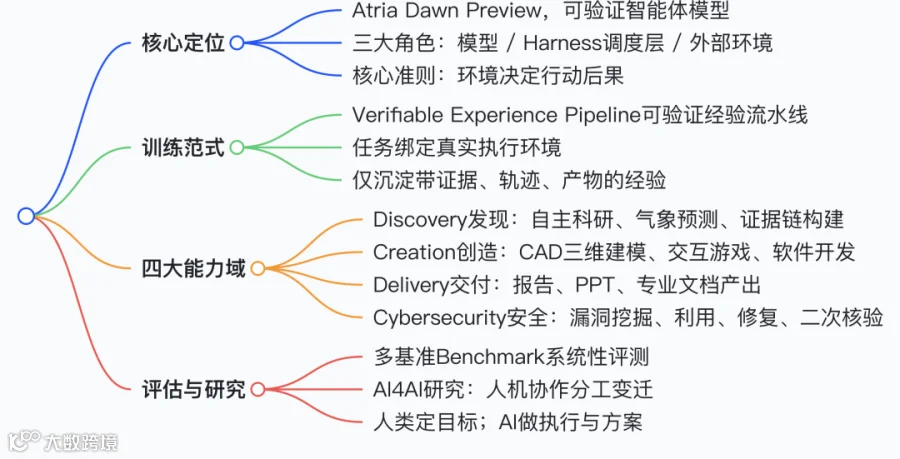
Atria Dawn Preview 是面向科研与工程任务的 AI 智能体模型,核心原则:模型内化经验、调度层统筹流程、外部环境决定行动结果。它采用可验证经验流水线训练,所有训练任务对接真实执行环境,仅将带轨迹、产物、核验证据的经验沉淀进模型。
能力分为四大模块:①发现:自主科研,拆解科学问题、文献调研、代码实验,例如搭建全球气象预报模型;②创造:自然语言生成 3D CAD 模型、交互游戏、软件系统,可产出四缸发动机、MiniOS 等;③交付:从多源资料生成报告、PPT 等专业交付物;④网络安全:在隔离环境完成漏洞挖掘、利用、修复、复验完整安全闭环。
在多基准评测中,它在 CyberGym、DeepSearchQA 等任务表现突出。项目同时探索 AI 辅助 AI 研发,人机协作模式转变:AI 承担大量方案设计与执行,人类聚焦目标设定、关键决策与判断反馈。相关完整论文可在 GitHub 获取。

Git 仓库地址
https://github.com/atria-asi/Atria-Dawn-Preview
论文 PDF 路径: https://github.com/atria-asi/Atria-Dawn-Preview/blob/main/atria-dawn-preview.pdf
仓库主页:https://github.com/atria-asi/Atria-Dawn-Preview 论文直接链接:https://github.com/atria-asi/Atria-Dawn-Preview/blob/main/atria-dawn-preview.pdf
10 个关键问题 Q&A
-
Q:Atria Dawn Preview 的核心架构三要素是什么? A:模型(内化过往经验)、调度层 harness(管理状态、目标、执行流程)、外部环境(决定代码运行、实验成败等真实结果)。 -
Q:什么是可验证经验流水线? A:训练任务接入真实环境,模型调用工具生成中间产物,依靠外部指标验证;只有附带任务轨迹、产物、核验证据的经验,才会被模型学习。 -
Q:Discovery 发现模块可以做什么? A:自主科研,拆解科学问题、文献检索、写代码、跑实验,构建可核验证据链;代表案例:搭建全球气象预报 AI 系统。 -
Q:Creation 创造模块支持哪些产物? A:自然语言生成 3D CAD 机械模型、交互式虚拟场景、游戏、完整软件系统,如长征火箭模型、MiniOS 操作系统。 -
Q:Delivery 交付模块解决什么痛点? A:把分散文档、表格、会议纪要,自动整理成可编辑的报告、项目方案、演示幻灯片,完成专业交付物。 -
Q:网络安全 Demo 的完整流程是什么? A:在授权隔离环境:分析网站→探查攻击面→漏洞利用→接管站点→植入内容→修复漏洞→环境恢复验证。 -
Q:Atria Dawn 训练时是否所有经验都会纳入模型? A:不是。只有具备完整任务轨迹、中间产物、外部验证证据的经验才会被吸收,失败无证据的经验不会直接内化。 -
Q:项目提出的人机协作新分工是什么? A:AI 更多参与方案设计与执行工作;人类侧重设定目标、筛选方案,在关键节点给出判断与反馈。 -
Q:模型能否独立完成长期开放式科研任务? A:可以,能够从科研想法出发,阅读论文、编写训练代码、调试环境、分析实验结果,迭代得到可验证结论。 -
Q:评估方式有什么特点? A:跨 ML 编码、工具调用、软件工程、生产力、网络安全多类基准,使用 LLM 裁判 + 真实环境执行,检验泛化性与执行鲁棒性。
附录 让模型推动研究,让证据定义结论
研究生产力,不只是提出问题、生成代码或是给出答案。它意味着把一项任务推进到可落地、可验证、可复现的最终成果。
真正的研究工作,往往需要在文献、代码、数据、工具与实验环境之间反复迭代:提出假设、查找并整理证据、实现方法、运行实验、检视反馈、从失败中学习,最终产出可供他人审阅的成果。产出不能只是看似合理的文字论述,而必须对应可观测的证据:一次成功实验、可复现指标、真实生成的文件、可查验的模型,或是附有原始资料支撑的研究报告。
Atria Dawn Preview 的目标,就是把这类能力更多地内置到模型本身。
在现代智能体系统中,完成一项任务不能只依靠模型。模型提供可复用能力:理解、推理、工具选择、从单次失败中恢复。调度层(harness)负责管理目标、状态、上下文以及长时间运行的执行流程。环境提供真实数据、文件、工具和执行结果。Atria Dawn Preview 正在探索这三者之间不断变化的边界。对于跨任务稳定复现的行为,我们希望通过训练将其内化进模型;任务执行过程中动态变化的计划、状态、权限与恢复信息,则仍然由调度层显式管理。代码能否运行、文件是否生成、实验成败、证据是否支撑结论,始终由外部环境决定。我们将这条原则总结如下:
模型内化过往经验;调度层统筹当前流程;环境决定每一步行动的后果。
因此,Atria Dawn Preview 并非围绕单一固定的智能体工作流构建。相反,它通过一套可验证经验流水线(Verifiable Experience Pipeline),在各类任务与工具中学习可复用经验。每一项训练任务都对接真实执行环境:模型观察状态、调用工具、产出中间产物,并根据反馈调整。最终结果由外部信号校验,例如测试用例、指标、文件状态、几何结构、原始证据或人工定义的评判标准。只有那些关联任务轨迹、中间产物与验证证据的经验,才会被纳入模型的可复用能力。
下面的演示展示了这些能力在多种真实任务中的落地。发现(Discovery)、创造(Creation)、交付(Delivery)覆盖完整链路:从查找证据、构建产物,到产出专业交付物。网络安全(Cybersecurity)将这套能力应用于安全任务,包含环境分析、漏洞验证、修复与二次核验。尽管示例横跨科研、软件开发、办公、计算机辅助设计(CAD)与安全领域,但它们测试的底层能力是一致的:模型能否理解所处环境、选择工具、适应反馈,并把开放式任务推进到可被外部证据确认的结果?
我们进一步测试这套能力在不同任务与环境下的稳定性。为此,我们在多类能力维度上对 Atria Dawn Preview 做系统性评估:机器学习代码编写、工具调用、软件工程、生产力任务、网络安全,衡量它在多样化任务场景与工具环境下的泛化能力与执行鲁棒性。
除此之外,Atria 也在探索 AI 如何赋能 AI 自身的研发。在 Atria Dawn 的开发过程中,我们通过分析任务记录与智能体日志,研究真实的人机协作场景,覆盖数据构建、模型训练与评估全流程。我们重点研究 AI 如何拓展可完成任务的边界,以及方案构思、关键决策、执行落地、迭代修订这些职责如何在人与 AI 之间分配。实践表明:AI 越来越多地参与方案设计,并承担大量执行工作;而人类的工作重心转向设定目标、遴选方案,并在关键节点给出判断与反馈。通过这些观察,我们希望更好地理解 AI 在研发中的能力边界,以及科研人员的角色正在如何演变。详细内容参见文档:https://github.com/atria-asi/Atria-Dawn-Preview/blob/main/atria-dawn-preview.pdf
00 评估

模型性能
01 发现
科学探究与深度研究
面对陌生领域和复杂科学问题时,Atria Dawn Preview 不只是回答问题,而是直接参与研究全流程。从拆解问题、检索文献、整理证据,到编写代码、验证实验、分析结果,一步步产出可检验、可核验的研究结论。它能够挖掘关键线索,在海量知识与复杂实验空间中串联证据,帮助研究者更快地从提出问题、构建假设,走向验证想法、解读结果。
气象预报|利用数据预测全球天气
构建全球天气预报系统,是对 AI 编程能力的严苛考验。给定超过 100GB 的全球气象数据,AI 需要设计神经网络并端到端训练,精准模拟复杂大气动力学过程。Atria Dawn Preview 在禁用网页搜索的受限环境中完成了整套流程:设计基于 ViT 骨干网络、参数超 4 亿的模型,训练 45000 步,对 69 项气象变量的时序演变进行建模。该系统可在一分钟内完成未来一周的全球天气预报。尽管训练数据更少,它在部分预测指标上已经超越英伟达经典气象预测模型 FourCastNet,证明 Atria Dawn Preview 强大的机器学习代码能力。
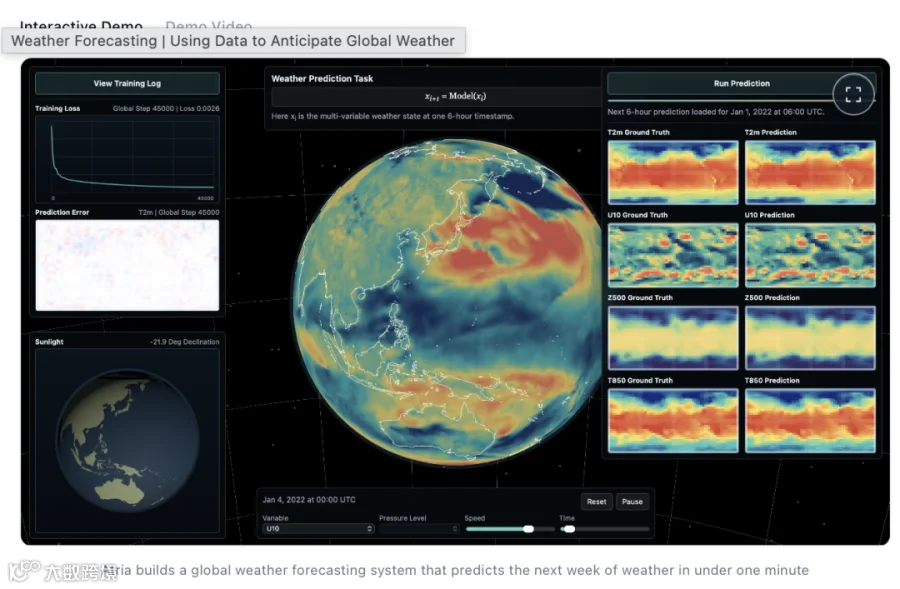
交互式演示|演示视频 Atria 搭建全球天气预报系统,一分钟内预测未来一周天气
自主研究|从研究想法到可运行实验
在自主研究场景下,Atria Dawn Preview 可以把研究问题转化为可运行、可验证的实验。它能解读论文中的方法与算法,选择适配研究目标的技术路线,实现模型与训练代码,并配置实验环境。执行过程中,它可以分析报错、修正方案、解读结果。对研究者而言,这套能力把原本分散在读论文、代码实现、环境调试、实验分析的工作串联成连续流程,帮助初始想法更快落地、验证与迭代。

Atria 端到端自主优化 GDN 内核
深度研究|构建完整证据链
针对没有标准答案的开放式复杂问题,Atria Dawn Preview 拆解研究目标,检索并筛选相关资料,对比多方观点,追踪关键证据与原始来源之间的关联。无论是探索陌生领域、梳理技术演进与研究方向,还是为新假设寻找支撑论据与反例,它都能将零散信息整理为结构化、可溯源的结论,并支持进一步核验。这帮助研究者从单纯检索信息,升级为构建可信证据链、做出可靠科研判断。

从科学问题,生成一份可对照原始证据核验的研究报告
02 创造
将知识与想法转化为可交互世界
在创意类任务中,Atria Dawn Preview 将知识、问题与想法的文本描述,转化为可供查看、操作、体验与运行的数字产物。它能把自然语言表达的设计意图转化为复杂三维工程模型;将文史资料、研究结论、复杂概念转化为可探索的交互空间;创建基于真实问题或历史背景、自带规则与反馈的游戏世界;或是把研究想法变成一套完整软件系统。通过理解内容、梳理结构、设计交互并完成实现,它让知识跳出纯文本,进入可供探索、实验与体验的数字环境。
CAD 设计|用自然语言驱动三维设计
CAD 任务中,Atria Dawn Preview 旨在直接将自然语言描述的设计意图转化为复杂三维工程模型,不再需要一步步手动操作专业软件,而是基于需求生成模型。模型需要理解整体结构、零部件之间的关系,以及单个零件的机械形态与参数,并把这些约束体现在可视化三维设计中。下面演示了 Atria Dawn Preview 生成的复杂模型:四缸发动机、人形机器人、机器人关节模块、长征七号火箭。从整体外形、零部件结构到动力学仿真,这些案例测试它对各类机械系统建模、产出完整复杂 CAD 作品的能力,探索从概念设计走向工业级 CAD 设计的路径。
四缸发动机|人形机器人|机器人关节模块|长征七号火箭 简短指令,即可生成精细三维机械 CAD 模型
交互式可视化|从阅读知识到沉浸式探索
Atria Dawn Preview 能够理解复杂主题中的人物、空间、事件与关联关系,并重构为直观的交互式数字体验。它可以为论文与算法制作交互式讲解,或是把历史文化知识转化为可供自由漫游的虚拟场景。例如大观园演示:模型将文学作品里的人物、建筑与空间关系转化为可视化场景。用户不再只能阅读文字,而是可以进入场景观察、探索,理解各要素之间的联系。
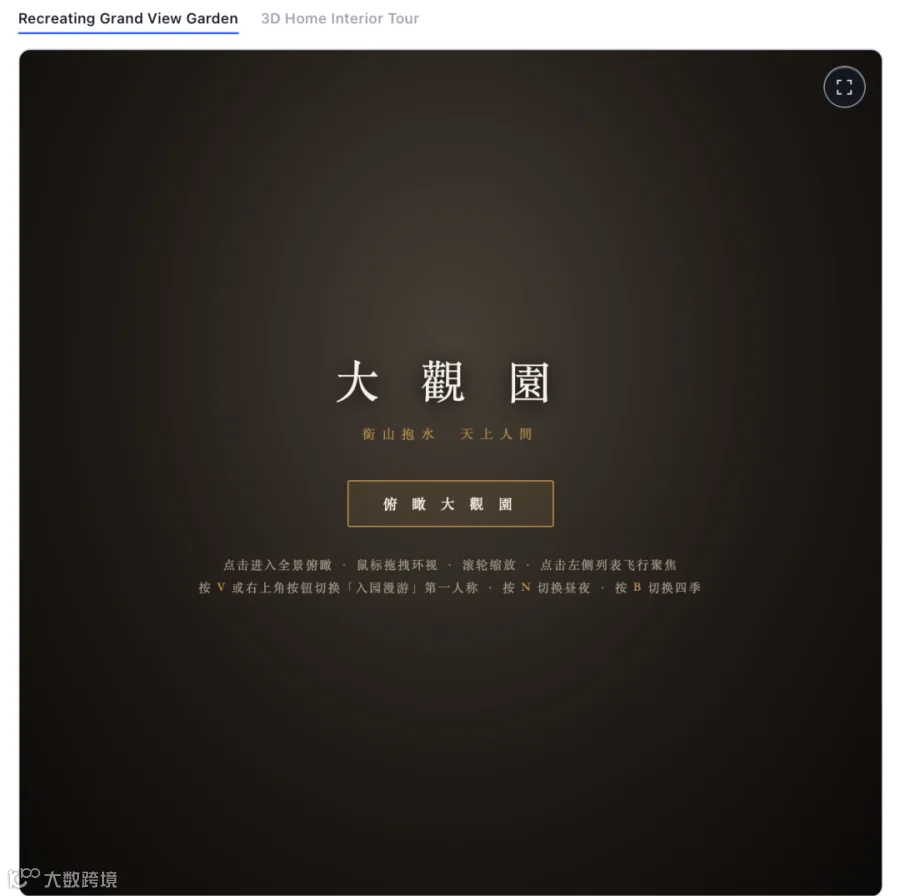
复刻大观园|3D 住宅室内漫游 在 3D 中还原大观园真实建筑布局与热闹场景
游戏创作|通过交互式世界探索规则、场景与知识
基于自然语言描述的场景、规则与目标,Atria Dawn Preview 可以独立构建可游玩世界,包含背景、角色、任务与反馈。这项能力支撑创意创作,同时开辟全新知识传播、情景模拟、实验探索方式。《奥德赛》历史游戏将历史背景、人物与事件转化为参与式叙事,让静态知识变成沉浸式体验。消防逃生演示将安全知识与空间决策整合进交互体验,帮助用户理解在动态环境下不同选择带来的后果。
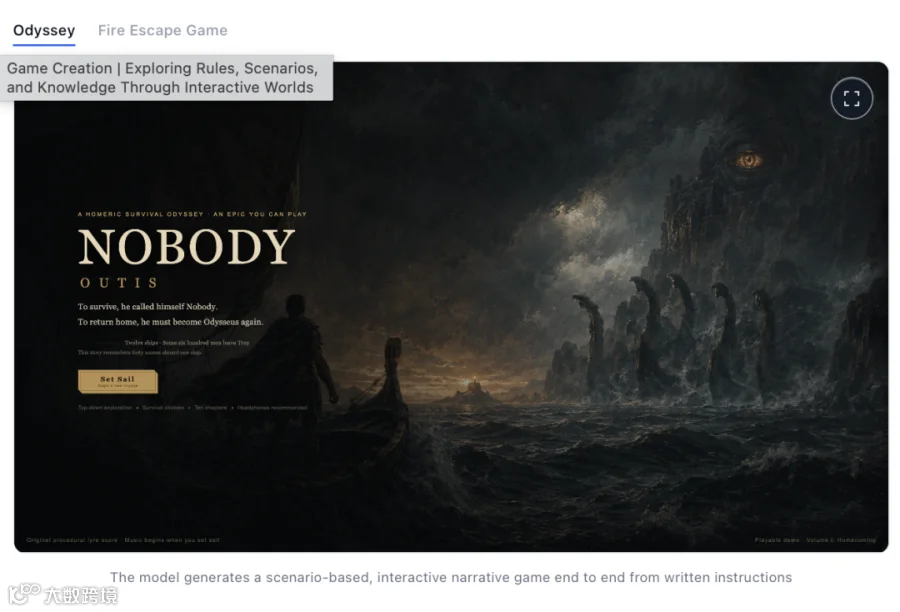
《奥德赛》|消防逃生游戏 模型根据文字指令,端到端生成基于场景的交互式叙事游戏
软件开发|从想法到可运行系统
Atria Dawn Preview 能够把自然语言需求转化为完整软件实现。仅依靠一段描述,就可以规划项目、编写代码、组装完整代码仓库。它也可以在已有代码库内工作,理解架构与上下文,定位问题,跨文件完成工程修改。对研究者来说,算法思路、实验工具、研究系统可以更快从概念走向实现与验证;从研究想法到可用系统的全流程,模型都能参与。

Build Trace|交互式演示 我们的模型在 20 分钟内搭建了一套 MiniOS
03 交付
将专业工作转化为成品交付物
专业任务场景下,Atria Dawn Preview 不止生成文本,而是把理解、分析、设计与沟通贯穿到最终成品。它可以从文档、表格、会议纪要提取信息,生成报告与行动方案;也可以整理论文与开放式主题,产出清晰有说服力的演示文稿。目标是填平 “给出建议” 和 “完成工作” 之间的鸿沟。通过理解目标与专业约束,整合零散素材,针对不同交付物类型打磨输出,把碎片化信息处理,变成可编辑、可使用、可汇报的专业成果。
生产力任务|零散信息转为专业交付物
Atria Dawn Preview 可以把分散在文档、表格、邮件、会议纪要、业务材料中的信息,重组为结构化、可落地的专业交付物。除提取与总结内容外,它还可以分析数据、识别优先级、撰写方案、围绕任务目标规划行动,并针对不同受众调整内容结构与表达形式。对于科研人员和其他专业人士,这意味着可以更快从多源资料生成文献综述、分析报告、项目提案与工作计划。以往需要反复阅读、整理、修订的工作,变成从信息理解到成果交付的一体化流程。
思路演示文稿|原始资料转为高质量幻灯片
Atria Dawn Preview 致力于降低高质量幻灯片的制作门槛。给定一篇论文或需要分享的主题描述,它可以完成完整流程:理解内容、查找支撑材料、梳理叙事逻辑、设计幻灯片。对于学术论文,它解读方法与结论,围绕关键图表构建演示内容。对于开放式主题,它检索用户问题,将零散信息整理为聚焦连贯的大纲,输出视觉精致清晰的幻灯片。下面三组演示案例包含学术论文汇报与开放主题幻灯片,展示 Atria Dawn Preview 将复杂素材转化为易懂且表现力强的演示文稿的能力。

一句话指令,生成完整演示文稿
04 网络安全
网络安全与系统防护
攻防安全任务,是检验基础模型长期智能体工作能力的严苛测试。在安全分析与演练中,Atria Dawn Preview 在任务全程融合环境理解、漏洞分析、工具调用与结果核验。模型不仅要识别网站结构与潜在风险,还要通过反复测试排除误报,定位真实漏洞,完成漏洞利用、修复、二次验证。下面演示:Atria Dawn Preview 在授权隔离测试环境中独立跑完完整链路:分析网站 → 探查攻击面 → 利用注入漏洞 → 接管网站 → 植入游戏 → 修复漏洞 → 恢复环境。该案例测试模型发现与利用漏洞、修复并防护系统的能力。
AI 智能体在授权测试环境完成安全闭环:发现漏洞 → 演示入侵 → 修复根因 → 验证恢复
基准测试结果
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
基准测试说明
AutomationBench:基于 AutomationBench v1.0.6 评估,已修复 PR #13 引入的空类型处理问题。
BFCL v4:使用 BFCL V4 官方生成与评估调度器(commit 6ea5797)。完整基准集包含 5217 个用例,16 并发 worker 运行。模型温度设为官方默认 0.001;每次 API 请求超时 120 秒,最多重试 2 次。网页搜索任务使用 Serper,所有模型请求、回复、搜索轨迹均被记录。总分遵循 BFCL V4 官方权重:非在线任务 10%、在线任务 10%、无关性 10%、多轮交互 30%、智能体任务 40%;智能体任务内网页搜索与记忆权重均等。API 失败产生的占位结果计为错误。
CyberGym:使用 Claude Code 版本 2.1.119;每个任务分配 2 核 CPU、4GB 内存,智能体超时 4 小时 10 分钟,思考强度设为高。
DeepSearchQA:所有搜索智能体任务使用自研基于 ReAct 的调度器,提供三类工具:搜索、访问网页、Python。最大交互步数 500,上下文窗口 256K token,单次生成最大输出长度 64K token。BrowseComp 采用丢弃全部上下文的上下文管理策略。
Workspace-Bench-Lite:基于 AgentCompass 评估框架,使用英文精简数据集。每个任务分配 2 核 CPU、8GiB 内存。GPT 系列模型使用 Codex 作为执行调度器,其余模型使用 Claude Code。每个候选模型单任务限时 2 小时。Doubao Seed 2.0 Lite 作为 LLM 裁判。
BrowseComp:所有搜索智能体任务使用自研基于 ReAct 的调度器,提供三类工具:搜索、访问网页、Python。最大交互步数 500,上下文窗口 256K token,单次生成最大输出长度 64K token。BrowseComp 采用丢弃全部上下文的上下文管理策略。
SkillsBench:全部模型基于 AgentCompass 评估框架,通过 OpenHands 在 79 个任务上评估(独立子集,排除多模态任务);结果取 3 轮运行平均值。
Workspace-Bench:基于 AgentCompass 评估框架,使用英文完整数据集。每个任务分配 2 核 CPU、8GiB 内存。GPT 系列模型使用 Codex 作为执行调度器,其余模型使用 Claude Code。每个候选模型单任务限时 2 小时。Doubao Seed 2.0 Lite 作为 LLM 裁判。
MLE-bench Lite:使用 Claude Code 作为评估调度器,每项评估限时 12 小时。指标采用 HumanRank 分数,遵循 Frontis-MA1: Training an AI4AI Model towards Recursive Self-Improvement in Machine Learning Engineering 提出的计算方法。
WideSearch:所有搜索智能体任务使用自研基于 ReAct 的调度器,提供三类工具:搜索、访问网页、Python。最大交互步数 500,上下文窗口 256K token,单次生成最大输出长度 64K token。BrowseComp 采用丢弃全部上下文的上下文管理策略。
DeepResearch Bench II:全部模型使用 Claude Code 调度器、相同搜索工具,单任务运行时限 4 小时。分数由 LLM 裁判(官方推荐 GPT-5.5)给出,每项结果取 3 次独立评估均值。
τ³-Bench Banking:使用 Tau2/Tau3 银行业知识生成与评估调度器(Tau2 commit a2c0247,本地检索、缓存与运行器经过修改)。完整基准集包含 97 项银行业知识任务,33 并发 worker 运行。用户模拟器与裁判均使用低推理强度的 GPT-5.2,随机种子 300。知识检索启用 alltools,包含 BM25、text-embedding-3-large 稠密检索(返回 Top10 文档)与只读知识库 shell。预计算的 3072 维向量,共 698 份文档,从缓存加载。单次模型请求超时 180 秒,最多重试 3 次;单次模拟超时 1800 秒,外层任务总超时 2400 秒,最大交互步数 200。
Terminal-Bench 2.1:除非另行说明,Terminal-Bench 2.1 使用 Claude Code (v2.1.224) 作为评估调度器。任务超时倍率设为 12 倍,上限 12 小时,最大交互轮次 500。每个模型独立跑 4 轮,报告平均通过率。GPT 模型使用 Terminus 2 作为调度器;部分任务因模型内置安全策略拒绝执行。Claude Opus 5 在部分任务上回退至 Opus 4.8。
GDPval:基于 AgentCompass 评估框架,每个任务以 OpenHands 作为执行调度环境。每项任务分配 4 核 CPU、8GB 内存,智能体超时 4 小时,单次 LLM 调用上限 10 分钟,最大迭代步数 250。评分使用 GLM-5.3 作为 LLM 裁判,在所有模型间成对对比,按评分细则逐项做偏序判定打分,同时输出胜负平局结果与连续分数。评估集共 220 道题目,最终基于全部结果计算 Elo 分。
SWE-bench Pro:全部模型使用 OpenHands 框架(v1.23.0)评估。单任务限时 4.5 小时,最大交互步数 250。评估环境禁用网络访问,移除 Git 历史,防止信息泄露或基准污染。
JobBench:使用官方 JobBench OpenCode 调度器,评估集为 main 子集,共 65 项评估任务。单任务超时 7200 秒,最多重试 2 次,10 并发 worker 执行。任务执行完毕后采用 LLM-as-judge 打分,裁判模型为 Grok-4.3。先对每个任务计算百分比得分,最终得分取全部 65 个任务平均分。API 失败或两次尝试均失败的任务计 0 分