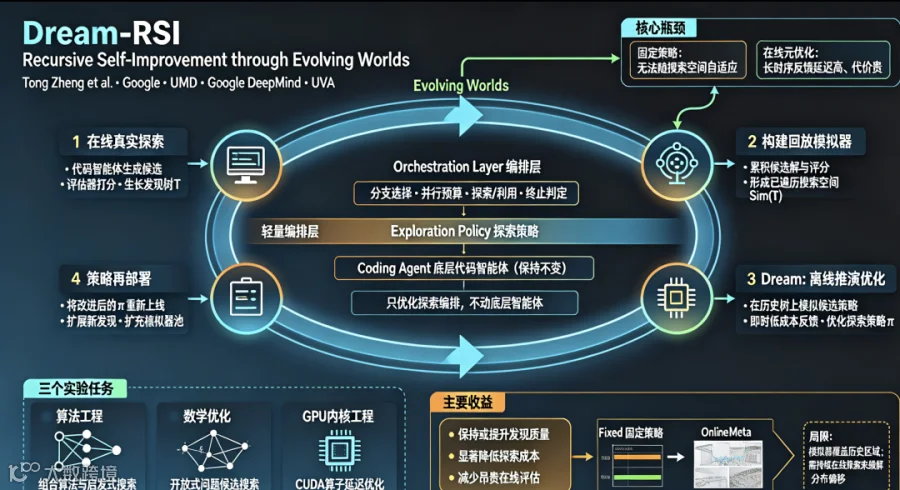
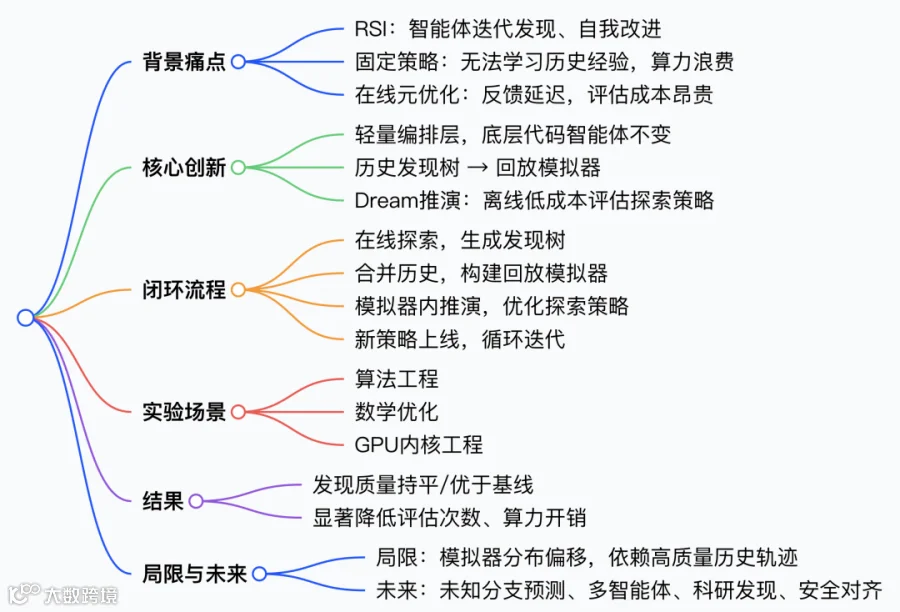
编者摘要:Dream-RSI 是谷歌提出的面向递归自改进(RSI)智能体的探索框架,核心解决传统 RSI 探索策略的痛点:固定策略无法自适应搜索空间,在线优化元策略评估成本极高。该方案新增一层轻量编排层,不改动底层代码智能体,将探索决策显式可编程。核心创新是利用历史探索生成的发现树构建回放模拟器,在模拟器内完成 “Dream 推演”,获取低成本离线反馈来迭代优化探索策略,无需重复执行昂贵的真实评估。
整套系统形成闭环:在线真实探索生成发现树→构建回放模拟器→离线推演优化探索策略→新策略上线继续探索,持续扩充模拟器。在算法工程、数学优化、GPU 内核工程三大任务上验证,Dream-RSI 可维持甚至提升解的质量,大幅减少评估算力开销。该框架存在分布偏移局限,模拟器仅能复现历史访问过的搜索区域,必须依靠持续在线探索扩展覆盖范围,为长时序自主 AI 递归自改进提供了高效新范式。
10 个关键 问题Q&A
Q1:Dream-RSI 要解决什么核心问题?A:解决递归自改进智能体中探索策略优化成本过高的难题,传统固定策略适应性差,直接在线优化元策略需要大量昂贵的真实评估。
Q2:Dream-RSI 的 “Dream(推演)” 是什么含义?A:在由历史发现树搭建的回放模拟器中模拟探索策略,不需要调用真实评估器,低成本评估策略效果,这个离线仿真过程被称为 Dream 推演。
Q3:Dream-RSI 是否需要修改底层代码智能体?A:不需要。仅增加独立的轻量编排层,底层生成候选解的代码智能体保持原样,模块化易落地。
Q4:什么是发现树?A:记录 RSI 探索全过程的数据结构。根节点为原始任务,节点代表候选解,边代表分支扩展动作,每个节点附带评估分数。
Q5:回放模拟器的局限性是什么?A:模拟器只能复现历史已经访问过的搜索分支,无法预测从未探索的全新分支结果,存在分布偏移问题。
Q6:Dream-RSI 完整自改进闭环包含哪几步?A:在线真实探索→构建回放模拟器→模拟器内离线推演优化策略→优化后的策略重新上线,循环迭代。
Q7:实验选用了哪三类测试任务?A:算法工程、开放式数学优化、GPU 高性能内核工程,均属于评估代价很高的 RSI 任务。
Q8:相比基线,Dream-RSI 的实验表现如何?A:最终发现质量持平或更好;在保持同等效果前提下,大幅削减评估次数与算力开销。
Q9:编排层负责哪些决策?A:选择待扩展分支、算力分配、探索与利用权衡、判断搜索终止条件等元层面探索决策。
Q10:如何缓解回放模拟器的分布偏移?A:离线优化后的策略必须回到真实环境探索未知区域,新产生的发现树并入模拟器,持续扩大模拟器覆盖范围,并保留一定探索噪声。
-
附录:Dream-RSI:通过演化世界实现递归自改进
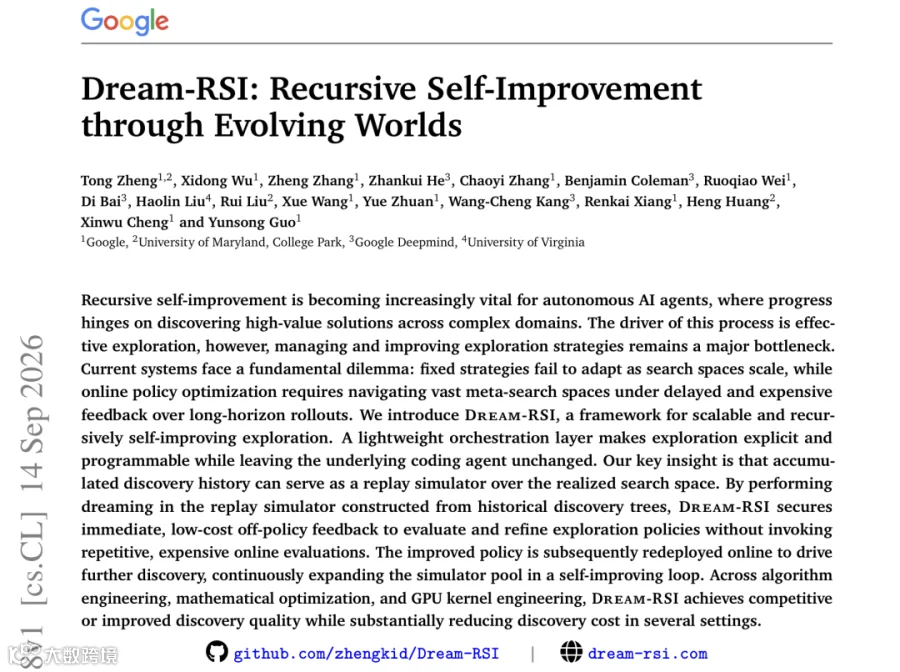
作者:童铮 ¹,²、吴旭东 ¹、张政 ¹、何占魁 ³、张朝一 ¹、本杰明・科尔曼 ³、魏若乔 ¹、白迪 ³、刘浩林⁴、刘锐 ²、王雪 ¹、转越 ¹、王诚康 ³、向仁凯 ¹、黄恒 ²、程新武 ¹、郭云松 ¹¹ 谷歌,² 马里兰大学帕克分校,³ 谷歌 DeepMind,⁴弗吉尼亚大学通讯作者:吴旭东 xidongwu@google.com,张政 zzhangx@google.com©2026 谷歌,保留所有权利arXiv:2609.14858v1 [cs.CL],2026 年 9 月 14 日项目地址:github.com/zhengkid/Dream-RSI | 官网:dream-rsi.com
摘要
递归自改进(Recursive Self-Improvement,RSI)在自主 AI 智能体领域正变得愈发关键。这类系统的进步依赖于在复杂问题域中发现高价值解,而高效探索是整个过程的核心驱动力。但如何管理并持续优化探索策略,至今仍是重大瓶颈。现有系统面临一个根本性矛盾:固定探索策略无法随搜索空间扩张自适应;而在线策略优化,则需要在长时序推演带来的延迟、高成本反馈约束下,在庞大的元搜索空间内寻优。
本文提出 Dream-RSI,一套面向可扩展递归自改进的探索框架。框架引入轻量编排层,将探索逻辑显式化、可编程化,同时不改动底层代码智能体。本文核心洞见:累积的发现历史,可作为已遍历搜索空间的回放模拟器。Dream-RSI 在基于历史发现树构建的回放模拟器中进行 “推演(dreaming)”,获得即时、低成本的离线反馈,用来评估、迭代探索策略,无需反复执行昂贵的在线评估。优化后的策略会重新部署到线上,驱动新一轮发现,持续扩充模拟器数据集,形成自改进闭环。
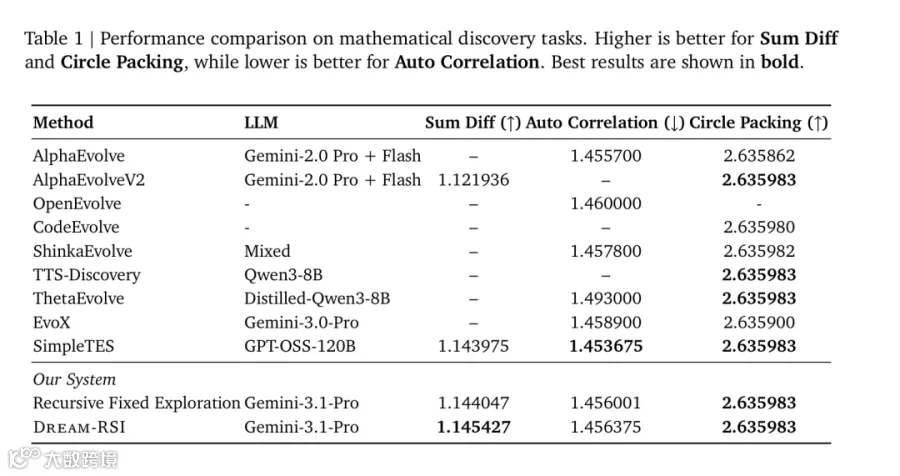
在算法工程、数学优化、GPU 内核工程三大任务场景下,Dream-RSI 在多个实验设置中,取得与基线持平甚至更优的发现质量,同时大幅降低探索所需计算开销。
1 引言
递归自改进(RSI)已经成为自主 AI 系统一个极具挑战性的目标(Liu 等人,2026c)。RSI 的通用运行机制是迭代发现循环:智能体生成候选解、评估结果、吸收反馈、迭代优化后续方案。这类发现循环已经在科学与算法领域带来大量进展,包括算法设计(Novikov 等人,2025;Romera-Paredes 等人,2024)、开放式数学优化(Anthropic,2026;Georgiev 等人,2025)、系统设计(Cao 等人,2026;Jaber & Jaber,2026)以及智能体自改进(Lee 等人,2026;Zhang 等人,2026b,c;Zheng 等人,2026a);这些新发现反过来持续赋能能力更强的 AI 系统。
随着智能体能力提升、自改进目标难度增加,发现任务需要在巨大搜索空间中进行长时序探索,往往要经历数千次 “提案 - 评估” 循环(OpenAI,2026;Ye 等人,2026)。在这样的规模下,对探索过程的编排管控至关重要(Zheng 等人,2026b)。糟糕的探索策略会浪费大量算力与时间,严重限制 RSI 的效率与可扩展性。
现有方法大多依赖人工设计的探索策略,在整个发现过程中基本固定不变(Du 等人,2026;Jiang 等人,2026;Novikov 等人,2025;Yan 等人,2026b;Ye 等人,2026)。固定策略无法从累积的探索经验中学习改进,可能反复把算力投入无效搜索方向。因此近期研究尝试在发现过程中在线优化探索策略(Liu 等人,2026a),但该方案面临巨大挑战:评估一条探索策略,需要完成数百乃至数千轮生成 - 评估的长时序推演,元策略的反馈信号延迟高、代价昂贵。直接测试候选策略,每次都要重新调用代码智能体与评估器,这恰恰是我们想要削减的算力开销。
本文提出 Dream-RSI,解决这一困境。Dream-RSI 的核心思路是:已经跑完的发现任务会留下一棵发现树,记录所有被扩展的分支、生成的候选方案以及对应的评分结果。这份历史记录可以回放,充当已探明搜索空间的模拟器。我们在回放模拟器中运行候选探索策略,就能立刻得到离线反馈,判断该策略在已经探索过的区域表现如何,全程无需调用大模型与真实评估器。基于这些低成本反馈,我们迭代优化探索策略;随后将优化后的策略上线,继续真实世界的发现任务,新产生的探索记录又并入回放模拟器,循环往复。
Dream-RSI 只增加一层轻量级编排层,底层代码智能体完全保持原样。编排层负责决定:扩展哪条搜索分支、并行运行多少候选方案、是优化已有候选还是开辟全新方向、何时终止搜索。探索策略本身成为可优化对象,而不是人工固定的规则。
本文主要贡献:
2 相关工作
2.1 自主发现智能体
近年来,发现型智能体(如 AlphaEvolve、OpenEvolve 以及演化代码智能体系列)已经被广泛用于自动寻找算法、数学证明、高性能 GPU 内核。这类智能体的标准范式:生成候选方案、运行评估、获取分数,再基于结果生成下一轮候选。绝大多数相关研究聚焦于提升候选方案本身的生成质量。Dream-RSI 则向上提升一层,优化探索策略:也就是分支选择、并行度、新方向开辟、终止条件等元决策。
2.2 递归自改进与元优化
RSI 的核心目标是让系统改进 “改进自身的过程”,而不只是改进单次任务输出。很多现有 RSI 系统把优化对象锁定在模型权重、提示词、验证器上。而 Dream-RSI 的优化目标是探索编排策略,属于元层面的过程优化。
元强化学习、元搜索领域已有大量针对元策略优化的研究,但这类方法直接在真实环境中评估候选元策略,反馈成本极高,难以扩展到数千轮提案评估的长周期 RSI 场景。Dream-RSI 使用回放模拟器做离线评估,和传统元优化形成明显区分。
2.3 回放与离线仿真
在强化学习领域,经验回放是经典技术,把历史轨迹存入缓冲区,离线训练策略。Dream-RSI 的回放模拟器和标准 RL 回放有本质区别:我们回放的不是马尔可夫状态转移,而是整棵发现树,完整记录搜索分支的扩展历史、候选方案、评估结果。模拟器可以模拟任意探索策略在这片已经探明的搜索空间中会如何遍历,用来评估元策略。
3 方法
3.1 问题定义
RSI 发现循环可以抽象为一棵发现树。根节点是任务初始问题;每个节点代表一个候选解;边代表智能体对该节点的扩展动作:生成新变体、细化方案、开启新分支。每扩展一个节点,会调用外部评估器得到一个标量奖励 / 分数。
探索策略 π:编排层的决策策略。输入当前发现树状态,输出元动作:选择哪个分支扩展、并行数量、是否新开分支、是否停止。目标:寻找探索策略 π,在有限算力预算下,最大化整棵发现树中最优解的质量。
难点:π 的回报是长时序、延迟回报。只有完整跑完一整轮大量提案评估之后,才能知道 π 好不好。直接在线评估 π,开销极高。
3.2 回放模拟器(Replay Simulator)
当一轮真实在线探索结束,我们得到完整的发现树T。这棵树里所有候选方案、所有评估分数全部已知,不再需要重新调用代码智能体和评估器。
回放模拟器\(Sim(T)\)定义:给定任意探索策略\(\pi'\),模拟器在已有的树T的搜索空间里,模拟\(\pi'\)的探索行为。每当\(\pi'\)选择扩展一个分支,模拟器直接返回历史上真实的评估分数,不需要重新生成代码、跑测试。
重要边界:模拟器只能模拟已经被历史探索覆盖过的搜索区域。模拟器无法预测从未访问过的全新分支的结果。这是模拟器的局限,也是整个循环的驱动力:离线优化只在已探明区域调优策略;优化完成后,策略回到真实世界,探索全新未知区域,把新发现并入模拟器。
3.3 Dream-RSI 完整闭环
整个循环分为 4 个阶段,循环迭代:
命名说明:Dream(推演)就是在回放模拟器中模拟探索策略的行为,不需要真实世界的昂贵评估。
3.4 轻量编排层设计
编排层和底层代码智能体解耦。底层代码智能体保持不变,只负责 “给定一个子问题,生成候选解”。编排层接管元决策:
探索策略可以是提示词策略、小型模型、参数化策略,均可在 Dream 阶段优化。
3.5 模拟器分布偏移与缓解
回放模拟器存在分布偏移:模拟器只包含过去访问过的搜索分支,缺少未知区域信息。因此,离线优化得到的策略,只保证在已探索空间内表现更好,不能保证在全新未知空间一定最优。
Dream-RSI 通过闭环迭代缓解该问题:
4 实验
4.1 实验任务
本文选取三类高价值、高成本的 RSI 发现任务:
基线对比:
评估指标:
4.2 主要结果
OnlineMeta 基线虽然也能得到不错的解,但代价极其昂贵:每一条候选元策略都需要完整真实推演,算力开销远高于 Dream-RSI。
4.3 消融实验
4.4 案例分析
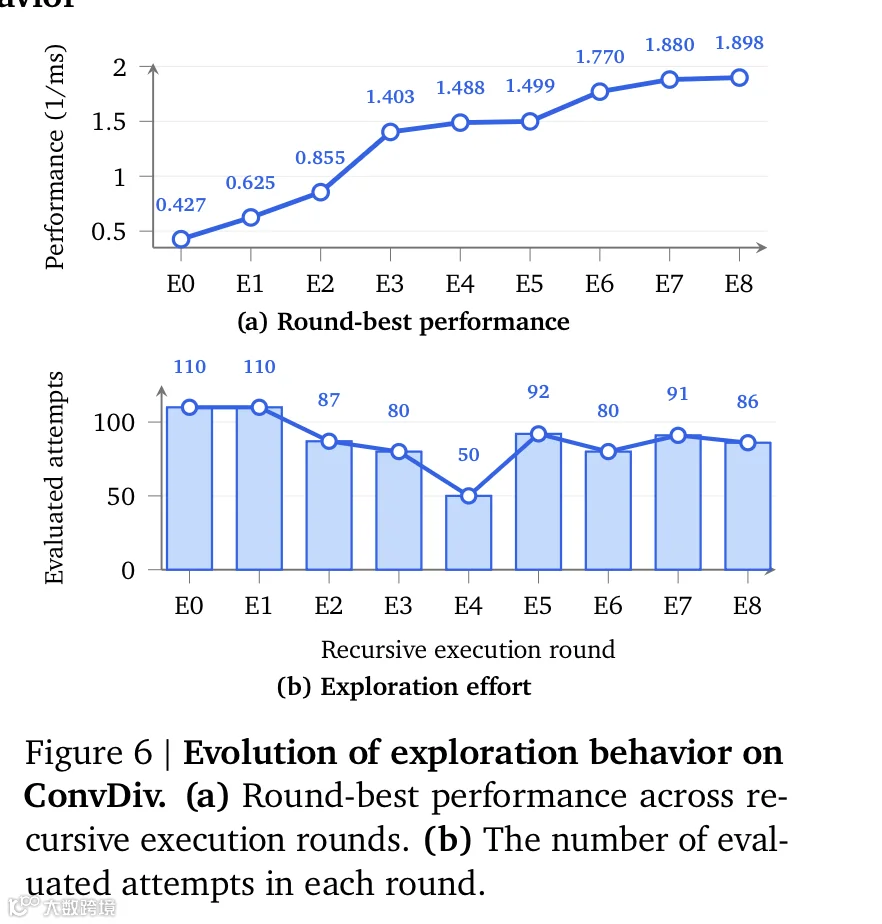
在 GPU 内核搜索任务中,人工固定策略倾向于持续扩展已有高分分支,过早收敛,漏掉部分潜在高性能内核分支。Dream-RSI 在模拟器中测试大量候选元策略,自动学习到动态调整探索 - 利用权衡:在前期分配更多算力开辟新方向;后期收敛到高分分支细化。
5 讨论
5.1 优势
Dream-RSI 的核心价值在于将探索策略本身变成可优化对象,同时把昂贵的元策略评估转移到离线回放模拟器。框架模块化,底层代码智能体可以替换,无需重写。编排层独立,便于工程落地。
5.2 局限
5.3 未来工作方向
6 结论
递归自改进的主要瓶颈不再仅仅是生成候选解的能力,而是如何高效编排长时序探索。固定策略无法自适应;直接在线优化元策略代价过高。
Dream-RSI 引入基于历史发现树的回放模拟器,在模拟器内低成本推演、优化探索策略,再将优化后的策略放回真实世界继续探索,形成自改进闭环。该框架不改动底层代码智能体,仅增加轻量编排层。在算法工程、数学优化、GPU 内核工程的实验中,Dream-RSI 在保持甚至提升发现质量的同时,显著降低 RSI 发现过程的算力开销。Dream-RSI 为可扩展递归自改进智能体提供了一条新路径:优化探索本身。
参考文献(略)
附录
附录 A:回放模拟器实现细节附录 B:各任务环境与评估器详细设定附录 C:额外消融实验与敏感性分析附录 D:探索策略的参数化与提示词策略实现附录 E:额外实验结果与案例
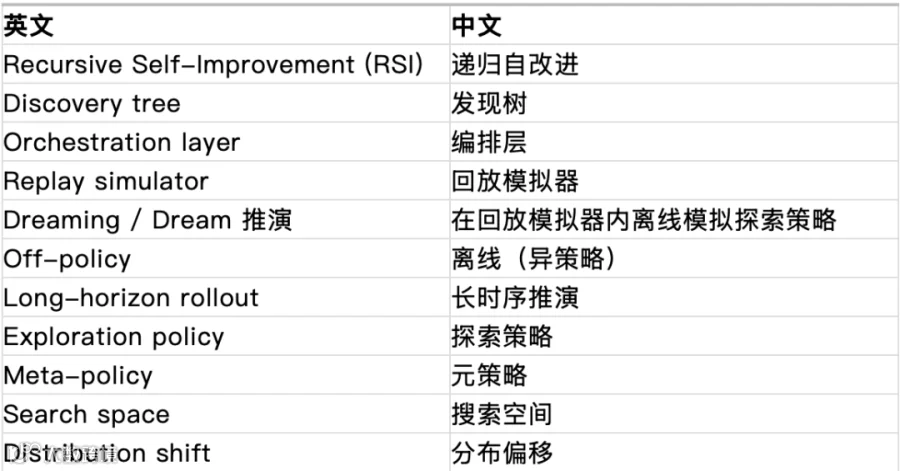
术语对照表(全文统一)
-
发现质量:最终找到最优解的性能; -
发现成本:总评估次数、总算力消耗; -
效率:单位算力下找到高质量解的概率。 -
Fixed:人工固定探索策略(当前主流方案); -
OnlineMeta:直接在线优化元策略,每次评估候选策略都要真实跑完整 RSI 循环。 -
分支优先级:优先扩展哪些现有节点; -
探索 - 利用权衡:是细化已有高分分支,还是开辟全新搜索方向; -
并行预算分配:在不同分支之间分配算力配额; -
终止判定:何时停止本轮搜索。 -
改进模拟器,增加对未访问分支的预测模型,缓解分布偏移; -
扩展到多智能体 RSI 场景,优化多智能体协同探索策略; -
把 Dream-RSI 用于自动科研循环,用于科学假设发现、实验方案编排; -
研究安全对齐:防止探索策略为了短期分数,选择危险或无效的搜索路径。 - 分布偏移
模拟器只能基于历史已访问分支,无法预测完全未知区域的结果。离线优化会偏向在过去见过的搜索空间上表现良好的策略。必须依靠持续在线探索,不断扩充模拟器。 - 依赖高质量历史轨迹
如果初始几轮在线探索本身质量很差,模拟器池的质量低,离线优化的策略上限也会受限。需要合理的初始探索预算。 - 模拟器存储开销
大量发现树需要存储所有候选、评分与分支结构,长周期运行下存储成本会增长。 - 消融回放模拟器
去掉 Dream 离线推演,仅使用固定策略,算力消耗大幅上升,相同预算下最优解质量下降。证明回放模拟器是核心增益来源。 - 消融闭环迭代
只做一轮离线优化,不把优化后的策略放回真实世界扩充模拟器。策略很快出现分布偏移,在全新任务区域性能下滑。证明在线 - 离线交替闭环必不可少。 - 模拟器池大小
模拟器池越大,离线评估的可信度越高,但存储开销上升。实验发现,保留最近若干轮的发现树即可实现大部分收益,不需要永久保存全部历史。 - 算法工程
Dream-RSI 最终发现的解质量与 OnlineMeta 基线持平,但是总评估开销降低约 62%。固定基线消耗大量算力反复探索无效分支,Dream 通过离线模拟器筛选更好的元策略,减少无效探索。 - 数学优化
Dream-RSI 在相同算力预算下,找到更高质量的数学解;若固定最终解质量,则算力开销减少约 54%。 - GPU 内核工程
Dream-RSI 找到的内核延迟等于或优于固定策略基线,评估次数下降约 48%。GPU 内核评估成本极高,减少评估次数带来显著的成本收益。 - 算法工程
自动寻找更优的组合算法与启发式策略; - 数学优化
开放式数学猜想、优化问题的候选解搜索; - GPU 内核工程
自动生成高性能 CUDA 内核,优化算子延迟。 -
离线优化后的策略,必须回到真实世界做在线探索,去触碰未见过的区域; -
新的真实探索记录加入模拟器池,逐步扩大模拟器覆盖范围; -
保留一定探索噪声,防止策略收敛到仅擅长旧区域的局部最优。 - 在线真实探索
使用当前探索策略\(\pi_k\),在真实环境运行 RSI 发现循环。底层代码智能体生成候选、评估器打分,不断生长发现树\(T_k\),产生大量真实轨迹。 - 构建回放模拟器
将本轮新生成的发现树并入模拟器池,得到更新后的模拟器\(Sim_{k+1}\)。 - Dream 推演(离线优化)
在\(Sim_{k+1}\)内,批量采样候选探索策略。在模拟器中模拟每一条候选策略的长时序探索轨迹,立刻得到离线回报信号。基于这些离线反馈,优化探索策略,得到\(\pi_{k+1}\)。 - 策略部署迭代
将\(\pi_{k+1}\)上线,作为下一轮在线探索策略,回到阶段 1。 -
提出回放模拟器范式:利用历史发现树构建低成本离线仿真环境,用于评估长时序探索策略,规避在线评估高昂开销。 -
设计 Dream-RSI 闭环框架:在线真实发现 + 离线模拟器内推演优化探索策略,两者交替迭代,实现递归自改进。 -
在算法工程、数学优化、GPU 内核工程三类硬核任务上开展实验。结果表明 Dream-RSI 能够维持甚至提升发现质量,显著降低算力消耗。 -