


编者摘要:本文聚焦 AI 底层物理基础设施栈,梳理 AI 算力承载实体、成本结构与产业链各环节主体,涵盖数据中心、GPU 集群、电力供给、芯片硬件、云定价、模型训练实测性能,以及产业链建设企业。文中配图 1 追踪四大 AI 大型园区 IT 电力装机规模随时间变化,数据基于已落地设施记录:实线为已实测投产数据,虚线是企业官宣规划,并非实际建成量。
四个重点项目包括 Colossus 1、Meta Prometheus、Anthropic 与亚马逊合作的 New Carlisle 基地、Colossus 2。其中 Colossus 1 建设速度突出,从空建筑到实现 340 兆瓦 IT 供电仅耗时约一年;New Carlisle 公开规划目标,未来 IT 电力规模最高可达 1925 兆瓦。
电力容量是限制大模型训练扩张的核心瓶颈,远不止 GPU 芯片本身。AI 算力集群落地周期长,分为已建成观测容量与远期承诺规划两类,二者不能混为一谈。很多项目官宣巨大电力指标,但只是远期蓝图,尚未完成施工。不同厂商基建节奏差异巨大,Meta、Anthropic 等头部模型厂商都在自建超大规模 AI 园区,不再单纯依赖公有云。
AI 物理栈完整链条:电力供给→数据中心机房→GPU 硬件集群→算力调度与云服务→模型训练。成本结构中,电力与机房基建占比极高,芯片采购只是一部分。大模型军备竞赛本质是电力、土地、冷却、硬件的实体工程竞赛,软件算法进步必须匹配物理硬件扩容。未来几年,各基地电力容量扩张速度,将直接决定大模型迭代上限。

10 个关键问题 Q&A
Q:文章《The Physical Stack Behind AI》的核心研究对象是什么?A:AI 算力的实体基础设施栈,包含数据中心、GPU 集群、电力、芯片、云价格、训练性能以及产业链建设企业。
Q:图 1 中实线与虚线代表的数据有什么区别?A:实线:已落地设施的实测记录;虚线:企业对外公布的远期规划,不是已经建成的容量。
Q:Colossus 1 项目建设亮点是什么?A:仅用约一年时间,从空置建筑完成建设,达到 340 兆瓦 IT 供电能力。
Q:New Carlisle 基地的规划电力规模是多少?A:官宣远期目标 IT 电力容量达到 1925 兆瓦。
Q:限制大模型持续扩容最核心的物理瓶颈是什么?A:电力供给与配套数据中心基建,而不是单纯 GPU 芯片。
Q:为什么不能直接把厂商官宣的电力规划当成当前可用算力?A:规划仅为蓝图,还需要完成施工、调试,属于预期目标,不是已投产算力。
Q:头部大模型企业(Meta、Anthropic)的基建趋势是什么?A:纷纷自建超大规模 AI 园区,减少对公有云的单一依赖。
Q:AI 物理栈由哪几个关键层级组成?A:电力供给、数据中心机房、GPU 硬件集群、云算力服务、模型训练。
Q:AI 算力项目总成本构成有什么特点?A:机房基建、电力成本占比很高,GPU 芯片采购只是成本一部分。
Q:文章提出,大模型竞争本质是什么竞赛?A:实体工程竞赛,比拼电力、土地、冷却系统、硬件集群的落地能力,算法进步受物理基建上限约束。
附录 《The Physical Stack Behind AI》AI 背后的物理栈
一份关于 AI 算力载体及其成本的溯源记录:数据中心、GPU 集群、电力、芯片本身、云定价、实测训练性能,以及搭建每一层的企业。
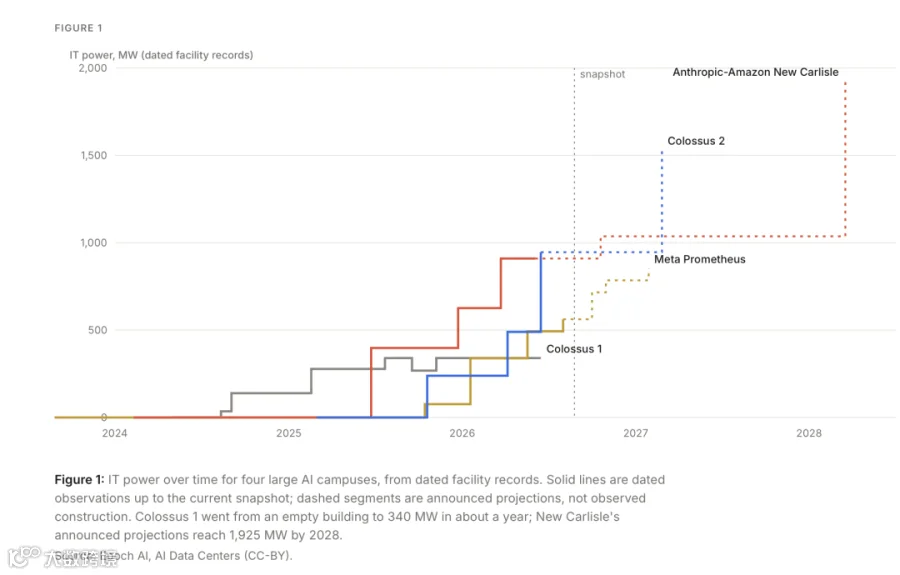
图 1 横轴:2024–2028,纵轴:IT 电力负荷(兆瓦,基于已归档的设施记录)节点:Colossus 1、Meta Prometheus、Anthropic-Amazon New Carlisle、Colossus 2
图 1:四座大型 AI 园区随时间变化的 IT 电力负荷,数据来自设施存档记录。实线为截至当前快照的实测记录;虚线为已公布规划值,并非已落地建设数据。Colossus 1 在约一年时间内从空楼扩容至 340 兆瓦;New Carlisle 公开规划目标是 2028 年达到 1925 兆瓦。来源:Epoch AI,《AI 数据中心》(知识共享协议 CC-BY)
记录揭示的核心信息
记录中规模最大的设施 Colossus 2,预估电力规模 946 兆瓦。全部 12 座顶级设施的数据均为估算值(图 2)。
存档建设记录显示,超大型算力园区扩张速度极快;部分项目在约一年内就实现数百兆瓦 IT 电力落地,其中一个公开规划项目预计 2028 年电力规模可达 1925 兆瓦(图 1)。
即便同一款加速器,官方报价差异巨大。在 155 条云产品目录样本中,H100 单加速器小时单价区间为 4.57 美元至 18.37 美元,同代硬件价格相差 4 倍(图 4)。
四大基础设施投入企业,最近财年合计资本开支达 4252 亿美元,而折旧总额为 1307 亿美元。当下大量投入,会在资产的使用年限内逐步计入利润表(图 5)。
底层数据集包含 83 处算力园区、482 个 GPU 集群、2935 条价格记录,以及 53 家上市公司的 SEC 披露信息。所有数值均为实测、估算或推导所得,并附带来源。
整套系统的构成逻辑
黄仁勋将 AI 经济描述为五层蛋糕模型:能源、芯片、基础设施、模型、应用。英伟达把基础设施层内部的物理系统称为AI 工厂:专为将数据与电力转化为智能而设计的数据中心。算力园区的建设顺序:土地 → 建筑主体 → 电力 → 冷却系统 → 计算硬件。下文遵循该建设流程展开,再深入机房内部,从芯片到机架、集群,之后介绍虚拟机、工作负载与经济学模型。
第一部分:建设算力园区
AI 园区按顺序建设:土地、建筑主体、电力、冷却,最后部署计算硬件。我们先从电网讲起,因为可用电力往往决定项目推进节奏与最终规模。
01 电网与供电
数据中心建设始于电力接入。发电、输电、变电站与备用系统,共同决定算力园区可用电量。公开的电力指标,可能代表已签约容量、获批容量、已通电容量,或是服务器实际可用负荷;每一项对应项目不同阶段。
-
电网供电:大型园区的耗电量相当于一整座发电厂的输出 -
公用变电站:变压器与开关设备往往是整个项目的瓶颈 -
备用电源:电池与发电机应对电网断电故障 -
AI 算力园区:记录中最大设施的耗电量约等于 78.8 万户家庭用电
吉瓦级算力园区,需要电力供应商提供持续稳定供电。在电力完成签约且可物理交付前,项目其余部分都无法运行。
大型园区的耗电量相当于一整座发电厂的输出
电力以高压形式输送过来,必须降压之后设备才能使用。降压所需变压器、开关设备与输电改造工程,工期甚至长于数据中心主体建设。
变压器与开关设备往往是整个项目的瓶颈
哪怕短暂断电,也会中断模型训练任务。电池与现场发电机在停电期间维持负载稳定,直到电网恢复。
电池与发电机应对电网断电故障
一部分电力会在电能转换过程损耗,还有一部分供给冷却及其他配套设备。因此,签约电力、获批电力、已通电电力、服务器可用 IT 负荷,是项目不同阶段的四个不同指标。
记录中最大设施的耗电量约等于 78.8 万户家庭用电
电网容量转化为园区可用电力的四个状态:签约容量、获批容量、通电容量、IT 负荷;家庭用电量对比采用美国家庭平均 1.2 千瓦负荷估算。
英伟达提出将800 伏直流(800V DC)供电架构下沉至机架侧。该方案可减少电能转换环节,降低能耗损耗,留出更多空间部署计算硬件。这代表一条演进路线:从当前交流供电机房,过渡到混合供电系统,最终落地原生 800V 直流机房。目前绝大多数已投产数据中心尚未采用该架构。
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:9 家企业
02 算力园区本体
一个数据中心园区可包含多个数据机房 —— 用于成排部署机架的大型安全机房。机房会分阶段投产,电力、冷却、安防与网络系统验收完成后才会启用。计算硬件消耗的电能几乎全部转化为热量,因此冷却系统决定单机房可部署机架数量,以及机架能否长时间满功率运行。
-
电气场区:这套设备决定园区电力上限,无法通过增加服务器突破 -
冷却站:决定可实现的部署密度与持续算力输出 -
数据机房:分阶段投产;公开规划中包含尚未建造的机房 -
运维调试:测试与验收,决定机架何时可以承载业务负载
电气场区的变压器与开关设备划定园区用电上限。单纯增加服务器无法突破这个上限。
这套设备决定园区电力上限,无法通过增加服务器突破
芯片消耗的电能几乎全部变成热量。冷却系统决定机架部署密度上限,以及硬件能否持续满额输出算力。
决定可实现的部署密度与持续算力输出
数据机房是安放成排机架的安全空间。园区分批次启用机房;一个 900 兆瓦的规划项目,可能先上线 300 兆瓦算力,其余机房仍为毛坯状态。
分阶段投产;公开规划中包含尚未建造的机房
机房承载正式业务前,运维团队需要测试所有电力链路、冷却回路与故障切换机制。验收调试,是把完工建筑转化为可用算力的关键一步。
测试与验收,决定机架何时可以承载业务负载
园区整体结构:电气场区、冷却站、分阶段建设的数据机房、运维体系。同一个算力园区,可在不同时期承载多个集群,由多家运营商运营。
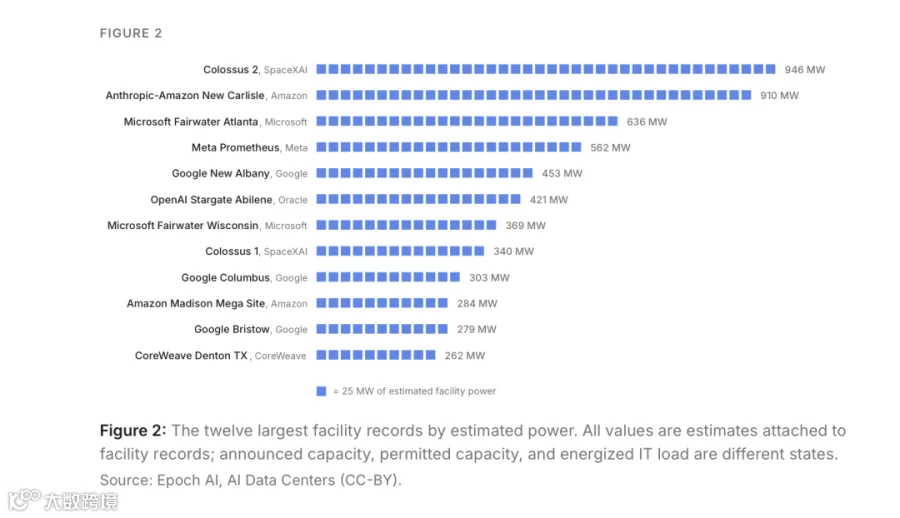
图 2:12 座规模最大算力园区(预估电力规模)
单位方块代表 25 兆瓦预估设施电力
-
Colossus 2(SpaceXAI):946 MW -
Anthropic-Amazon New Carlisle(亚马逊):910 MW -
Microsoft Fairwater Atlanta(微软):636 MW -
Meta Prometheus(Meta):562 MW -
Google New Albany(谷歌):453 MW -
OpenAI Stargate Abilene(甲骨文):421 MW -
Microsoft Fairwater Wisconsin(微软):369 MW -
Colossus 1(SpaceXAI):340 MW -
Google Columbus(谷歌):303 MW -
Amazon Madison Mega Site(亚马逊):284 MW -
Google Bristow(谷歌):279 MW -
CoreWeave Denton TX(CoreWeave):262 MW
图 2:按预估电力规模排序的 12 座顶级算力园区。全部数值均为设施记录估算值;规划容量、获批容量、已通电 IT 负荷属于不同口径。Colossus 2 规模约等于一座中型城市用电量。来源:Epoch AI,《AI 数据中心》(CC-BY)
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:12 家企业
第二部分:组装计算系统
计算硬件从内向外组装:芯片部署在机架级系统内,搭配内存、网络、供电、冷却;多机架互联构成集群。
03 芯片
单个机架内部,GPU 与 CPU 承担不同任务。GPU 负责模型大规模并行计算,推理吞吐量通常以 token 衡量。CPU 处理串行任务:工具调用、代码执行、浏览器会话。智能体完成一次任务,会在两者之间来回切换数百次。
-
GPU:并行数学运算;输出指标:token -
CPU:串行任务;输出指标:每秒任务数 -
智能体循环:单个智能体可在两者之间来回跳转数百次 -
衡量指标:GPU 看 token;CPU 看任务与智能体并发量
GPU 内部成千上万个小核心,同时对多份数据执行相同运算。高带宽内存(HBM)把模型权重与激活值放在处理器旁;推理吞吐量一般用 token 计量。
并行数学运算;输出指标:token
CPU 核心数量更少、单核性能更强,处理必须按顺序执行的任务:调用工具、打开浏览器、执行生成代码。英伟达 Vera CPU 专为这类控制密集、低延迟需求的智能体 AI 场景设计,搭载 88 个核心。
串行任务;输出指标:每秒任务数
智能体运行流程:GPU 执行模型推理 → 把步骤交给 CPU 执行 → CPU 返回结果 → 模型再判断下一步动作。该流程多次分支,一旦工具调用、浏览器操作变慢,昂贵的 GPU 就会处于等待状态。
单个智能体可在两者之间来回跳转数百次
GPU 性能常用单位:每瓦 token、每美元 token、每用户 token、每座 AI 工厂 token。面向智能体场景,CPU 性能更适合用完成任务数量、并发智能体数量衡量。目前行业还没有标准化的公开基准测试,用来评估这类工作负载。
GPU 看 token;CPU 看任务与智能体并发量
一块计算载板上的 GPU 与 CPU,以及智能体在两者间循环工作的流程。GPU 参数参考英伟达 Blackwell 文档;CPU 参数参考英伟达 Vera CPU 文档(88 颗 Olympus 核心、LPDDR5X、NVLink-C2C 互联)。
芯片性能衡量口径
GPU 吞吐量一般以 token 计量。对于智能体 AI,CPU 性能更适合用完成任务数、并发智能体数量衡量。指标分母决定指标含义:能源、成本、服务负载,或是整座算力园区总产出。
输出单位
GPU 运行模型,CPU 执行模型触发的工具调用,结果回传给 GPU 用于下一步推理。浅色线条代表模型可选的其他分支路径。本轮已完成 1 次往返。真实任务可能需要数百次往返。角色与指标参考英伟达 Blackwell 架构、Vera CPU、Omniverse DSX 蓝图公开文档。本文不提供智能体工作负载基准测试成绩。
GPU 输出就是 token,由数千核心并行计算生成。CPU 输出是任务:模型周边的串行步骤,例如工具调用、代码、浏览器交互。
token 指标必须搭配分母才有意义:
- 每瓦 token
能源维度。扣除电能转换、冷却、芯片本身损耗之后,模型净产出,由电力层决定。 - 每美元 token
商业成本维度。token 除以实际计费单元,可以是虚拟机小时、加速器小时,或是自有硬件折旧。同一块芯片,不同计费口径结果不同。 - 每用户 token
单用户吞吐量。系统可承载并发用户数,同时满足延迟要求;批处理、KV 缓存、延迟目标之间互相取舍。 - 每 AI 工厂 token
把整座园区视为一台整机。英伟达用于描述吉瓦级一体化算力园区,DSX 蓝图作为参考设计。
CPU 指标:每秒任务数、单 CPU 可承载智能体数量。token 吞吐量描述 GPU 上运行的模型;任务吞吐量描述模型周边的串行工作。面向完整智能体工作负载的公开基准才刚刚起步,因此本文不给出 CPU 性能数值。
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:7 家企业
04 机架
现代 AI 机架远不止 GPU。参考架构机架集成 CPU、GPU 与配套 HBM、网络、本地存储、管理硬件、供电母线、液冷系统。每一个部件都会影响机架性能、成本和部署速度。
-
计算载板:单机柜内置 72 块 GPU、36 颗 CPU -
GPU 配套内存:每颗 GPU 旁部署 HBM;整机 13.4TB HBM3e,带宽是普通笔记本数千倍 -
NVLink 互联背板:72 块 GPU 如同单块设备协同工作 -
供电与冷却:整机约 120 千瓦,液冷散热
机架包含 18 块计算载板。每块载板是一套完整计算机,搭载 4 颗 Blackwell GPU + 2 颗 Grace CPU,可单独维护,无需拆解整个机架。
单机柜内置 72 块 GPU、36 颗 CPU
GPU 需要就近高速数据。高带宽内存部署在处理器旁,整机 HBM3e 总容量 13.4TB,带宽远超普通服务器内存。
每颗 GPU 旁部署 HBM;整机 13.4TB HBM3e,带宽是普通笔记本数千倍
9 块交换载板通过铜背板连接所有计算载板。NVLink 让 72 块 GPU 可互相高速访问显存,使机架作为单一计算系统运行。
72 块 GPU 如同单块设备协同工作
8 个电源模块向机架底部公共母线供电。液冷回路带走 CPU 与 GPU 热量,整机功耗上限约 120 千瓦。
整机约 120 千瓦,液冷散热
机架配置与参数来自英伟达 DGX GB200 NVL72 参考文档:18 块计算载板、9 块 NVLink 交换载板、72 Blackwell GPU、36 Grace CPU、13.4TB HBM3e,功耗约 120kW,液冷。
机架正成为行业竞争的核心单元。CPU、GPU、HBM、网络、存储、供电、管理与液冷,共同决定系统性能。英伟达 DSX 蓝图将这种协同设计延伸到整座 AI 工厂,整合参考系统、仿真、运维软件、园区建设指南与合作伙伴技术。英伟达定义并验证参考架构,合作伙伴负责建设与运营站点。
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:9 家企业
05 集群
集群把大量机架连接成一套统一计算系统。高速网络同步机架,共享存储供给数据,调度软件分配任务。只有全部组件验收完成、工作负载稳定运行,集群才算正式投产。
-
单加速器:满负载功耗约等于一台满载游戏主机 -
单计算载板:4 块 GPU,功耗约等于两台电暖器 -
单机架:72 块 GPU,耗电量约等于 100 户家庭 -
单集群:记录中最大集群耗电量约等于 29.4 万户家庭
加速器完成模型数学运算,依靠配套高带宽内存。但它仍依赖系统其余部分供电、传输数据、接收指令。
满负载功耗约等于一台满载游戏主机
一块计算载板集成 4 颗加速器、2 颗宿主机 CPU、网络与本地存储,本身就是一台可独立运行软件的服务器。
4 块 GPU,功耗约等于两台电暖器
18 块计算载板加 9 块交换载板组成参考机架。NVLink 把机架内 72 块 GPU 接入统一高速显存域。
72 块 GPU,耗电量约等于 100 户家庭
高速互联网络连接大量机架,共享存储提供数据,调度器分配任务。整套系统验收完成后,集群可承载生产业务。
记录中最大集群耗电量约等于 29.4 万户家庭
载板、机架配置参考英伟达 GB200 NVL72 参考设计(18 计算载板、9 交换载板、72 GPU,约 120kW);规模仅示意。集群数据取自当前最大记录 xAI Colossus Memphis 三期;家庭用电对比采用美国平均每户 1.2kW。
从单台设备放大到大规模算力:2016 至今,所有标注首次投产时间与规模估算的集群记录。纵轴对数坐标向上攀升,代表算力持续扩建。
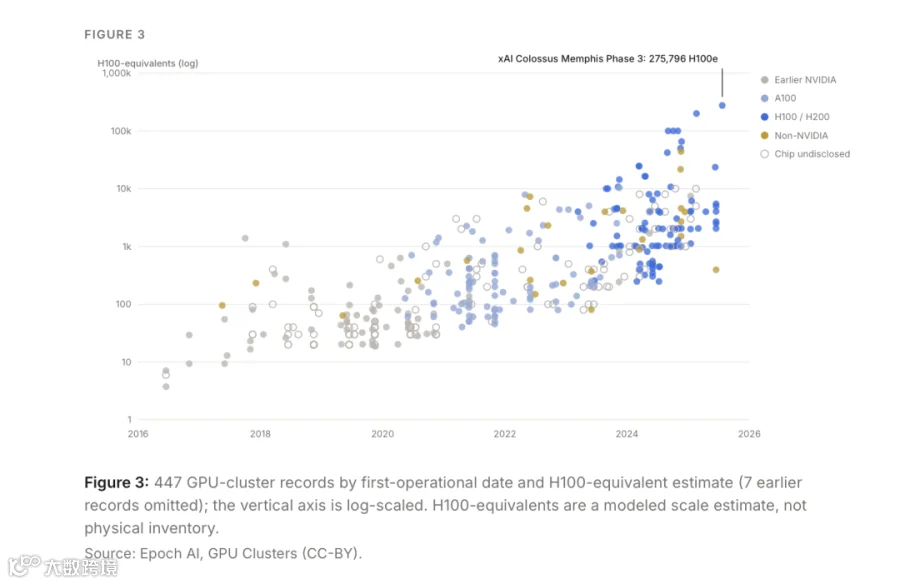
图 3
纵轴:H100 等效算力(对数刻度);横轴:2016–2026分类:早期英伟达芯片、A100、H100/H200、非英伟达芯片、芯片型号未披露
xAI Colossus Memphis 三期:等效 275796 块 H100图 3:447 条 GPU 集群记录,按首次投产时间、H100 等效算力估算(省略 7 条早期记录);纵轴对数坐标。H100 等效算力为模型估算规模,不等于物理硬件库存。来源:Epoch AI,《GPU 集群》(CC-BY)
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:14 家企业
第三部分:算力投产落地
集群验收完成后,客户可租用算力,运营商可衡量产出。工作负载与资源利用率,决定巨额投入能否产生回报。
06 虚拟机
云客户通过虚拟机租用硬件。云厂商将硬件封装为不同实例规格,按使用时长计费。报价通常包含 GPU、宿主机 CPU、系统内存、本地存储、网络与平台服务。两份同小时报价,背后硬件配置可能差异巨大。
-
宿主机系统:云实例底层硬件 -
加速器:GPU 及其内存,负责模型计算 -
宿主机:CPU、内存、存储、网络,为 GPU 提供数据 -
虚拟机:同型号 H100 单价区间 4.57–18.37 美元 / 小时
云实例底层是宿主机系统,包含加速器、宿处理器、内存、存储、网络。客户几乎看不到底层硬件细节。
云实例底层硬件
GPU 与配套内存执行模型计算。服务器其余组件负责供给数据、协调任务、传输结果。
GPU 及其内存,负责模型计算
宿主机 CPU 读取数据、运行操作系统、跨网络收发结果。只要链路任一环节拖慢速度,GPU 就会等待,计费仍持续。
CPU、内存、存储、网络,为 GPU 提供数据
云厂商将硬件切分为不同规格虚拟机,按时长收费。同一款加速器,根据配套服务器、地域、合同不同,定价不同。
同型号 H100 单价区间 4.57–18.37 美元 / 小时
虚拟机是宿主机硬件之上,面向计费的云层。实例配置、地域、优惠方案共同决定价格。
云算力成本:2935 条官方云目录价格记录
仅统计按需付费、明确标注加速器数量的价格,换算为单加速器小时价格对比。每一代硬件上线时定价更高;同一款加速器,随地域、虚拟机规格不同,价格跨度可达 4 倍(H100)。目录标价是公开挂牌价,不等于客户实际采购均价。
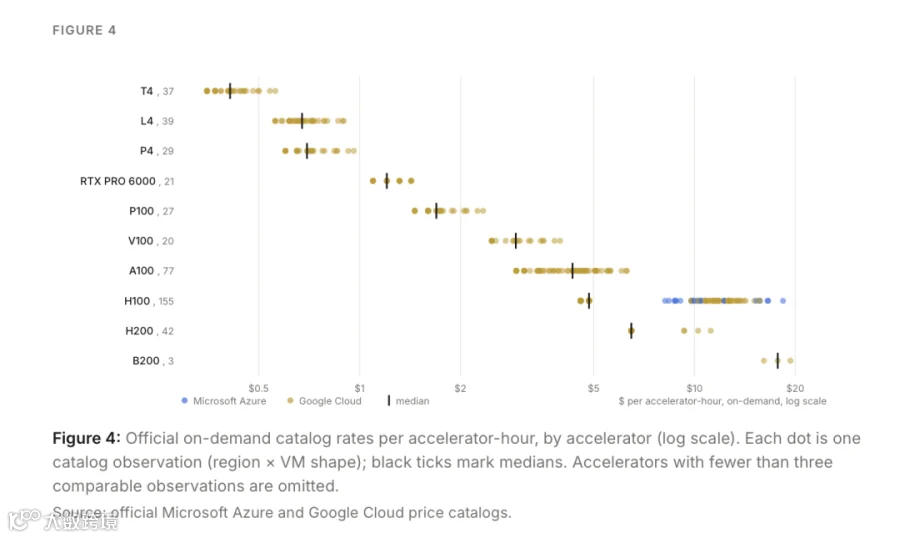
图 4
纵轴:单加速器小时价格(美元,对数刻度)芯片型号:T4、L4、P4、RTX PRO 6000、P100、V100、A100、H100、H200、B200
图 4:各加速器官方按需目录单价(对数坐标)。每一个点代表一条目录记录(地域 × 实例规格);黑色短划线为中位数。样本少于 3 个对比项的加速器未列入。来源:微软 Azure、谷歌云官方价格目录
模型推理:一次请求完整流程
推理开始前,模型权重必须加载进加速器显存。每生成一个 token,请求都要重复一套流程。下面拆解硬件执行逻辑;后文工作负载部分从流量入手,估算支撑业务所需算力规模。
推理分步流程
一条请求:从存储读取模型权重,到流式输出结果,共 6 步。前 3 步每条请求只执行一次;后 3 步每生成一个 token 循环执行。示例提示词:“What is HBM?”,回复逐 token 流式返回。本轮已流式输出 5 个 token。
训练得到的参数就是模型。参数以文件形式保存在存储;推理前,参数必须以指定精度载入加速器显存。HBM 容量决定硬件最低部署门槛:大模型需要拆分到多块加速器;推理系统显存还要预留运行开销与持续增长的 KV 缓存,只按权重大小估算是下限。
请求被拆分为 token 序列。分词把文本转为数字 ID;提示词长度会影响计算量,占用活跃请求对应的显存。每一个 token 调用模型权重:加速器执行多层矩阵运算,经常跨设备通信。显存带宽、互联速度、批处理策略与软件,共同决定硬件有效产出。
KV 缓存保存上下文注意力状态。已经处理过的上下文保留在加速器显存,模型无需为每一个新 token 重新计算全部对话历史。更长上下文、更多并发用户,需要更多显存。推理循环逐 token 生成:模型输出概率分布,挑选 token,追加进上下文,再次运行。token/s 吞吐率与资源利用率,决定租用算力的产品经济性。
内部构成:6 大组件,配套供应商与来源 | 市场参与主体:7 家企业
07 工作负载
基准测试衡量系统完成指定任务的速度。训练与推理性能取决于模型、数据、加速器、网络、存储、框架、精度与软件。测量耗时或吞吐,代表整套系统在固定规则下的能力。
-
任务定义:模型 + 数据 + 目标质量 -
训练运行:数千块 GPU 同步计算、同步结果 -
故障与检查点:保存中间进度,故障只损失几分钟工作量,而非全部 -
性能测量:达到目标质量所需时间
训练任务由三点定义:模型、数据集、需要达到的质量目标。所有后续工作都服务于达成目标。
模型 + 数据 + 目标质量
每块 GPU 计算自身分担任务,之后所有 GPU 同步汇总结果,再进入下一轮迭代。一块 GPU 拖慢,整套集群都会等待。
数千块 GPU 同步计算、同步结果
系统定期把进度写入存储,对应坐标轴上的标记点。节点中途故障时,任务回退到最近检查点,不用从头开始训练。
保存中间进度,故障只损失几分钟工作量,而非全部
训练在指标曲线达标时结束。本记录中一条实测结果:64 颗 Blackwell Ultra GPU 完成目标训练耗时 12.45 分钟。
达到目标质量所需时间
一次实测训练流程:输入模型与数据,分布式系统执行,输出达标耗时。只有同一工作负载、同一基准版本下,结果才可对比。
工作负载成本测算
同一套基础设施,可以做模型预训练、对齐调优、对外推理服务、视频生成。预训练与视频生成场景基于假设算力预留;推理场景从业务流量出发,结合公开系统吞吐,反推所需集群规模。全部为可调整估算模型,不是企业真实账单。
算力成本模型
-
预训练:基座模型训练 -
后训练:调整模型行为 -
推理:持续对外服务用户 -
视频生成:生成完整视频输出
假设你是前沿实验室,训练下一代前沿大模型大规模语料做分词,送入分布式训练系统。每台加速器反复更新模型权重,直到任务达标;或故障触发部分任务回滚重算。流程:语料清洗 + 分词 → 分布式任务分发 → 参数更新(梯度计算) → 效果评估 + 故障恢复计算公式:加速器数量 × 运行时长 × 单价
计算结果示例
总加速器小时:2.16 亿小时算力账单:9.72 亿美元
计算式:10 万加速器 × 2160 小时 × 4.5 美元 / 小时 = 9.72 亿美元
这是可调整的零售等效算力模型,不等于实验室真实预算。前沿实验室可能自建基础设施,或拿到大幅优惠的商务价格。
20 套公开 MLPerf 系统,覆盖 5 项实测训练工作负载,可通过 API 查询。推理估算参考英伟达 Llama3.1 优化文档与 AWS EC2 容量块定价。
内部构成:3 大组件,配套供应商与来源 | 市场参与主体:9 家企业
08 经济学模型
企业需要先投入基础设施,之后才能获得收入。采购承诺与建设支出最先体现为现金流出,之后计入固定资产,再逐年折旧。投资回报取决于算力投产时间、资源利用率、客户付费价格,以及系统总产出。
-
资本开支:4252 亿美元,在收入回流前投入 -
资产负债表:完工设备计入固定资产 -
折旧:每年确认 1307 亿美元成本 -
投资回报:资产生命周期内,收入必须覆盖折旧、电力与运维成本
四大算力建设企业最近财年资本设备总投入 4252 亿美元。大量投入发生在算力正式对外可用之前。
4252 亿美元,在收入回流前投入
会计上将完工设备记为资产,而非当期费用。体现在资产负债表的不动产、厂房与设备科目,总额 1.18 万亿美元。
完工设备计入固定资产
成本分期计入利润表:在资产预估使用年限内分摊,每年约 1307 亿美元折旧。
每年确认 1307 亿美元成本
这笔投资能否盈利,取决于资产生命周期内,算力带来的收入能否覆盖折旧、电力与运维开销。
资产生命周期内,收入必须覆盖折旧、电力与运维成本
基础设施如何影响利润表:资本开支转化为固定资产;折旧在资产年限分摊;回报取决于利用率与定价。
53 家上市公司标准化 SEC 披露数据,展现算力扩建的时间特征。资本开支远高于当期折旧,也就是说今天大量投入,要在未来数年才逐步体现在企业盈利中。

图 5
纵轴:金额(美元,对数刻度);企业:亚马逊、微软、谷歌、甲骨文、Meta、美光、CoreWeave、杜克能源、Nebius蓝色:最新财年资本开支;红色:折旧与摊销
图 5:头部基建企业最新财年资本开支(蓝色)对比折旧摊销(红色),对数坐标。不动产、厂房设备与资本开支包含非 AI 资产,不能直接等同于 GPU 库存。来源:SEC EDGAR 公司 XBRL 财报数据
从资本投入到 token 产出
GPU 小时代表硬件租赁成本,但不能衡量硬件实际完成工作量。实际产出取决于吞吐、利用率、延迟、可用率、能效。资本投入换来可通电算力;软件与运维决定算力中有多少是有效产能;有效产能最终产出 token。
兆瓦是功率单位(单位时间能耗),因此每兆瓦 token 对比,必须附带时间口径。模型同时给出每秒每兆瓦 token与每兆瓦时 token。所有对比必须固定模型、工作负载、精度、延迟与质量目标。
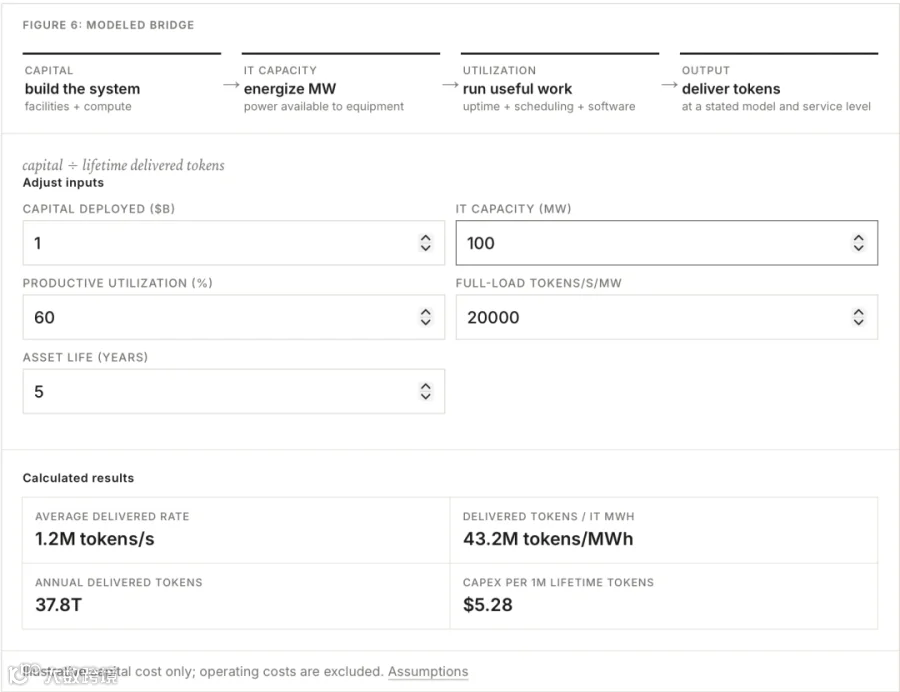
图 6:链路模型
资本投入(建设园区 + 算力硬件)→ IT 算力容量(通电兆瓦,设备可用电力)→ 资源利用率(有效工作负载,包含可用率、调度、软件)→ 产出(在指定模型与服务水平下交付 token)
公式:资本投入 ÷ 资产全生命周期总 token
可调输入项:资本投入(十亿美元)、IT 算力容量(兆瓦)、有效利用率(%)、满负载吞吐(token / 秒 / 兆瓦)、资产使用年限(年)
计算结果示例
平均总吞吐:120 万 token / 秒产出密度:4320 万 token / 兆瓦时年度总产出:37.8 万亿 token单位资本成本:每百万生命周期 token 投入 5.28 美元
仅为资本成本示意模型,不含运营成本。来源:https://intelligence.mts.now/compute#factory-methodology
内部构成:4 大组件,配套供应商与来源 | 市场参与主体:9 家企业