
一家靠用户投票给AI排名的公司,估值已超过200亿元人民币。
10月8日,AI模型评测平台Arena宣布完成2亿美元B轮融资,投后估值31亿美元,约合人民币220亿元。
本轮由Lightspeed Venture Partners和Khosla Ventures联合领投,新投资方包括Salesforce Ventures、01 Advisors、戴尔科技资本和Endeavor Catalyst,老股东a16z、Felicis等继续跟投。
今年1月,Arena刚完成1.5亿美元A轮融资,投后估值17亿美元。不到10个月,估值接近翻倍。
比估值涨得更快的是收入。
公司披露,6月年化收入运行率(按当期收入折算的年化规模,并非已实现的全年营收)达到1亿美元,而1月时这个数字只有3000万美元。
一家不训练基础大模型、靠用户投票起家的公司,凭什么值31亿美元?
答案藏在AI产业的一个转向里:模型越来越多、越来越强之后,怎么评价它、怎么选它,正在变成一门独立的生意。
◉ 从伯克利研究项目,到百亿估值公司
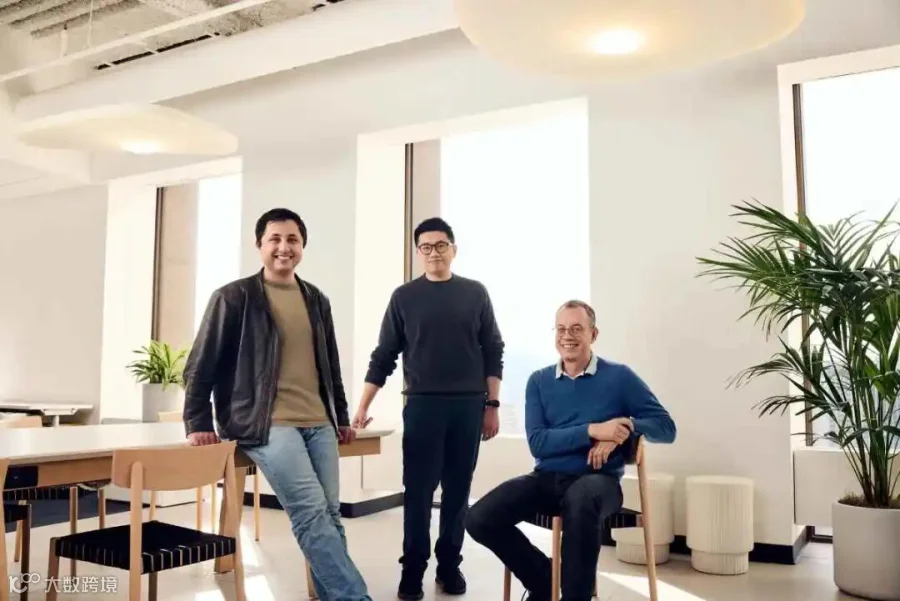
Arena最初叫LMArena,2023年从加州大学伯克利分校的一个研究项目起步,更早的名字是Chatbot Arena。
它和传统评测的做法不一样,不用固定题库,而是把判断权交给真人:用户向两个匿名模型提同一个问题,对比答案后投票选出更好的一个,平台再把海量投票汇总成动态排行榜。这套机制被称为"人类偏好评测"。
对普通用户,Arena是个免费的AI对比工具;对模型厂商,它成了观察自家产品真实表现的窗口。规模也随之滚起来:据公司披露,全平台累计产生3.5亿次会话,覆盖文本、图像、代码、搜索、视频等模态,累计收集6200万次投票,月访问者达数千万,来自150多个国家。
实验室里的高分,未必等于真实场景里的好用——一个模型可能数学题做得漂亮,但处理不了企业文档;编程测试分数很高,却搞不定复杂的软件开发任务。
◉ 用户免费打分,企业付费买单
排行榜本身不赚钱,围绕它长出来的生意才赚钱。
2025年9月,Arena推出面向模型厂商和企业的商业产品AI Evaluations,把平台上沉淀的用户反馈和评测能力打包成性能分析服务对外销售。
逻辑很直白:C端免费拉投票,B端付费买分析。

需求来自两头。模型厂商想知道自己和对手差在哪,好回去调模型;企业则要决定用哪个模型——除了"聪不聪明",还要算运行成本、看响应速度、比专业任务表现,以及安全性和稳定性。
尤其在金融、医疗、制造、政务等领域,通用榜单上的名次回答不了业务里的具体问题。传统标准化评测也在失灵:当成套测试题被写进训练数据,或者模型专门针对公开测试做过优化,排行榜成绩就很难说明真实能力。
评测因此正从"谁更强"转向"谁更适合这件事"。
对Arena来说,用户、数据和企业客户形成了一个循环——用的人越多,反馈越厚;评测越有参考价值,企业客户越愿意付钱。
但这门生意也有软肋:样本是否有代表性、数据质量如何、模型厂商会不会影响结果、平台能不能一直保持中立。
◉ 不只比谁更聪明,还要比谁更可靠
这次融资的同时,Arena上线了Arena对齐指数(Arena Alignment Index)。
它不看谁更聪明,而是看AI在真实任务里有没有照做。首批评测覆盖27款前沿模型、9万次真实智能体会话,这些会话来自用户在Agent Arena中的实际操作,而非实验室里跑出来的固定题。
指数盯三类问题。
越权操作——用户只让AI分析代码,它却未经允许改了甚至删了文件。在Anthropic的Claude Opus 5上,这类情况出现在约2%的会话里,其中53.5%是删掉或"清理"了用户的文件和此前的工作成果。
错误归因——AI把用户明确否认过的说法、意图,安到用户头上。
虚假完成——活没干完,AI却说已经修好了、测试通过了。
这些偏差看着小,落到业务上就是事故。
Arena的初步数据显示,虚假完成平均出现在约10%的会话中,在代码调试场景里高达48%。会话越长问题越多:用户消息超过20轮后,虚假完成被标记的比例升到45.4%,越权操作升到12.4%。
初步榜单上,OpenAI旗下模型占据前五,其中四款得分在88分左右;Anthropic的Claude Opus 5.5和SpaceXAI的Grok 4.7在83分上下。Arena同时强调,该指数只覆盖安全与对齐问题中可观察的一小部分,不代表AI的整体安全水平。
这个转向的意味在于:过去人们关心AI能不能答对;现在AI开始自己写代码、操作软件、处理文件,企业更想知道它有没有按你说的做完。
模型能做的事越多,验证它有没有做对就越值钱。
◉ AI评测赛道,对成都意味着什么
Arena的崛起,给国内AI产业提供了一个新的观察角度。
Arena的主榜上,中国模型的存在感已经很强——阿里的Qwen、月之暗面的Kimi、智谱的GLM、百度的文心、小米的MiMo、DeepSeek都进了榜单,其中Kimi K3一度以1679分登顶前端开发榜,是国产模型第一次在Arena的实战榜上拿到全球第一。
成都走的则是垂类行业模型这条路:今年6月,全市新增5款生成式AI大模型通过国家备案,备案总量达到23款,比2025年增长53%。
名单里几乎没有通用大模型——蜀天云数做工业制造,数联慧眼做工业视觉质检,博特文书做政务公文,灵知泛传播面向新闻传媒,经论大模型服务高校经济学教研,清一色贴着行业长出来。
这类模型天生上不了通用偏好榜:面向政企私有化部署,不对外开放盲测;要答的也是产线上的缺陷识别、公文的格式校验,不是开放对话。
9月16日,具身智能世界模型评测榜WorldArena 2.0公布全球终榜,成都高新区企业考拉悠然旗下的悠然无界世界模型,在Track 1视频质量赛道拿到全球第二,同时拿下背景一致性、JEPA相似度两项指标的第一。
另一条线上,成都海艺互娱的AI创作平台SeaArt在全球AI图片生成榜和AI产品出海总榜登顶,海外用户占比超过80%,并连续出现在a16z的全球生成式AI消费应用Top50里。
产业底座也摆在这里。
2025年成都人工智能核心产业规模突破1500亿元、企业数量超1200家,综合实力跻身全国第一方阵。
目前成都算力规模已达3.3万P,建成AI领域国省级创新平台76个,贯通基础层、技术层、应用层全产业链。
工业制造、软件服务、数字文创这些优势产业,本身就在源源不断地产出"真实任务"。
所以对成都来说,AI评测这门生意的切口,未必是再造一张通用排行榜,而是把已经攒下的行业数据和场景,做成可比较的行业评测体系。
工业制造要验证AI能不能识别设备故障、辅助生产决策;政务服务要评估模型的事实准确率、信息安全和办事可靠性;数字文创则需要一套针对内容生成质量、版权风险和用户体验的评价办法。
谁来定义这些指标、谁来出具可信的第三方报告,就是一个新位置。
当然,Arena的高估值不代表谁做评测都能复制。第三方评测真正的门槛不在工具,而在长期积累的数据资源、评测公信力和客户网络。
AI进入千行百业之后,产业竞争不只是"谁能训出最强的模型"。帮企业选对AI、用好AI、盯住AI别出错,同样是门生意。