

智猩猩AI整理
编辑:林夕
近日,计算机视觉领域知名学者、MAE(掩码自编码器)与 MoCo 系列工作的主要作者何恺明,参与了一项名为 VISTA 的新研究。
这项工作将目光投向了一个正在成为大模型研究重点的方向:Agent 如何在陌生环境中理解世界、积累经验,并通过连续行动完成任务。
论文题为《VISTA: A Visual Harness for Reasoning in an Interactive World》,由 Qiushi Han、Keya Hu、Linlu Qiu、Cathy Wu 和 Kaiming He 共同署名,来自麻省理工学院(MIT)。

相关研究页面于今年8月发布,论文预印本于10月1日上线。
实验中,VISTA 搭配 Claude Opus 5.0,在 ARC-AGI-3 的25款公开游戏中全部通关,RHAE(相对人类动作效率)得分达到100。
论文还报告,模型完成任务所需的动作数量比首次参与游戏的人类玩家减少了57.4%。
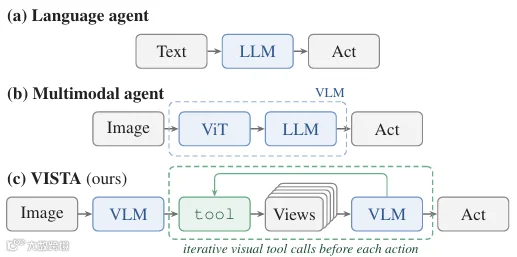
VISTA 与其他 Agent 设计的对比
01
从静态推理走向交互世界
ARC-AGI-3 与传统视觉问答不同。模型进入游戏时,通常不知道物体代表什么、规则如何运作,也不清楚最终目标是什么。
它必须通过观察和行动寻找线索,再根据环境反馈修正判断。进入后续关卡后,还要判断此前发现的规则能否继续使用。
VISTA 选择了另一条路线:让模型直接接收视觉画面,同时保留完整的历史画面,并允许模型主动检索、放大和重新组织这些信息。
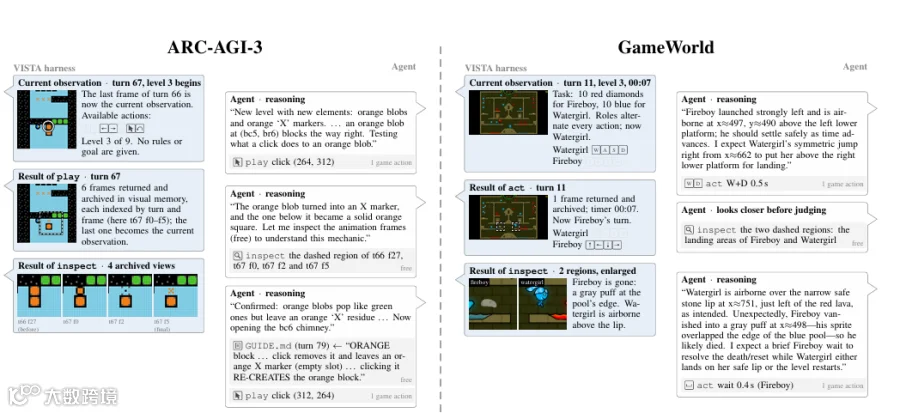
VISTA trajectories on ARC-AGI-3 and GameWorld
VISTA 的设计主要包含三个环节:视觉输入、自然语言推理和无损视觉记忆。
首先,系统直接将游戏画面以 PNG 图像形式交给模型,避免必须先将场景转换成复杂的符号表示。
模型可以观察物体的位置和空间关系,也能按需放大局部细节。
其次,模型通过自然语言记录发现的规律、提出假设,并根据实际操作结果调整判断。
它不必一开始就构建出完整的游戏规则,可以在探索过程中逐步理解环境。
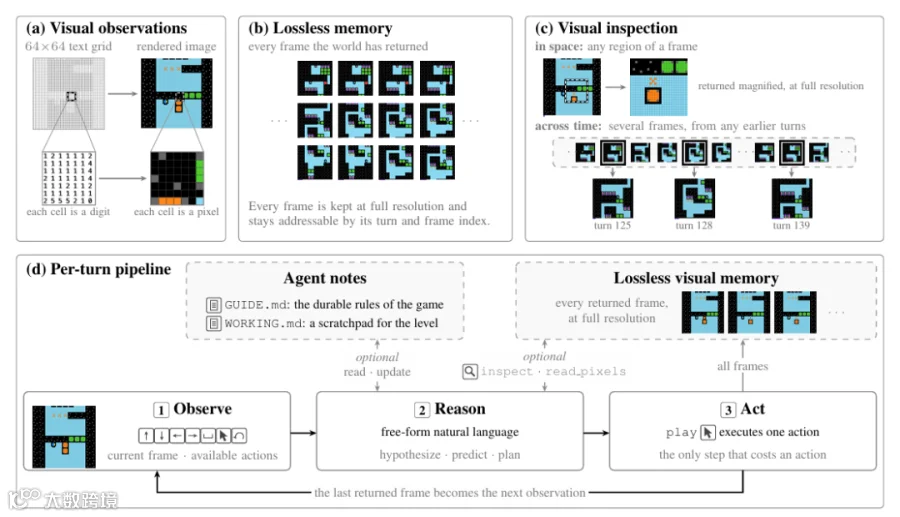
VISTA 的整体系统设计与交互流程
更关键的是视觉记忆。
随着任务持续推进,历史信息会越来越多。如果只保存文字摘要,重要细节可能丢失;如果把全部画面始终放进上下文,又会带来额外开销。
VISTA 会保留交互过程中产生的原始画面,允许模型在需要时重新查看某一帧、放大局部区域,或读取更细粒度的像素信息。
与此同时,系统通过笔记保存可复用的游戏规律和当前关卡的临时发现。
当上下文接近容量上限时,模型也可以整理当前状态,在新的上下文中继续任务。
模型既能通过笔记概括经验,也能在遇到疑问时重新调取原始画面,核对先前的判断。

模型主动调用历史视觉记忆的示例
02
25款游戏全部通关,
动作效率达到满分
在核心实验中,研究团队使用 Claude Opus 5.0 和 GPT-5.6 Sol 两种通用多模态模型作为基础模型,分别在 ARC-AGI-3 的25款公开游戏中进行测试。
其中,Claude Opus 5.0 配合 VISTA 完成全部183个关卡,25款游戏全部通关,平均 RHAE 得分达到100.00。
根据论文摘要,相比首次参与游戏的人类玩家,它完成任务所需的动作数量减少了57.4%。
25款 ARC-AGI-3 公开游戏的系统对比

研究团队还进一步拆解了 VISTA 的设计,测试不同组件对成绩的影响,包括图像输入方式、上下文容量、视觉记忆、主动检查和像素读取等。
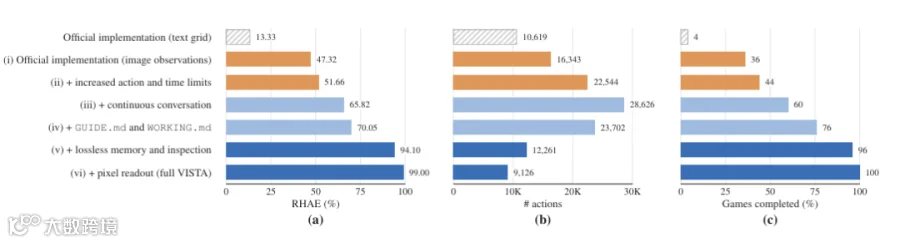
Harness configurations on ARC-AGI-3
VISTA 的实验并没有止步于 ARC-AGI-3。
论文还在另外三个基准上进行评估,分别覆盖交互式游戏、游戏商店中的游戏任务,以及静态视觉谜题。
其中,GameWorld 和 AI GameStore 涉及交互环境,BabyVision 则主要评估静态视觉任务。
研究团队报告称,VISTA 在这些基准上也明显优于使用相同基础模型、但 Harness 更简单的对照系统。

Evaluation environments and results
不过,视觉游戏和真实世界仍然存在明显差异。
现实环境中的 Agent 需要处理更复杂的目标、更多类型的反馈,以及更难预测的状态变化。
当前研究还不能证明同样的设计已经足以解决这些问题。
研究团队也在论文中承认,基础模型自身的能力是实验成功的重要因素。
此外,由于所使用的模型发布时间晚于 ARC-AGI-3 公开游戏,研究无法完全排除这些游戏曾出现在模型训练数据中的可能性。
真正检验泛化能力,仍然需要更严格的未见任务评测。
03
从视觉理解到长程Agent
何恺明此前的代表性研究主要集中在计算机视觉与视觉表征学习。
VISTA 则将视觉能力放进连续交互的环境中,关注模型如何观察、积累经验,再据此采取行动。
这项研究传递出的信号是:提升 Agent 能力,除了继续训练更强的基础模型,还可以改进模型与环境交互的方式。
让模型直接观察世界,保留完整的历史证据,并在需要时主动调用经验。
VISTA 尝试用一套相对简洁的框架,将这些环节连接起来,为多模态模型走向长程交互任务提供了新的探索方向。
END
关注+星标,获取AI前沿进展与开源一线动态