


{
参数估计与职场求职
}
星辰 Career
在现代职场中,求职者不仅需要展示他们的技能和能力,还需要深入了解与参数估计相关的概念,如最大似然估计(MLE)和最大后验估计(MAP)。这些统计方法不仅在数据科学领域有用,还可以为您的职业发展提供重要见解。本文将探讨MLE和MAP的关系,并如何将这些概念应用于求职过程中,以提高自己在竞争激烈的求职市场上的竞争力。

星辰 Career
当涉及到参数估计方法时,最大似然估计(Maximum Likelihood Estimation,MLE)和最大后验估计(Maximum A Posteriori Estimation,MAP)是两种常见的方法,它们在处理参数的先验分布方面存在不同。
在MLE中,我们假设参数是未知的常数,没有涉及到参数的概率分布。相反,在MAP中,我们认为参数符合一个给定的概率分布,这是我们的先验知识。以抛硬币的正面朝上的概率为例,MAP的观察者可能会认为这个概率在[0, 1]区间内是均匀分布的。
为了更好地理解MLE和MAP之间的关系,我们需要引入贝叶斯公式,该公式如下:
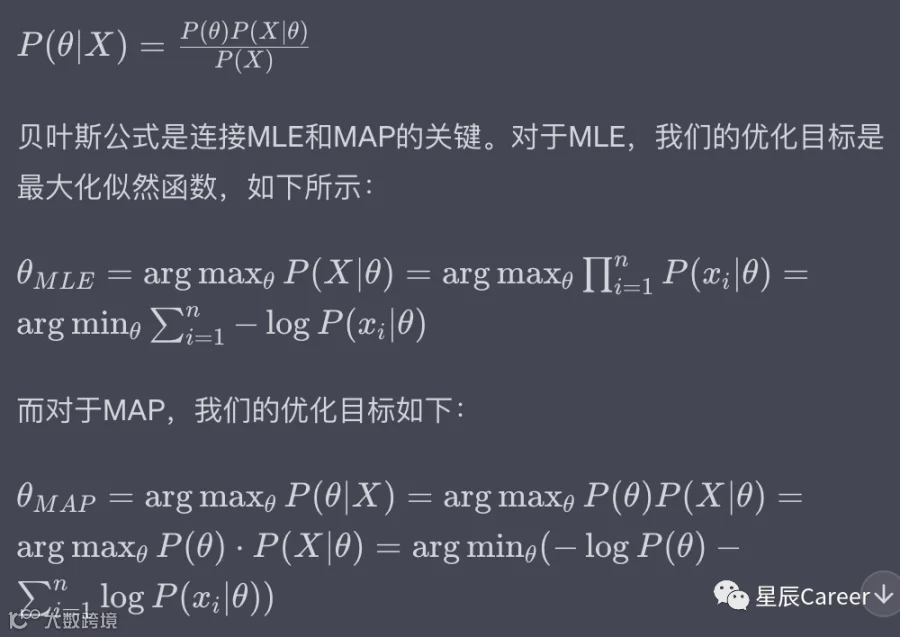
在MAP优化目标的第二步中,对于给定的数据集,P(X) 被视为一个常数,无需优化,因此直接省略。
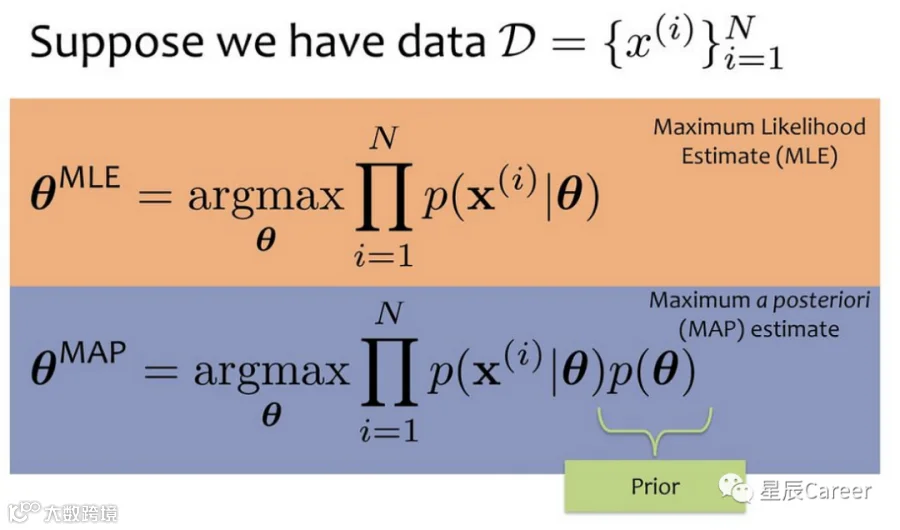
可以看到,MLE和MAP的优化目标仅相差一个项−log�(�)−logP(θ)。因此,在机器学习实践中,可以将MAP视为MLE中增加了一个正则项的情况。例如,在Weight Decay(权重衰减)中,我们将参数尽量接近零视为一个先验认知,这就相当于在MLE中引入了正则项。
如果我们对参数�θ没有特定的先验认知(认为它符合均匀分布),那么MAP就会退化为MLE。
综而言之,MLE和MAP是参数估计的两种方法,它们之间的关系在于MAP引入了对参数的先验认知,这相当于在MLE中加入了正则化项。根据问题的具体情况,选择适当的方法是非常重要的。
就像MLE和MAP之间存在着紧密联系一样,职场中的求职过程也与这些概念有关。了解你的技能和经验如何与职位要求匹配,可以帮助你选择适合自己的职业道路。而在不断提升自己的同时,还可以利用社交网络和内推机会来扩展职业机会。与参数估计一样,职业发展需要积极的心态、深入了解和不断的学习。通过将这些概念应用于你的求职策略,可以更好地实现职业目标,获得令人满意的职业机会。无论你的求职目标是什么,始终相信自己的能力,坚持追求成功。希望这些概念对你的职业发展提供有益的指导。

END
在我们的订阅号中,我们将为你提供丰富多样的内容,涵盖各个领域的精彩文章、独家资讯和实用技巧。我们致力于为你呈现有价值、有趣且具有启发性的内容。
如果喜欢我们的内容,记得给我们一个赞,是对我们团队的鼓励和肯定。你的点赞和评论将激励我们不断创作更多优质的文章和分享更多有益的知识。
感谢你的关注和支持!让我们一起探索更多精彩内容,共同成长和学习。如有任何问题或需求,请随时与我们联系,添加下方微信。期待与你的互动!
快来联系我们吧!Offer等着你!
微信号 | XC--Daisy
联系人 | Lucy老师
公司邮箱|StarsConsulting@hotmail.com
(邮箱标注来意)