点击上方蓝字「羽飞智能」关注我们

7月16日深夜,北京创业公司月之暗面发布了新模型Kimi K3。第二个交易日,台积电股价跌了7%,软银跌了9%。《财富》杂志给这场波动起了个名字:第二次DeepSeek冲击。这一次的主角,是一批可以免费下载的中国大模型。

来源:《财富》(Fortune)报道页截图(2026年7月17日)
所谓"第一次冲击",指2025年初DeepSeek用远低于同行的成本训练出接近顶级水平的模型、引发美股AI板块大跌的那一轮。当时不少人把它当作一家公司的偶然爆发。一年半之后,同样的剧本在更大的规模上重演,主角从一家公司变成了一批公司。
一个月里,前沿模型接连免费公开
先把时间线摆出来。6月中旬,智谱(z.ai)发布GLM-5.2;6月底,美团把自家LongCat 2.0拿了出来,1.6万亿参数,整个训练过程用的都是国产芯片。7月中旬,DeepSeek V4正式版全量上线,开放完整权重。7月16日深夜,月之暗面发布Kimi K3,2.8万亿参数,迄今规模最大的开放权重模型;7月27日,完整权重按约定挂上了开发者平台Hugging Face,截至8月1日下载量已超过56万次。7月17日到20日,世界人工智能大会在上海举行,超300款新品全球首发,多家厂商的开源模型同台亮相。
南华早报7月17日的报道梳理过一组数字:此前中国最大的开放模型是DeepSeek的1.6万亿参数V4-Pro,智谱GLM 5系列为7440亿参数。Kimi K3把最大值直接翻了近一倍。按月之暗面自报的测试成绩,K3在多项评测中超过了GPT-5.5、Claude Opus 4.8等闭源模型;公司同时承认,整体性能与最强的闭源旗舰仍有差距。
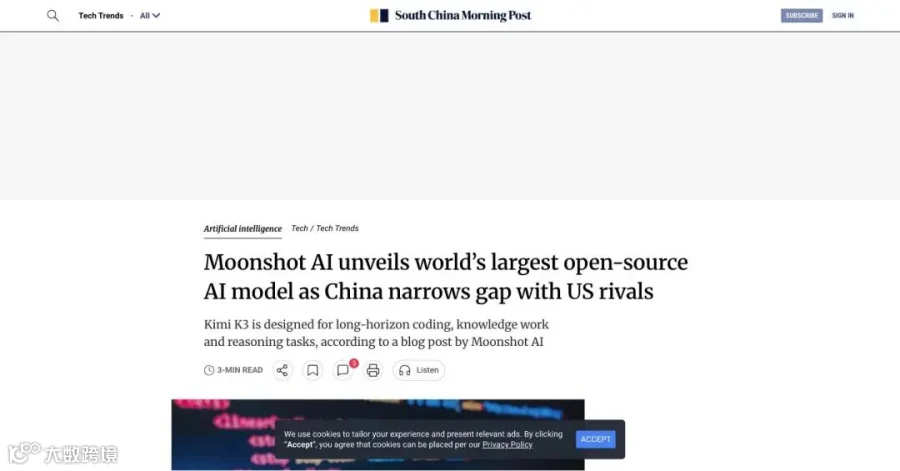
来源:南华早报(SCMP)报道页截图(2026年7月17日)
开放权重,先用大白话讲清楚
开放权重的意思,是把训练好的模型文件整个放到网上,任何人可以下载、修改、装进自己的服务器运行。打个比方:一家名店把招牌菜的完整配方连同火候细节全部公开,任何餐馆都能拿回去照做,还允许改良之后挂自家招牌卖。
这和平时用的免费网页版是两回事。用网页版是去别人店里吃饭,数据要送出门;下载权重是把配方搬回自己厨房,菜在自家做,数据不出门。对在意合同、图纸、客户资料安全的行业,这一点比价格更重要。
配方免费,厨房不免费。跑一个2.8万亿参数的模型,需要成排的GPU和可观的电费。所以开放权重改变的是分工:模型本身不再稀缺,稀缺的是把它跑起来的算力,和把它用进业务的能力。

来源:Hugging Face月之暗面主页截图,Kimi-K3权重已开放下载(2026年8月1日)
价差已经拉到上百倍
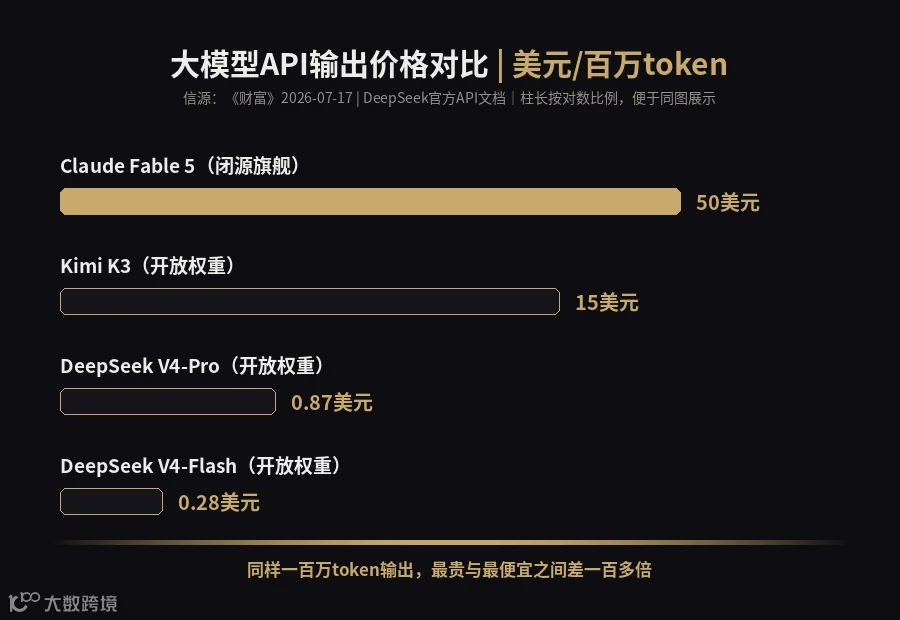
《财富》披露,Kimi K3的API输出价格是每百万token15美元,Anthropic同级别的Fable 5是50美元,前者约为后者的三成。DeepSeek更极端:官方文档显示,V4-Pro每百万token输出0.87美元,轻量版V4-Flash只要0.28美元,与最贵的闭源旗舰之间差了一百多倍。
国内的报价单更直观。据澎湃新闻6月29日报道,V4-Pro输出价格平时为每百万token6元,高峰时段12元,缓存命中的输入低至几分钱。一百万token大约相当于几十万汉字。按官方价格粗算,每天上千条客服问答的输出量,用轻量版模型的费用折合人民币一两元。价格降到这个量级之后,很多过去"算不过账"的用法开始成立。
便宜带来了真实的用量。开发者平台OpenRouter的周度用量榜上,前五名眼下全部是中国公司的模型:腾讯、小米、DeepSeek、MiniMax、z.ai。美国外卖平台DoorDash的首席技术官公开表示,正在把大量基础工作交给Kimi处理,"质量更好、成本更低"。美国编程工具Cursor今年3月也承认,其Composer 2智能体建立在Kimi 2.5之上。闭源阵营已经开始降价应对,OpenRouter页面上,GPT-5.6的两个版本挂出了限时五折的促销横幅。
敢卖这么便宜,背后有四个原因
第一,电便宜、机房扩得快。《财富》分析,中国在发电和电网上的长期投入让数据中心扩容更容易;美国不少新机房则因电网负荷和用水争议推进缓慢。
第二,算力受限逼出了工程效率。在高端芯片供应受限的情况下,中国团队普遍采用"混合专家"架构:总参数规模很大,每次回答只调用其中一小部分,算力消耗大幅下降。参数最大不代表每次调用都最贵,账就是这么省出来的。
第三,愿意用利润换市场。免费放权重、低价卖API,先把全球开发者圈进来,行业标准慢慢就长在自己这边。
第四,国产芯片在托底。美团的LongCat 2.0从头到尾用国产芯片训练;DeepSeek V4适配了华为芯片。硬件采购成本更低,价格自然压得下来。
便宜也有代价。DeepSeek在正式版上线的同时宣布峰谷计价:每天9点到12点、14点到18点,API价格翻倍。官方解释是为了更合理地配置资源;直白地说,算力不够用了。

来源:DeepSeek官方API文档定价页截图,含峰谷计价说明(2026年8月1日)

产业链全景:每一环都被重新算账
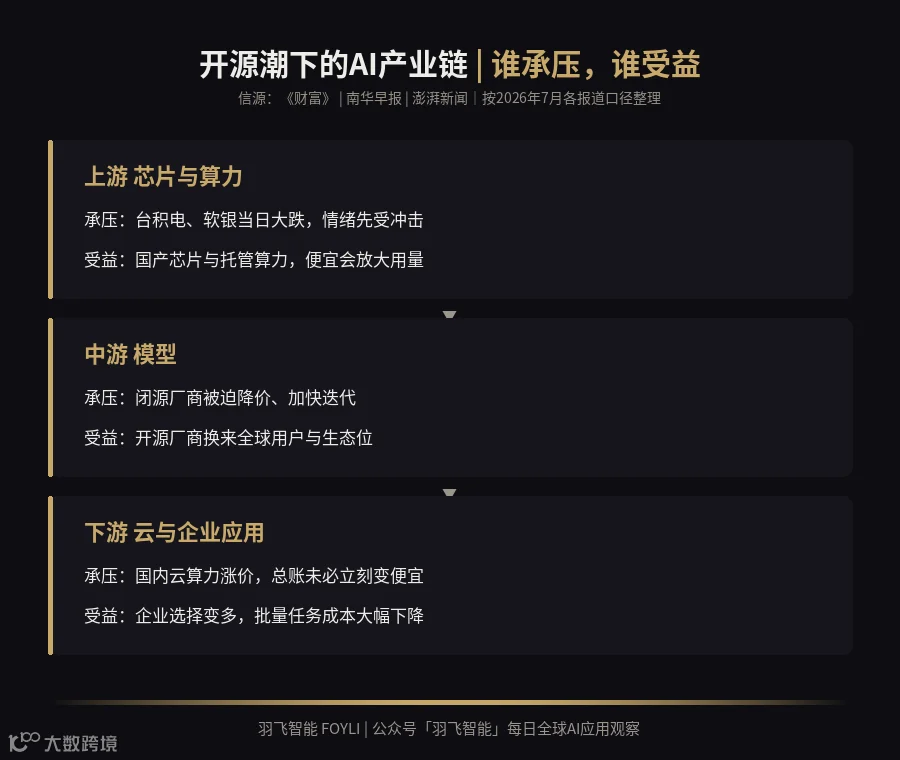
上游,芯片与算力。冲击首先打在情绪上:K3发布次日,台积电在公布单季营业利润大涨77%的财报之后仍然跌了7%,英伟达市值一度被苹果反超。另一面,模型便宜会放大调用量,长期看算力需求未必减少;国产芯片是明确的受益方,训练和推理两头都在往上接单,提供托管算力的服务商也在承接开源模型带来的部署需求。
中游,模型公司。闭源厂商被迫降价、加快迭代节奏;开源阵营内部竞争同样激烈,z.ai股价在K3发布后的港股交易中一度跌了近30%。免费放出权重的公司要靠API托管、企业定制和后续版本赚钱,这套商业模式仍在验证之中。
下游,云与企业应用。第三方托管平台接住了最直接的红利:开源模型可以自由上架,收的是算力钱。企业端选择变多、单价下探。但有一笔账容易被忽略:据澎湃新闻梳理,国内多家云厂商年内接连上调AI算力相关价格,百度智能云部分产品调价5%到30%,腾讯云年内两次调价,智谱三次上调API价格。模型在降价,跑模型的算力在涨价,总账未必立刻变便宜。
企业端的态度也在变。《财富》同日另一篇报道的标题概括了这个动向:美国同类服务在涨价,更多公司开始试用更便宜的中国模型。前面提到的DoorDash和Cursor都属于这一类,先把要求不高的环节切出去试,跑通了再扩大范围。这套"先切一小块"的做法,比一步到位的整体替换稳妥得多。
省钱的场景,踩坑的场景
适合先上的场景:量大、规则清楚的任务,比如客服问答、单据信息提取、资料摘要、报价初稿。这类任务对模型的聪明程度要求有限,对价格极其敏感,开源模型的性价比优势最大。
要留一手的场景:最难的推理、复杂代码、长链条任务,闭源旗舰目前仍然领先,月之暗面自己也承认这一点。关键业务上省下的这点钱,返工的成本可能更高。
容易踩的坑有三个。一是盲目自建:自己架服务器跑大模型,买卡、运维、电费都是钱,调用量不大时直接用API更省。二是只算模型账、不算算力账:云价格在涨,高峰时段还翻倍,签约前把两笔账合在一起算。三是绑死一家:榜首几个月换一轮,接口设计要留好换模型的余地。
把这个七月放远一点看,一种新的分工正在成型:前沿模型逐渐变成行业的公共基础件,像配方一样公开流通;竞争的重心移向算力、电力,和把AI装进具体业务的能力。配方公开之后,比的是谁的厨房开得动、菜端得出去。
信源:《财富》(Fortune)2026年7月17日;南华早报(SCMP)2026年7月17日;澎湃新闻2026年6月29日;新华网2026年7月8日;DeepSeek官方API文档(2026年8月1日查阅);Hugging Face(2026年8月1日查阅)。文中股价、价格与下载量为各信源披露时点数据。