点击上方蓝字「羽飞智能」关注我们

8月24日,美国斯坦福大学,一年一度的Hot Chips芯片大会上,英伟达把新一代CPU"Vera"的设计细节完整摊开。这颗芯片的主要服务对象不再是人,而是会自己干活的AI智能体。AMD和英特尔的新品同场亮相,全球最有分量的三家芯片公司,第一次为同一类"用户"造芯片。
一颗不为人造的CPU
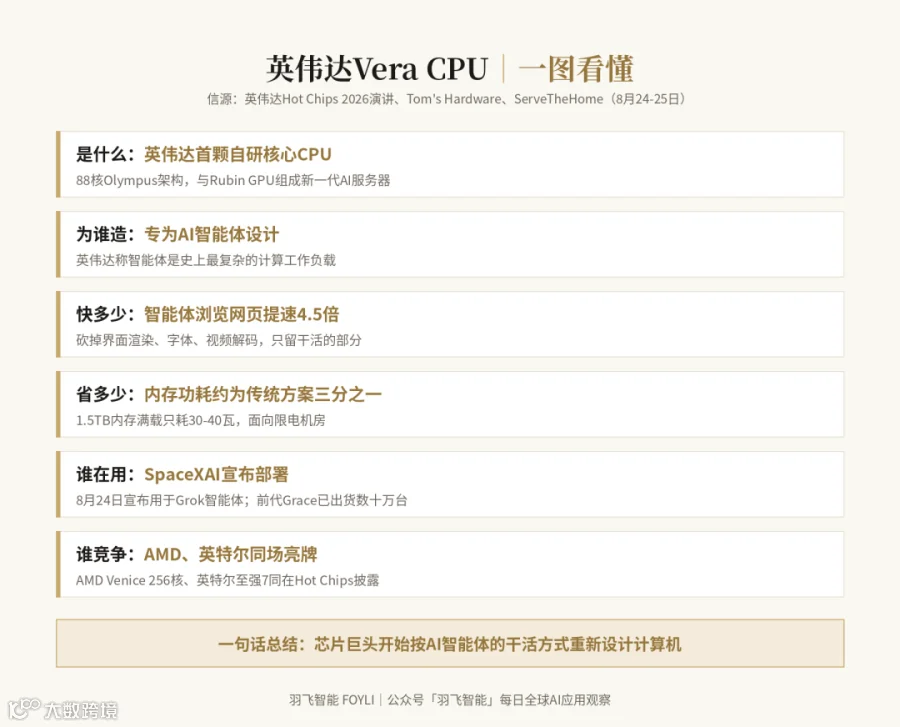
Hot Chips是全球芯片架构师的年度聚会,今年8月23日到25日在斯坦福大学举行,各家公司习惯在这里公开新芯片的内部设计。英伟达8月24日演讲的主角是Vera:它的第一颗采用自研核心的CPU,核心代号Olympus,88核176线程,将与Rubin GPU一起组成英伟达下一代AI服务器。
来源:Tom's Hardware对英伟达Vera CPU的报道(2026年8月25日)
过去几十年,CPU的设计围绕人的使用习惯展开:人点鼠标、开网页、看视频,芯片就为这些动作优化。英伟达这次把设计原点换掉了——Vera为AI智能体服务,并在演讲里把智能体称为"史上最复杂的计算工作负载"。所谓智能体,可以理解为接到任务后自己查资料、自己操作软件、自己把活干完的AI,和只会一问一答的聊天机器人不同。
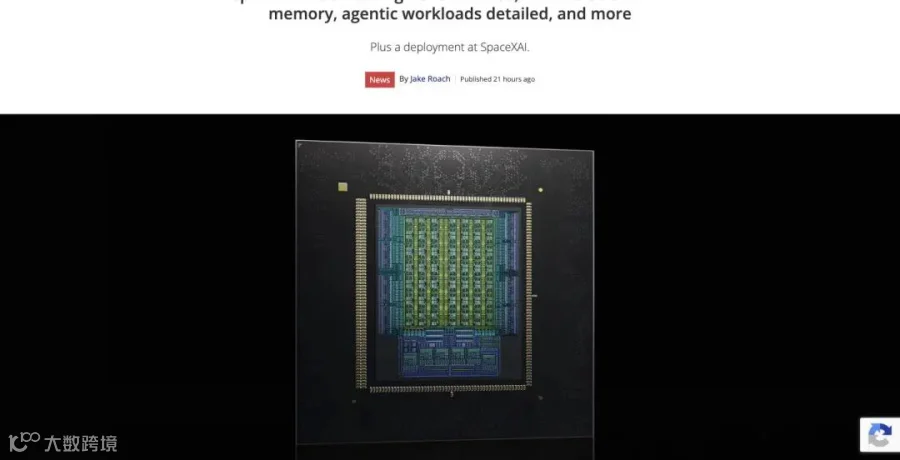
来源:英伟达公布的Vera CPU芯片照,via Tom's Hardware(2026年8月25日)
AI用电脑,和人不一样
英伟达在会上举了个例子:智能体查网页,不需要"看见"网页。界面渲染、字体加载、视频解码,这些为人眼准备的环节全部砍掉之后,同样的浏览流程提速4.5倍。配合这种无界面浏览,Vera跑网页类任务比AMD的96核服务器芯片快24%。
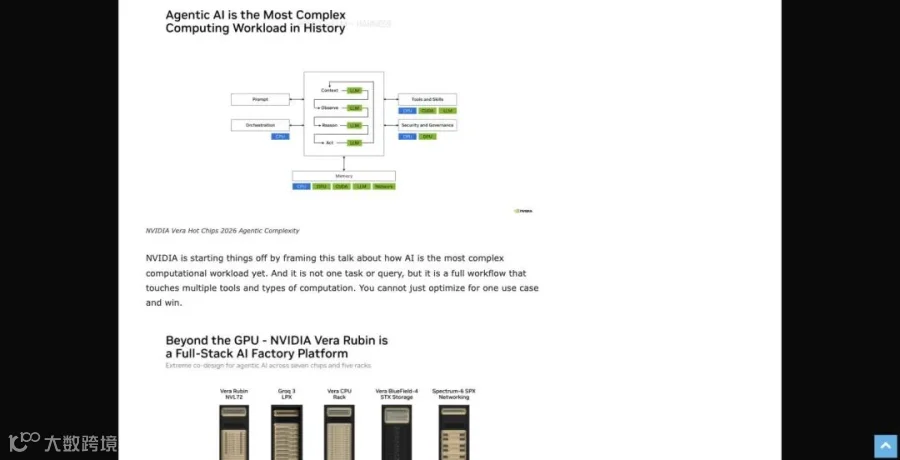
来源:英伟达Hot Chips 2026演讲幻灯片,via ServeTheHome(2026年8月24日)
另一处改动在内存。Vera不用传统的服务器内存条,改用手机同款的LPDDR5X颗粒:1.5TB内存满负荷运转只耗30到40瓦,传统方案轻松超过100瓦。省下的电留给GPU。这背后有个现实:眼下全球新建数据中心普遍受电力供应制约,省电的设计直接决定一栋机房能装下多少算力。
还有单线程性能。智能体干活是一环扣一环的链条:查完资料才能写报告,写完报告才能发出去。链条上每一步快一点,整件事就快一截。Vera把每个核心做大做宽,编译大型软件这类典型的"智能体作业",比同级对手快22%。
三巨头同场亮牌
8月25日,英伟达刚讲完,英特尔在同一个会场披露了至强7,最高256个性能核;AMD在6月发布的Venice同样堆到256核,并公开叫板,称机架层面性能可达Vera的3.3倍。三家参数路线不同,瞄准的都是同一件事:造让AI干活的机器。

来源:Hot Chips大会官网,2026年会议于8月23-25日举行(hotchips.org)
买家也已经出现。8月24日,SpaceXAI宣布将部署独立的Vera服务器,用来跑Grok的智能体任务。英伟达同时透露,上一代Grace芯片的独立服务器已出货数十万台。

来源:英伟达技术博客介绍Vera Rubin平台(developer.nvidia.com,2026年8月)
把这些信号放在一起看,主线只有一条:过去三年,AI行业比拼谁的模型答得好,机器围绕训练来建;现在芯片巨头把设计原点挪到了"干活"上。行业普遍判断,下一阶段的主要算力消耗,来自被派出去做事的智能体,它们需要跑在专门为其优化的机器上。
对生意的三点影响
第一,AI干活的成本会继续降。芯片专门优化后,同样的任务耗电更少、跑得更快,云服务商和AI工具商的成本随之下降,通常会传导到订阅价格上。让AI处理报价单、盯物流、整理投标材料这类事,会越来越接近"用得起"。
第二,AI服务的比拼标准在换。聊天答得好坏难分高下,干活快慢一目了然。往后挑AI工具,可以盯两个硬指标:同样一件事完成要多久,长流程中途会不会断。
第三,不必急着行动。这批芯片要到明年才大规模装进机房,红利会通过主流软件慢慢释放。眼下更实际的准备,是把重复性强、规则清楚的业务流程整理出来,等工具便宜到位,整理过的流程最先接得上。
Hot Chips已于8月25日闭幕。三颗新CPU都还没批量进机房,但设计图已经公开:计算机的下一位主要使用者,是会自己干活的AI。
信源:英伟达Hot Chips 2026演讲(2026年8月24日);Tom's Hardware(2026年8月25日);ServeTheHome(2026年8月24日);NVIDIA Technical Blog;Hot Chips大会官网。关键数字为厂商披露口径。