点击上方蓝字「羽飞智能」关注我们
东盟日本AI观察 · 第31期|2026年9月26日
一款AI能用泰语聊天,还能不能找到适用的当地法条?能写出越南语文案,是否了解不同地区消费者的生活背景?对进入东盟市场的产品来说,这些问题会直接影响服务能否用起来。
9月22日至23日,英伟达在新加坡举行AI Day活动,集中介绍了东南亚伙伴的模型与应用。其中一条清楚的线索,是把当地语言、行业资料和社会背景补进AI。泰国的法律助手、新加坡的区域模型,以及越南的本地数据集,分别提供了不同做法。
泰国:回答之后,能找到法条吗
英伟达本次介绍的OpenThai 2.0 Legal,是iApp参与开发的泰语法律模型,7月24日已发布。它使用泰语法律数据适配基础模型,并为法律问答助手Thanoy提供支持。iApp在9月24日的说明中列出了法律问答、判决检索与摘要、合同摘要等用途。
这个案例里更有参考价值的设计,是回答可以附上法律名称和条款。根据iApp的发布文档,模型支持结构化输出;配合检索系统时,可以将找到的法条放入上下文,再生成带出处的答复。
对业务使用者而言,出处让复核有了起点。仍要核对原文是否有效、引用是否准确,以及问题的条件是否完整。iApp也明确要求由合格专业人士检查法律引用。这里讨论的是资料检索与辅助整理,不能把带着法条的回答直接当成专业结论。
iApp官方发布图局部|2026年7月24日发布,9月活动再次介绍;非本次实测。
两家公司披露Thanoy约有4.3万名用户,但没有在这两篇说明中给出活跃率、付费率或完整统计周期。这个数字只能说明披露的使用规模,不能据此判断每次回答的可靠性,也不能折算成企业已经取得的收益。
区域模型:把本地语言放进测试题
在活动前的9月18日,AI Singapore发布了Nemotron-SEA-LION-v4.8系列。按官方说明,训练数据覆盖10种东南亚语言;其公开的SEA-HELM评测列出缅甸语、菲律宾语、印尼语、马来语、泰米尔语、泰语和越南语7种语言。训练覆盖范围与这次评测范围并不相同。
这套评测除了语言理解,也检查指令遵循和文化知识等能力。开发方报告称,两种规格的模型在所评估的7种语言上均较基础模型有所改善。这是开发方公布的基准结果,不能直接视为某家企业客服或单据处理的验收结果。
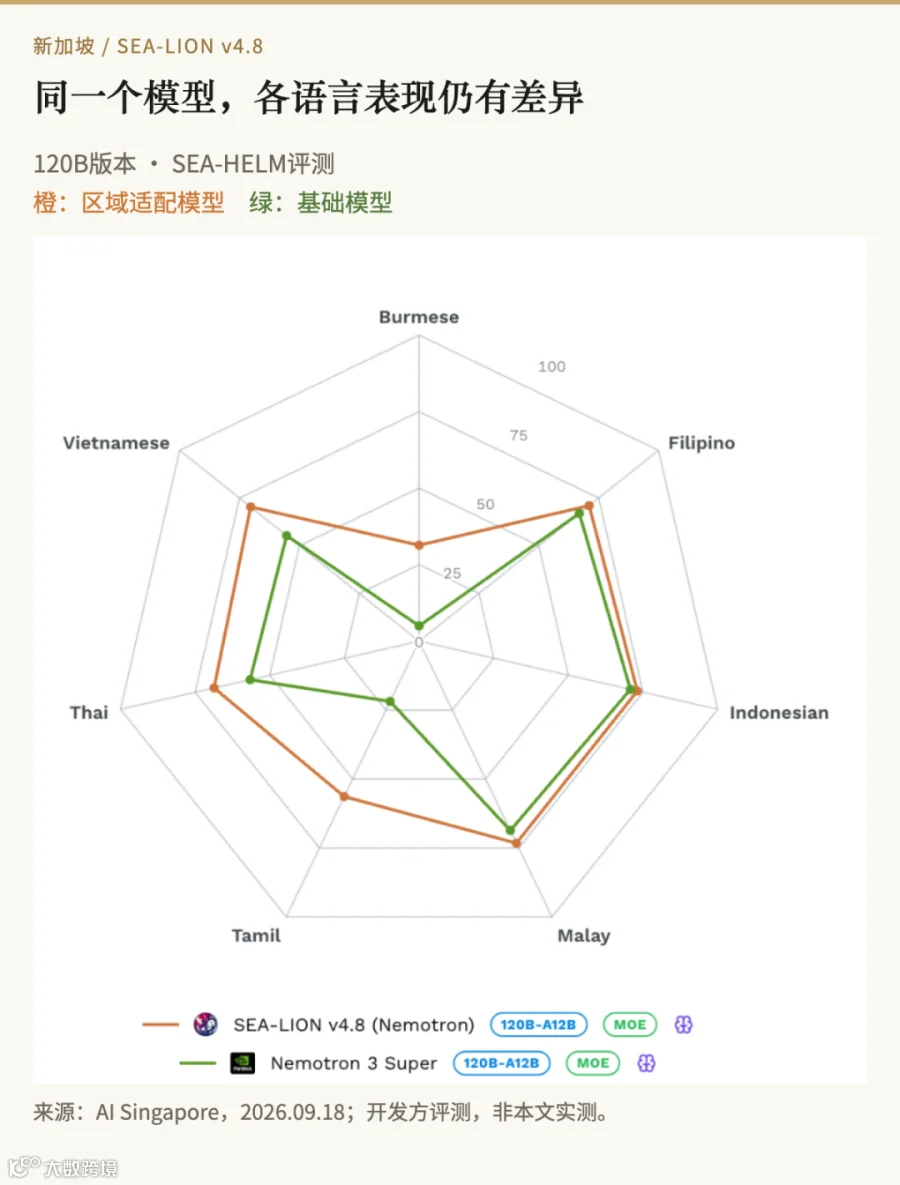
AI Singapore官方评测图局部|120B版本,橙色为区域适配模型,绿色为基础模型;不同语言得分仍有差异。
同样一句“支持当地语言”,落到工作中需要拆开看:是否认得常见简称,能否读懂混用语言的留言,遇到金额和日期时会不会丢失条件。测试可以从业务中挑选一小组脱敏材料,保留标准答案和原始出处,让熟悉当地业务的人逐条复核。
越南:用合成人物,检查服务盲区
英伟达本次还提到FPT参与开发的Nemotron-Personas-Vietnam。FPT早在6月3日已介绍这个开放数据集,因此它是本次活动引用的既有案例。按FPT说明,数据包含90万个合成人物画像,结合当地统计资料组织年龄、地区、职业等信息,供模型训练、评估和模拟使用。
合成人物并非90万个真实客户,模拟结果也不能代替市场调查。它的用途在于扩大测试情境:同一种服务面对不同地区、职业和年龄背景时,AI的回答是否仍然合适。对于团队暂时接触不到的人群,这类资料可以帮助提出测试问题;具体偏好和购买意愿仍需在真实业务中验证。
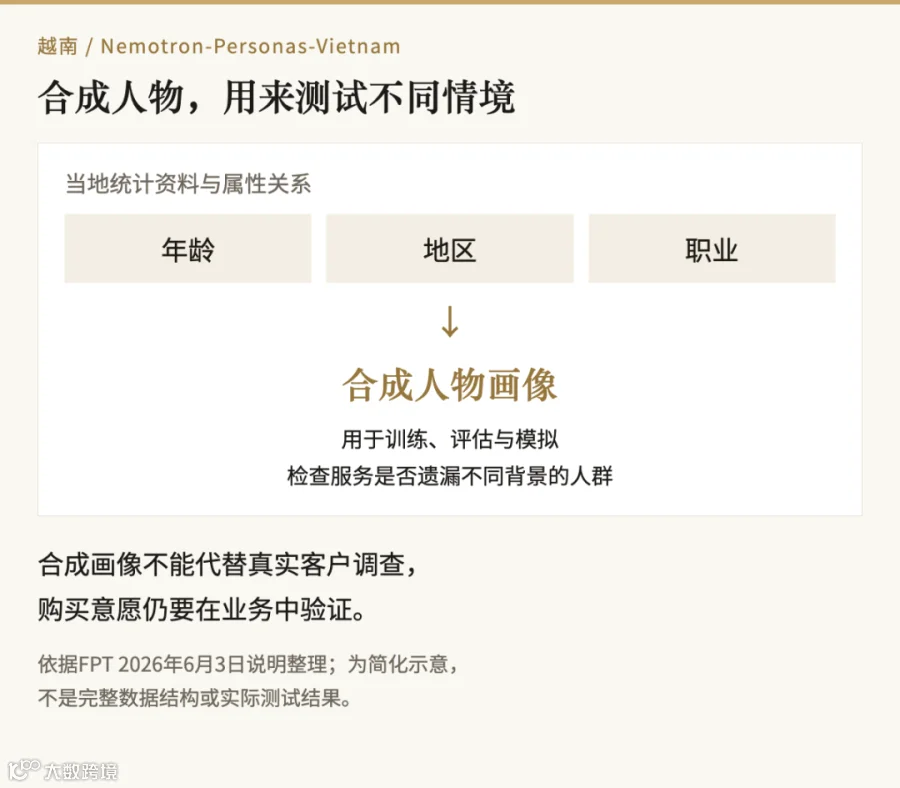
本文依据FPT官方资料整理|数据集于2026年6月发布;合成人物不是真实客户。
落到业务,先确定哪份资料说了算
这些案例给跨境团队的一个实际启发,是在接入AI之前,把本地资料准备得更清楚。产品名称如何翻译,规格和交期以哪个版本为准,售后答复由谁确认,都应当有可追溯的依据。资料本身互相冲突,换一个更大的模型也难以稳定回答。
以跨境定制业务的询盘整理为例,测试可以要求AI保留客户原文,同时提取尺寸、材质、数量与交付要求;没有写明的内容标为待确认。这样既能检查当地语言是否理解准确,也能看出模型有没有擅自补齐交易条件。这是本文提出的测试方式,并非上述产品已经验证的功能成果。
模型是否适用,最终要回到这些具体问题:哪些内容读对了,哪些需要人工重做,出了错能否找到依据。本地语言、可靠资料和业务复核一起准备,才有条件把展示中的能力用到日常工作里。
资料依据:NVIDIA(9月22日)、AI Singapore(9月18日)、iApp(7月24日、9月24日)、FPT(6月3日)。查阅截至2026年9月25日;产品能力与数字按发布方披露,本文未作产品实测。