点击上方蓝字「羽飞智能」关注我们

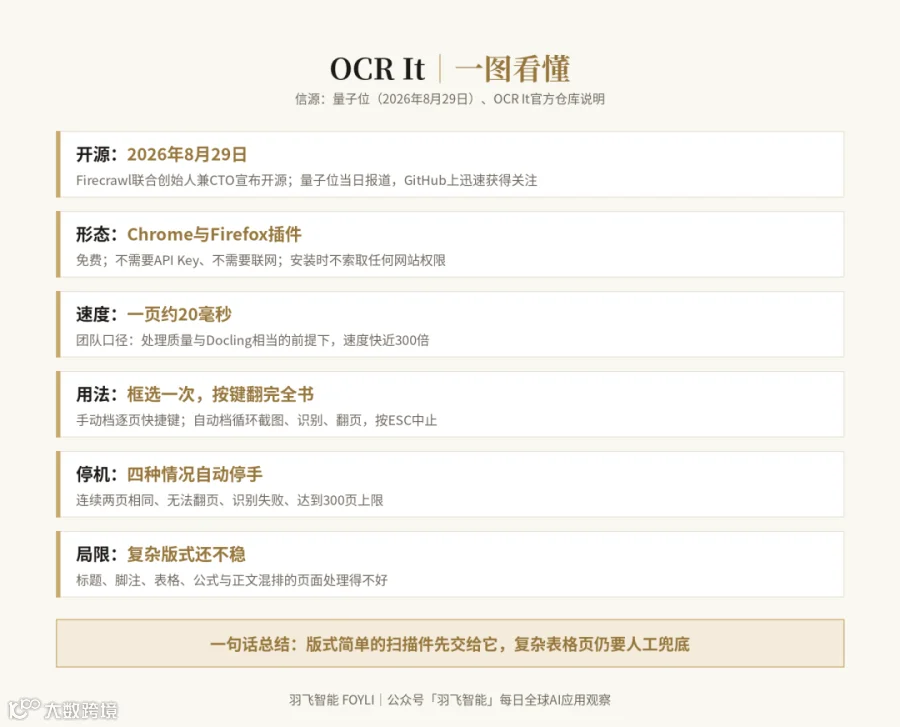
8月29日,Firecrawl团队的联合创始人兼CTO宣布开源一个浏览器插件,名字叫OCR It。它只做一件很窄的事:把鼠标选不中的扫描版PDF,一页约20毫秒转成干净的文本,AI拿过去直接就能读。全程不联网,不要API Key。
一、它对着的那个麻烦
供应商发来的报价单是扫描件。招标文件盖了章导出成PDF。老产品手册是一页页图片拼的。这几类文件有个共同点:肉眼看得见,鼠标选不中。要把里面的数据挪进表格,只能人工照着敲。
现有办法有两条。一条是把文件传到在线识别服务,文件得离开这台电脑;一条是本地装一整套文档解析工具链,装起来费事。OCR It走的是第三条:装个浏览器插件,文件不出本机。
识别引擎用的是Tesseract,直接打包进插件,在本机跑。仓库说明写着:安装时不索取任何网站权限,只在需要自动运行或处理跨域页面时,才按需申请当前站点的权限。合同、报价、员工资料这类不方便外传的文件,这一条比速度更要紧。
二、上手:两档操作
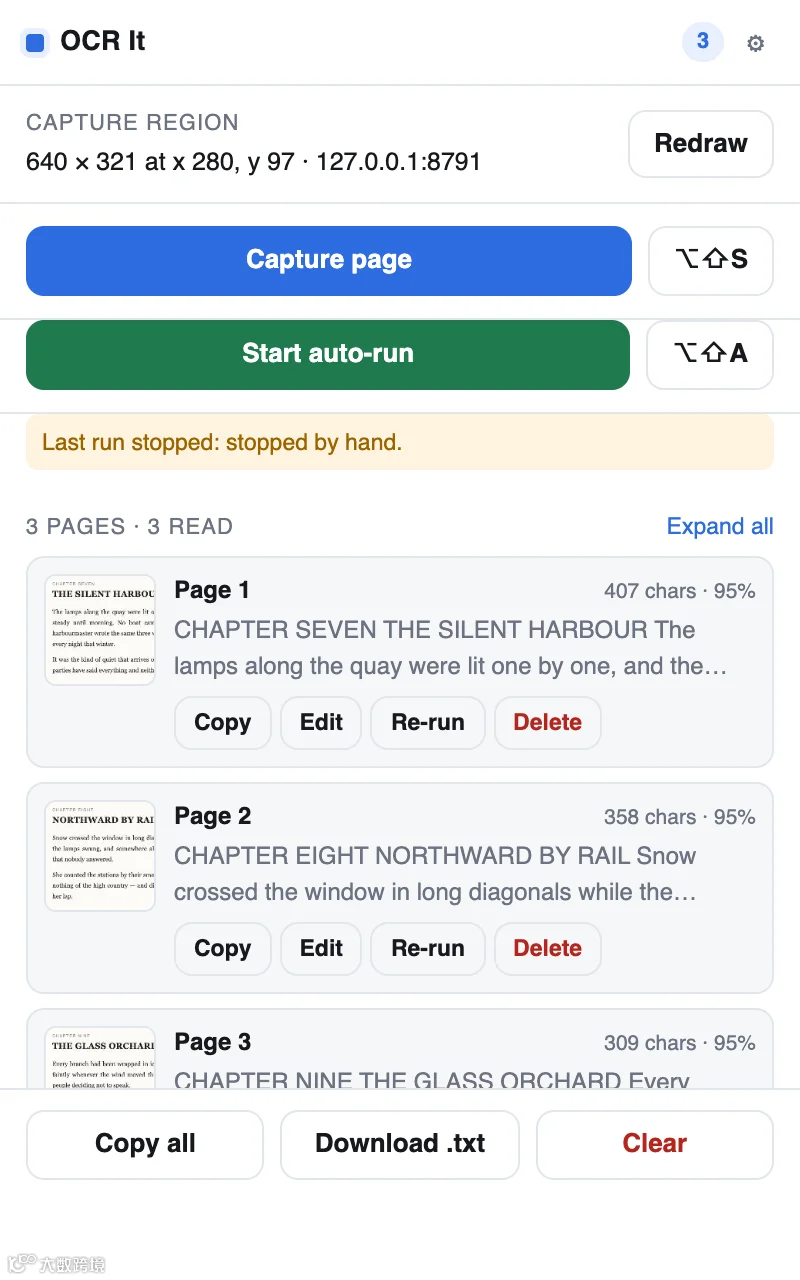
手动档。第一步,按Option+Shift+R框出要识别的区域,确认后按Enter保存,这一步只做一次。第二步,按Option+Shift+S,插件识别当前页,识别完自动翻到下一页,重复到文档末尾。想更省时间,也可以一边翻页一边按Option+Shift+S,截图进后台排队,识别任务自己跑。
自动档。按Option+Shift+A,或者点Start auto-run,插件自己循环"截图、识别、翻页",一直到文档结束。中途要停,按ESC。
收尾。全部识别完,在插件面板里检查和修改文字,某一页不满意可以单独重识别,最后按Copy all复制全文,或者Download .txt导出。Windows和Linux上把Option换成Alt。

三、三条规矩先记住
第一,它会自己停手。连续识别到两张相同页面、翻不动页、识别失败、或者到了300页上限,插件自动停。这条规矩是防止在末页无限重复抓取。
第二,浏览器内置的PDF阅读器暂不支持自动翻页。碰到这类PDF,用手动档过。
第三,300页上限意味着长文档要分批。一本合同汇编、一套竣工资料,得拆开跑几轮。
四、算一笔账
省下来的是工时。一份50页的扫描合同,人工把关键字段敲进表格,手熟的人也要半小时到一小时。批量几十份摆在面前,这笔工时很实在。Docling是常用的开源文档解析工具,近300倍这个对比由团队自己给出,第三方复现结果目前还没有。
五、四条前提
一、复杂版式还不稳。网友实测形成的共识是:版式简单、文字清晰的PDF处理得相当顺手;标题、脚注、表格、数学公式和正文段落混排的页面,还处理不好。工程图纸、多层表头的报表,先别交给它。
二、它只负责变成文本。变完之后的提字段、填表、核对,是另一步。把文本喂给AI做结构化,或者人工过一遍,都得接上,不然只是换了个地方存文字。
三、识别结果要抽检。OCR会认错字,数字尤其容易出岔。金额、日期、单号这三类,建议全部人工复核,其余按比例抽。
四、宣传数字自己验。真要在业务里用,拿自家最典型的十份文件跑一遍,记下识别准确率和处理时间,比看任何倍数都准。
六、先拿这几类文件试
供应商报价单。扫描件转成文本,再让AI提出品名、规格、单价、交期四列,直接进比价表。
招标文件。把技术要求和资格条款抽出来,逐条对照自家条件,标出做不到的项。
验收单与送货单。转成文本后与系统里的单据核对,列出对不上的行,人只看这几行。
产品手册与说明书。转成文本,做成客服能检索的资料库,新人上手不用翻纸质本。
老档案数字化。几年前的纸质合同扫描件,批量转成能搜索的文本,日后调档不用翻箱。
这几类的共同点是:版式简单、文字清晰、量大、结果好核对。带复杂表格、手写批注、盖章压住文字的页面,眼下还是留给人。
OCR It上线才几天,讨论集中在同一件事:快是真的快,复杂页面还不够稳。团队没有给出下一版的时间表。眼下能确定的是它免费、离线、装在浏览器里,试错成本接近于零——拿十份自家最常见的扫描件跑一遍,一小时内就知道它在自家业务里能不能用。
信源:量子位《20ms把PDF变成Markdown!开源OCR神器快了近300倍》(2026年8月29日);OCR It官方仓库github.com/thiagotigaz/ocr-it仓库说明;Firecrawl联合创始人兼CTO在X上的发布。速度与对比数据为开发团队披露口径,第三方复现结果暂未见到。