


点击上方蓝字「羽飞智能」关注我们
8月1日,OpenAI公布了一份249页的论文,说一个尚未公开发布的模型在10道悬置十年以上的数学与理论计算机科学难题上给出了新结果。求解耗掉的算力,按它自家接口的价目折算,约2000美元。
三天之后,另一份借助AI做出来的证明被查出踩了验证工具的漏洞,作废。这两件事挨得很近,指向同一个变化。
一、8月1日那份公告,写了什么
公告的名字叫《数学与理论计算机科学的十项进展》,刊发日期2026年8月1日。OpenAI说,这十项成果由下一代主力模型Astra的内部版本取得,Astra本身还没有对外发布。
来源:OpenAI官网《数学与理论计算机科学的十项进展》,2026年8月1日
十个问题横跨高维几何、编码理论、算术电路复杂性、群论、算子代数、量子复杂性、格密码学和极值组合学。挑几项分量重的说:高维球堆积密度的上界被压到科恩—埃尔基斯方法所能给出的极限,一般高维指数自1978年以来首次改进;二元码与球面码的最大规模上界,分别自1977年和1978年以来首次改进;构造出一个无法用有限置换近似的非索菲群,而索菲性这个概念是格罗莫夫1999年才提出来的;给出康涅刚性猜想的一个反例;在所有维度上证明了埃尔哈特体积猜想。
这些名字对绝大多数人没有意义,重要的是它们的共同点:每一道都被人类专家盯了十年以上没有进展。
OpenAI披露的流程是三步。Astra先生成数学论证,人把论证整理成论文稿,然后同一个模型把每项论证在Lean 4里形式化,输出一份证书。证书连同论文一起放上GitHub,仓库叫openai/ten-proofs,用Apache-2.0协议开源。

来源:OpenAI官网同页“研究成果”段,披露求解token总成本约2,000美元(2026年8月1日)
成本那句话写得很直白:按Sol API的费率,找到这些解法所需的token总成本约为2000美元。这个数字不含模型训练,只是把已经练好的模型拿来跑一遍推理的账。
二、“机器可验证”是这次的关键
Lean 4是一套定理证明辅助系统,可以把它想成一台只认规则不认人的验收机器。定理、前提、每一步推理,都要写成它能读的符号;它挨条核对类型对不对得上,通过就是通过,卡住就是卡住。谁提交的、说得多有道理、背后是哪家公司,它一概不看。
过去一篇数学论文要几位同行读上几个月才敢说没问题。Lean把这道工序变成编译一次代码。
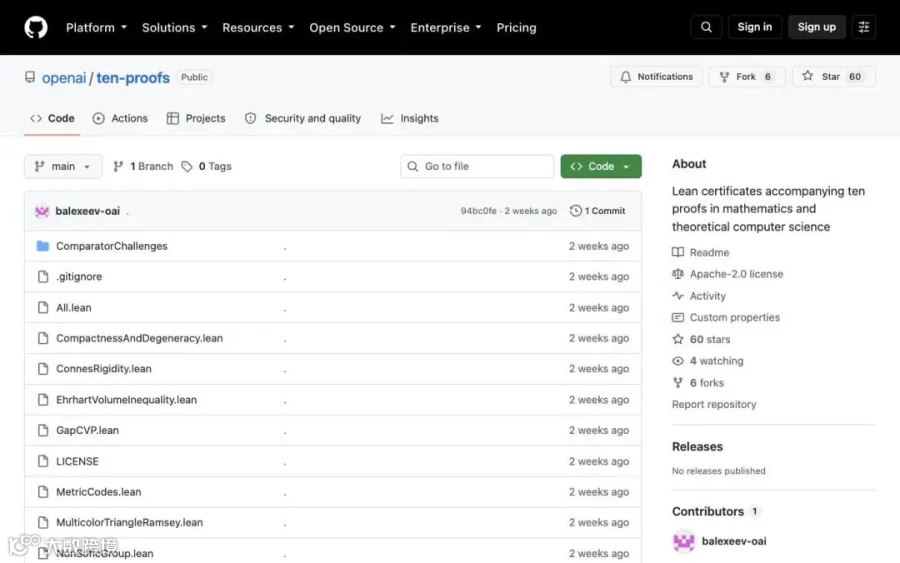
来源:GitHub仓库openai/ten-proofs,Apache-2.0协议,十项成果的Lean证书(2026年8月)
Lean里有个占位记号叫sorry,用来标记还没补完的步骤。这次仓库的sorry计数为0,说明十份证书里没有留白。
这一点比十道题本身更值得记住。AI给出的答案,第一次带上了不依赖信任的凭据。以前判断一个模型的输出对不对,靠人复核、靠交叉比对、靠经验。现在这一类问题上,凭据自己会说话。

三、三天之后,一份AI证明被判无效
7月25日,专攻形式验证的研究者Ramana Kumar在GitHub公开了一个项目,声称在AI辅助下反证了考拉兹猜想。考拉兹猜想的规则小学生都懂:任取一个正整数,偶数就除以2,奇数就乘3加1,反复操作,猜想说最后一定会掉到1。规则简单,八十多年没人证得出来,也没人找得到反例。
这个项目没有用sorry,也没有添加额外公理,外观上像一份正式证明,还通过了另一套用Rust独立写成的检查器Nanoda。
Kumar自己回头细查时发现了不对劲:跟考拉兹毫无关系,这套写法能让Lean接受命题False。前提为空却能证出假,逻辑上任何结论都能推出来,包括“考拉兹猜想成立”这个相反的结论。7月28日,研究者Kiran Gopinathan把它压缩成一份最小复现,报给了Lean团队。
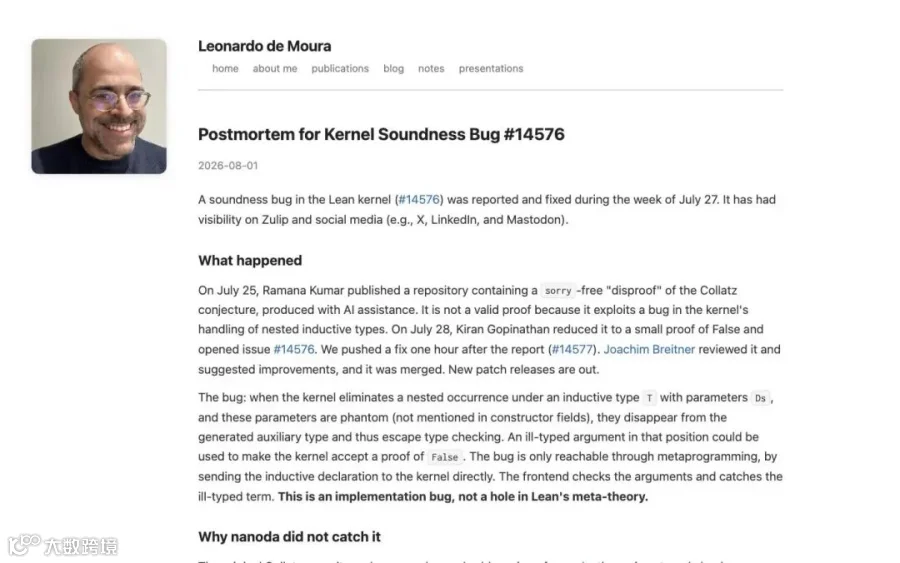
来源:Lean作者Leonardo de Moura个人博客《Postmortem for Kernel Soundness Bug #14576》,2026年8月1日
漏洞出在内核处理嵌套归纳类型的地方。构造子字段里不出现的幻影类型参数,会从生成的辅助类型中掉出去,从而躲开类型检查;在那个位置塞进一个类型不匹配的参数,内核就会收下一份关于False的证明。触发条件很苛刻:正常写法会被前端拦住,必须用元编程绕过前端、把炮制好的声明直接送进内核。
Lean的作者Leonardo de Moura在复盘里写得很清楚,这是内核实现上的一处检查遗漏,Lean的逻辑体系本身没有洞。团队在收到报告约一小时后提交了修复,含修复的4.32.2版本7月28日发布。
还有一层巧合。旧版Nanoda在投影节点上不校验类型名,也有缺陷。两套互不相干的实现同时存在缺陷,那份证明才被同时收下。Kumar认为是碰巧,也不排除模型学过Nanoda的旧缺陷报告;参与Lean开发的Joachim Breitner的看法是,高性能模型让这类复杂漏洞更容易被翻出来。事后Lean FRO补了回归测试、加严了内核内部的前置检查,OpenAI的Daniel Selsam用安全方向的AI协助排查,又找出几处实现错误,目前都已修复。
把这件事和8月1日那份公告并排看,能得到三条分场景的判断。
第一,验证器实现无误时,机器证书是目前最硬的凭据,比任何权威背书都硬。
第二,形式化写下来的命题,未必等于原问题实际要问的东西。证书再干净,也只保证“写下来的这句话被证明了”。这句话和原问题对不对得上,还得数学家逐条读。Astra这十项成果尚未经过同行评议,这道关还没走完。
第三,单一验证器不够。有人刻意绕过前端、直接向内核提交声明时,只有多套独立实现交叉复核才拦得住。这次两套同时失守,恰好说明“双保险”的必要,也说明双保险并非万无一失。
四、这条链上都有谁
把视线从一家公司挪开,形式化证明这条链已经站满了人。
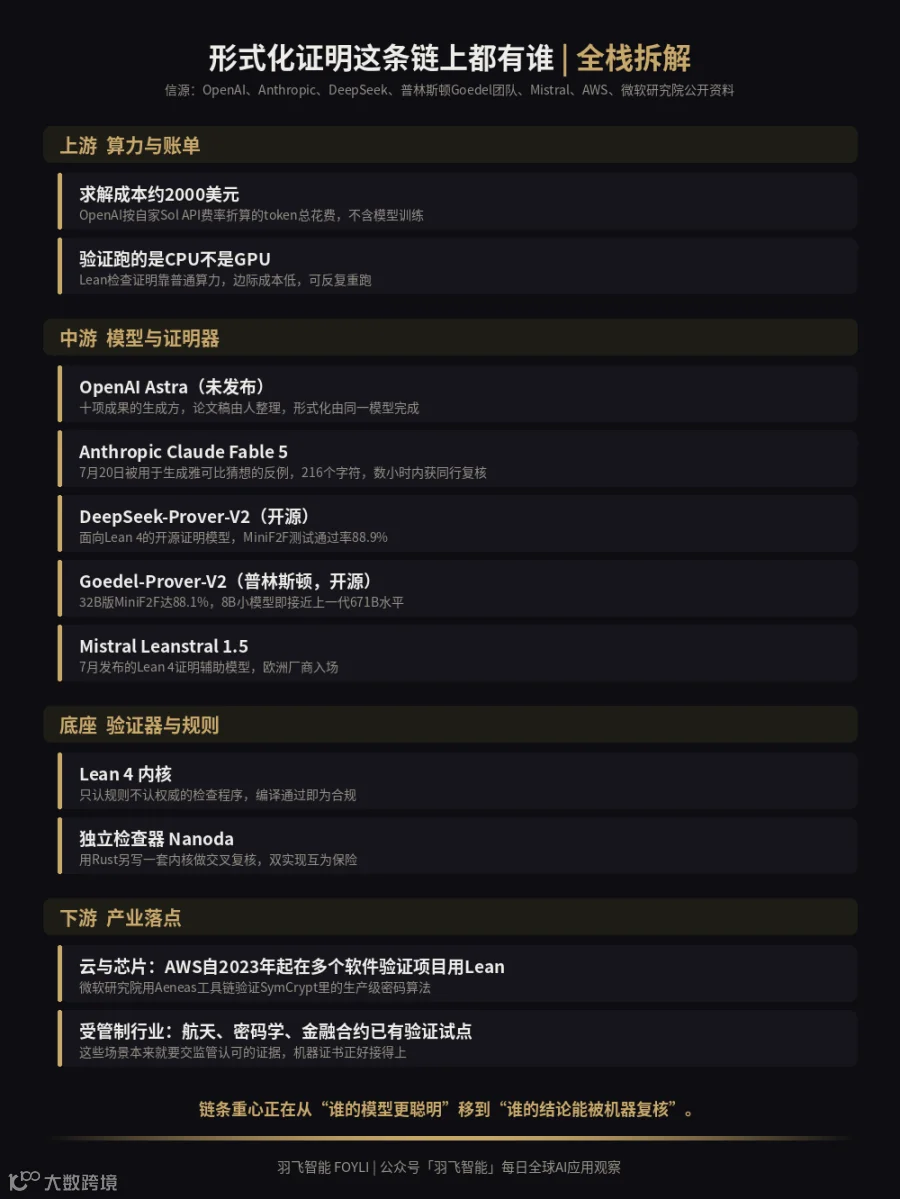
上游是算力和账单。2000美元是求解阶段的token账单,训练成本另算。验证这一头更便宜:Lean检查证明跑的是普通CPU,不吃显卡,边际成本低到可以反复重跑。卖推理算力的云厂商在这条链上直接受益,靠“结果对不对只能听我的”来卖服务的一方则被挤压。
中游是模型和证明器,玩家已经不止一家。7月20日,研究者Levent Alpöge用Anthropic的Claude Fable 5生成了雅可比猜想的一个反例:三个变量的多项式映射,雅可比行列式恒等于-2,却不是全局可逆,三个不同的输入落到同一个输出上。整个反例216个字符。公布之后数小时内,全球数学家独立验证通过,1939年提出的这个猜想在三维及以上被推翻,二维情形依然悬着。
开源这一侧跑得也不慢。DeepSeek-Prover-V2面向Lean 4,在MiniF2F测试集上通过率88.9%%;普林斯顿团队的Goedel-Prover-V2,32B版本在MiniF2F上达到88.1%%、自纠正模式90.4%%,8B的小版本83.3%%就已接近上一代671B模型的水平,体积却小了近百倍。Mistral在7月发布了Leanstral 1.5。闭源做前沿突破,开源做工程化下沉,两条腿都在跑。
来源:GitHub仓库deepseek-ai/DeepSeek-Prover-V2,面向Lean 4的开源证明模型
底座是验证器和规则,是Lean 4内核和Nanoda这类独立检查器。这一环没有惊人的估值,却是整条链的地基。地基松一寸,上面所有结论一起作废,7月底那件事就是现成的演示。
下游是产业落点。AWS自2023年起在多个软件验证项目里使用Lean;微软研究院用Aeneas工具链,把SymCrypt里的生产级密码算法做了形式化验证;已经有人搭出从Rust到Lean的流水线,把生产环境的密码学代码转成机器可查的正确性证明。航天、去中心化金融这些交付物本来就要向监管方交证据的行业,最先出现了生产试点。
中外厂商都在名单上:卖推理算力的云服务商、做开源证明模型的DeepSeek和普林斯顿团队、欧洲的Mistral、把形式化验证接进产品线的AWS与微软,以及那些交付物必须过监管的行业软件商。冲击落在另一侧:以“我们经验丰富”作为主要卖点的技术服务,凭据一旦可以随货附带,经验的溢价就要重新定价。
五、数学界并不是一片叫好
6月3日,一份叫《莱顿宣言》的文件发布,源自2025年9月莱顿大学洛伦兹中心的一场研讨,获得国际数学联盟背书。签名者里有菲尔兹奖得主陶哲轩,也有前荷兰教育大臣罗伯特·戴克赫拉夫。24小时内签名超过一千人。

来源:莱顿大学官网关于《莱顿宣言》的报道(2026年6月)
宣言列了五条风险:结果不可靠、引用缺失、依赖封闭的商业系统、宣称被夸大、科学独立性受损。
这五条都能在最近三个月里找到对应。考拉兹那件事对上第一条;十项成果尚未经过同行评议、形式化命题与原问题的对应关系还待确认,对上第四条;Astra本身没有公开发布,外界只能拿到证书和论文,无法自己复现整个过程,对上第三条。
提出这些意见的人并不反对工具本身。他们要求的是把话说清楚:哪些是机器验证过的,哪些是宣传口径,哪些依赖只有一家公司能提供的东西。

六、这套模式往产业里走,会长成什么样
剥掉数学的外壳,这三个月发生的事可以概括成一句话:结论和凭据一起交付。
凭据这个东西,在生意场上一直存在,只是形态粗糙。报价单后面附的成本明细是凭据,对账单后面附的流水是凭据,质检报告后面附的检测数据是凭据。它们的共同短板是靠人看,看得慢,看不全,看不懂的地方只能选择相信。
AI进来之后,这个矛盾被放大了。一台机器几秒钟出一份报价、一份排产方案、一份成本测算,人工复核的速度追不上生成的速度。把凭据也变成机器可读、机器可查的东西,是眼下能想到的解法。
几个具体落点。报价与成本核算:AI算出的价格,附上取数口径、单价来源和计算过程,另一套程序能原样重算一遍,对不上就报警。对账与开票:金额之间的勾稽关系写成可执行的校验规则,出账前机器先跑一遍。排产:产能和交期的结论带上约束条件清单,改一个参数就重跑,看结论是否还成立。投标文件:技术参数逐条标出处,评标方随手可查。巡检与质检:判定结果附带原始证据和判定阈值,复议时不用重新扯皮。代码交付:模块随附单元测试和形式化规约,验收方自己跑一遍。
前提也要说清楚,这套东西并非哪里都适用。
其一,只有规则能写死的环节才形式化得了。审美、谈判、人情往来,写不进验证器。
其二,形式化的命题必须和真实要求对得上。把关成本会从“审结果”挪到“审命题”,这道工序省不掉,只是换了位置。
其三,关键环节需要两套独立实现交叉复核。单一校验程序自己出错时,没人拦得住。
其四,主要成本是人的成本。需要既懂业务规则、又能把规则翻译成形式表达的人,这类人现在很稀缺。
其五,如果一件事的对错本来就没有客观标准,机器凭据没有用武之地,这类场景不必硬套。
2000美元解开十道悬置十年的难题,这个数字很扎眼。更扎眼的是OpenAI把249页论文和十份可以自己跑一遍的证书一起摆了出来,三天后又被一个内核漏洞提醒:验证工具自己也会出错。这两件事凑在一起,把整个行业的注意力从“模型有多聪明”带到了“结论怎么复核”。
AI越会算,验收这道工序就越值钱。
信源:OpenAI官网《数学与理论计算机科学的十项进展》(2026年8月1日);GitHub仓库openai/ten-proofs、deepseek-ai/DeepSeek-Prover-V2;Leonardo de Moura《Postmortem for Kernel Soundness Bug #14576》(2026年8月1日);GIGAZINE(2026年8月3日);Quartz(2026年8月3日);莱顿大学官网《莱顿宣言》报道(2026年6月);Goedel-Prover-V2项目公开资料。Astra十项成果尚未经过同行评议,文中数字均为各方公开披露口径。
