点击上方蓝字「羽飞智能」关注我们

8月11日,英伟达开源了一个300亿参数的模型,同一天还放出一个叫NeMo Switchyard的路由工具。官方内部基准给出的结论很直接:同样的活,成本降到只用旗舰模型的约三分之一。前一天,Meta开源了另一个300亿参数模型,一张24GB显存的显卡就能跑起来。
三天里,两家公司做了同一件事
先看英伟达。8月11日发布的Nemotron 3.5 Lightning是一个300亿参数的专家混合模型,每次推理只激活30亿参数。官方给出的数据是输出速度最高提升4倍,完成一项智能体任务的时间缩短约30%。它能在装了RTX显卡的电脑、工作站上运行,也能放进数据中心和云端。
来源:英伟达官方博客(2026年8月11日)
同时发布的NeMo Switchyard是一个开源的模型路由库。它做的事情用一句话讲清楚:一件任务分成很多步,每一步自动交给最合适、最便宜的那个模型去做,应用本身不用改写。英伟达在博客里写得很清楚,如果所有请求都默认丢给最贵的模型,钱会花冤枉;如果人工去分配,又变成一堆集成工作。

来源:英伟达官方博客,关于多模型分工的说明(2026年8月11日)
再看Meta。8月10日,Meta研究博客发布Muse Glimmer,300亿参数、Apache 2.0许可、权重公开。这个模型在全精度下需要55GB以上显存,压缩到约4bit后,语言模型部分降到20GB以内,24GB或32GB显存的单张消费级显卡就能装下,也能在M4、M5 Max芯片的Mac上运行。按Meta公布的测试,在一张RTX 5090上,生成速度从每秒74.9个token提升到233.4个。

来源:Meta研究博客《Introducing Muse Glimmer》(2026年8月10日)
两家公司的产品线不同,动作指向同一处:把完成一件事的成本压下来。这是今年AI竞争的重心转移,过去比谁更聪明,现在比谁办同样的事更省钱。
省下来的钱,第三方是这么测的
厂商自己的数字容易被打折扣,英伟达这次同时公布了合作方的测试结果,几组数据可以互相印证。
LangChain在145个多轮任务上测试路由:只把7%的调用交给最前沿的模型,其余分给便宜模型,总成本下降74%,准确率下降6%。金融科技公司Ramp在自家的代码基准上,用路由追平了旗舰模型的表现,成本降低58%,运行时间缩短33%。Cognition把路由接进Devin Desktop,平均成本比全部走单一前沿模型低28%。
这些数字口径不一,测的任务也不同,共同点是把活分级之后省下的钱大多在两成以上,多的接近四分之三。翻译成日常业务:客服回答常见问题、发票和送货单的信息提取、巡检记录归类、订单信息核对,这类量大又重复的环节交给小模型;报价方案、合同条款判断、复杂纠纷处理这类需要判断力的环节,才调用最贵的模型。
云端的单价也在往下走
7月30日,OpenAI下调GPT-5.6系列价格,其中速度最快的Luna降价80%,每百万输入token从1美元降到0.2美元,输出从6美元降到1.2美元;中端的Terra降价20%;最强的Sol价格不变。OpenAI给出的理由是内部效率提升,服务成本下降约20%。多家外媒的报道则提到另一层背景:企业客户开始要求AI支出算得清回报,便宜的开源权重模型也在拉低整体价格水平。
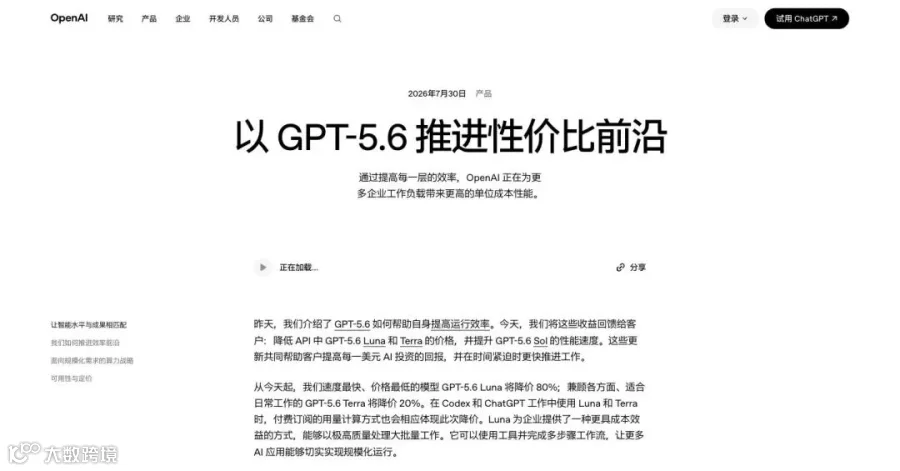
来源:OpenAI官网公告《以GPT-5.6推进性价比前沿》(2026年7月30日)
用量这一侧同样在变。在模型调用聚合平台OpenRouter的本周榜单上,DeepSeek的V4 Flash周调用量达到10万亿token,位居第一,环比上涨191%;紧随其后的几个位置也多是中国团队的模型。低价模型正在承接大量真实工作负载。
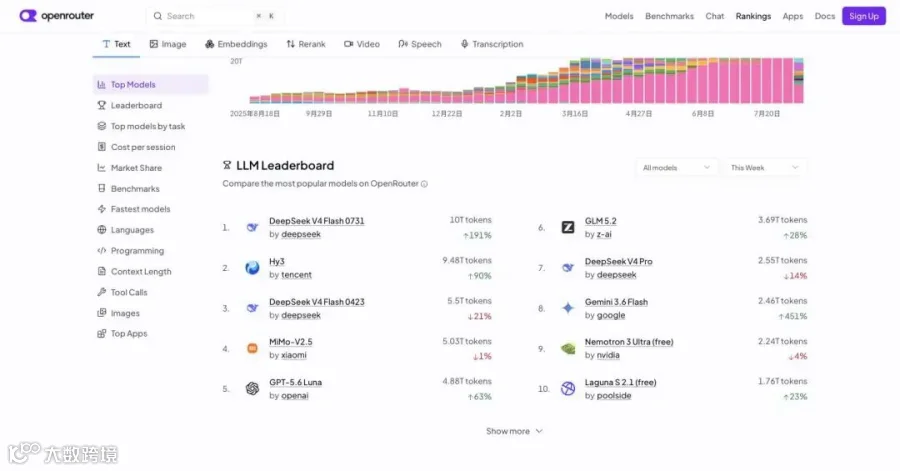
来源:OpenRouter模型排行榜(2026年8月12日查询)

便宜有边界:四个前提
第一,降的是单价和分工后的均价,账单取决于调用量。长时间在线的智能体一天要跑很多轮,单价降八成、调用量涨十倍,月底的账单反而更高。
第二,路由省钱以准确率小幅下降为代价。LangChain公布的数字是6%。开票、对账、报关这类不能出错的环节,省下的钱抵不上一次差错的代价,人工复核这一关不能省。
第三,本地部署有硬件和人的门槛。24GB显存的显卡不是普通办公电脑的配置,模型更新、权限管理、数据备份都需要有人负责。Meta在发布说明里也建议在模型外面另加一层系统级防护,不要把模型直接开成一个接口。
第四,低价不等于长期承诺。DeepSeek的官方定价页面在标注价格的同时写明,后续计划上调整体价格,建议用户据此规划用量。把成本模型建立在某一家的促销价上,风险显而易见。
落到生意上的三条
一、比价的单位换了。过去问的是用哪个模型,现在该问的是完成一单业务、处理一张单据的平均成本是多少。同一件事,不同的模型组合能差出几倍价钱,报价单上的模型名字说明不了成本。
二、高频重复环节先动。客服问答、单据识别、记录归类这类环节量大、标准清楚、错了容易发现,用便宜模型跑最划算,也最容易在一两个月内看到账面变化。
三、数据不出厂这条路今年变得现实。过去要么把数据传到云端,要么放弃用AI。现在300亿参数的模型能装进一台配好显卡的机器,客户名单、报价记录、图纸这些不方便外传的资料,可以留在本地处理。医疗、法务、金融、制造这些对数据落地有硬性要求的行业,选择多了一个。
这一周最值得记住的一句话,是路由工具的设计前提:不同的活,本来就该交给不同价位的模型。
信源:英伟达官方博客《NVIDIA Nemotron 3.5 Lightning and NeMo Switchyard Deliver Faster, Smarter, More Efficient Agentic AI》(2026年8月11日);Meta研究博客《Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device》(2026年8月10日);MarkTechPost关于Muse Glimmer的技术拆解(2026年8月10日);OpenAI官网公告《以GPT-5.6推进性价比前沿》(2026年7月30日);CNBC、Quartz关于OpenAI下调价格的报道(2026年7月30日至31日);OpenRouter模型排行榜(2026年8月12日查询);DeepSeek开放平台定价页(2026年8月12日查询)。文中数字均为各方公开披露口径。