


点击上方蓝字「羽飞智能」关注我们

AI洞察 · 第17期|2026年10月4日
几头大象同时发出低鸣,有的声音甚至低到人耳听不见。这样的录音,过去很难拆开分析。现在,研究人员试着把整段声音交给机器学习:只听这场“群聊”,能不能知道象群正在做什么?
10月1日,非营利研究机构Earth Species Project介绍了一项与ElephantVoices等机构合作的研究。模型能从重叠的象鸣中,辨别重聚、联络等行为场景,表现高于随机猜测。相关论文发表于《Scientific Reports》。
这离给大象配上中文字幕还有距离,却已经让一个常见的问题变得具体:AI究竟能从动物的声音里听出多少信息?从大象到抹香鲸,几项研究给出的答案,比一款“动物翻译器”更值得细看。
几头象同时开口,里面有线索
这里的“群聊”只是便于理解的比喻,指多头大象重叠发出的低鸣。它没有文字消息,也没有谁在发朋友圈。研究关注的是声音与真实行为之间的关系。
这项研究使用的录音来自肯尼亚安博塞利,跨越1986年至2022年。研究者分析了903次成年雌象的低鸣,并把声音与长期野外观察对应起来。哪些象在附近、当时正在做什么,这些背景让录音有了可供核对的线索。
研究中的六类场景,涵盖分散后的联络、发起集体移动、照顾幼崽以及不同形式的问候等。同样是低沉的象鸣,发生的场景并不相同。研究者尝试直接分析重叠的声音,而不必先把每头象的声音都分离出来。
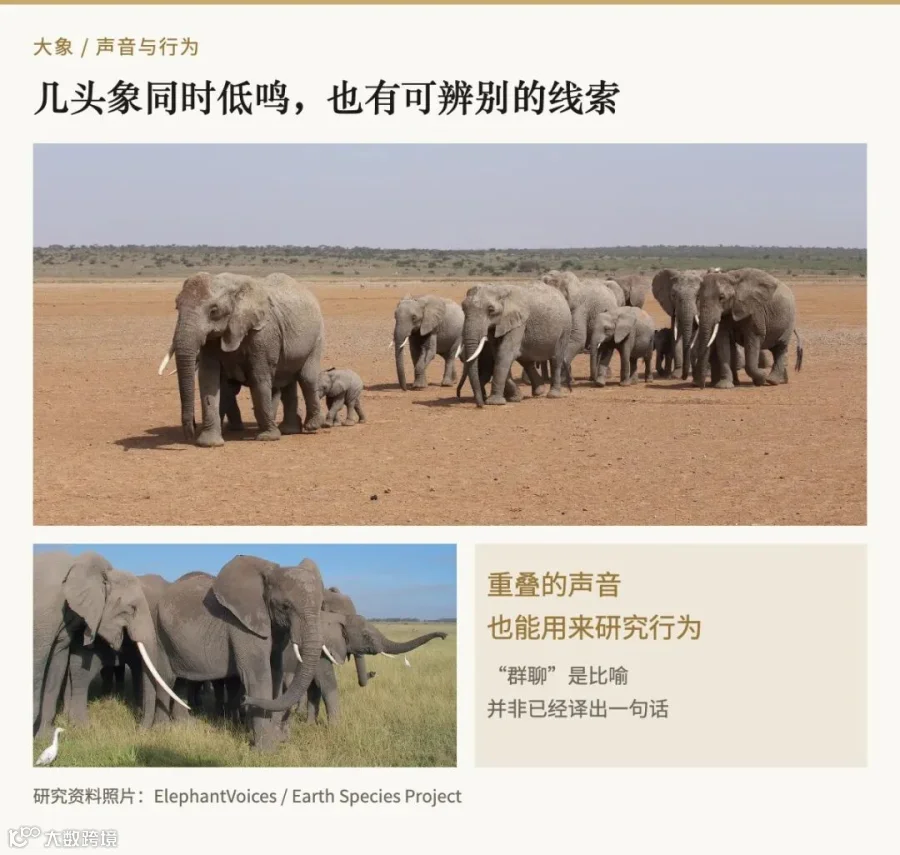
安博塞利象群资料照片。图片:ElephantVoices,经Earth Species Project研究介绍刊载。
这件事有趣的地方在于,叠在一起的声音也能提供信息。日常录音里常被当成干扰的重叠,在动物交流中可能恰好是值得研究的部分。几头象何时加入、怎样回应,与一声孤立的叫声是不同的问题。
团队还观察到,部分情境中的低鸣会随着互动推进,在声学特征上变得更相似。不过,这种趋同是否参与了行动协调,仍需进一步实验,不能直接写成“大象正在投票决定去哪儿”。
知道“正在问候”,还没得到一句翻译
假设有人在门外听一群人说一种陌生语言。他也许能通过语气和轮流说话的方式,判断屋内是在庆祝、争执还是商量事情;但要写下每个人说了什么,显然还缺很多信息。这个比喻可以帮助理解“识别场景”和“翻译内容”的区别。
同样,模型把一段象鸣分到“问候”这一类,输出的是研究者定义的行为标签。它没有给出一句经动物验证的中文,也没有证明大象的交流单位能与人类的词语逐一对应。
如果将“辨别问候场景”写成“AI翻译出大象说好久不见”,读起来很生动,却悄悄多添了一层证据里没有的内容。读者记住的往往是后面那句话,真实进展反而被掩盖了。
论文也检查了跨个体、跨家庭的表现。一些测试的准确率有所下降,虽然仍高于随机基线;分类器还会混淆某些场景。这样的结果提醒人们,“找到有效线索”与“已经判断得很准”之间,仍有很大空间。
被“叫到名字”的大象,真的会回应
动物交流研究并不只有计算机里的分类结果。一个更容易想象的例子,来自2024年的另一项大象研究。科罗拉多州立大学及合作团队用机器学习分析叫声,寻找与接收者身份有关的线索。
关键的一步是播放实验:当研究者播放原本叫给某头象的录音时,它会更积极地回应或接近扬声器;换成叫给其他象的录音,反应较弱。团队据此提出,大象会使用类似名字的叫声称呼彼此。
“类似名字”保留了必要的分寸。当时的研究并没有逐个提取出一套可以随意使用的“象名词典”,研究者也表示,仍需要更多数据去分离叫声中的名字成分。此处回看这项旧研究,是为了说明验证方法,并非把它当成这周的新发现。
它给人的启发很直观:电脑发现某种规律之后,还要回到动物那里,看这个规律是否与它们的反应有关。模型可以提出线索,动物的行为提供另一种检验。
鲸的“字母表”,也没有直接变成词典
海里也有类似的故事。MIT与Project CETI在2024年介绍的抹香鲸研究,发现短促点击声序列中存在复杂的组合结构。节奏、速度,以及细微的时长变化等,可以形成不同的声音模式。研究者将其称为一种“语音字母表”。
这个说法很容易让人联想到翻译软件,但该项研究揭示的是声音如何组合、怎样随交流情境变化。MIT当时的介绍也把理解这些交流的含义列为后续研究方向。能分辨声音的组成,与知道整段话的意思,仍是两层工作。

2024年抹香鲸研究资料照片。摄影:Amanda Cotton;来源:MIT News。
这有点像第一次发现一串看似随意的符号有重复的组合:符号之间出现了秩序,接下来才有条件追问它们的作用。这样的发现本身已经很迷人,无需提前替鲸写好台词。
而且,人类习惯用“字母”“名字”“聊天”来理解其他物种。比喻能帮人走近研究,也可能把人类语言的结构一并套过去。更稳妥的读法,是同时看清比喻背后究竟测量了什么。
回答更流畅,不代表更懂动物
9月30日,Earth Species Project还刊出了一篇研究者访谈,讨论一个颇有反差的现象:同样是让NatureLM-audio识别录音里的物种,换一种提问方式,模型的表现就可能明显变化。相关工作曾在2025年的学术研讨会上报告。
团队尝试把它与原来的语言模型进行合并,以改善指令遵循,同时保留处理动物声音的能力。这里提升的是研究工具回答问题、按要求给出结果的能力。它不能被理解成模型突然学会了更多“动物台词”。
这一点放在普通人的体验里也很好理解:一段回答写得顺、解释得像模像样,容易让人相信它已经弄懂声音背后的意思。可界面里的语言表达,与录音里究竟存在什么证据,需要分别判断。

编辑示意:不同研究问题所需要的证据不同。这不是产品功能表,也不表示所有动物研究都按同一路径推进。
辨认“谁在叫”,需要核对物种或个体;判断“在做什么”,需要声音与行为的对应;解释“表达了什么”,还要检验动物是否以相应方式理解和回应。把这几层分开,许多看起来矛盾的AI新闻就更容易读懂。
最先改变的,可能是人类怎么观察
即使没有即时翻译,声音研究也有实际价值。大象研究团队提出,未来若能从被动录音中推断行为场景,或许可以帮助了解栖息地与移动通道的使用情况。这里谈的是保护工作的潜在用途,还不能据此宣称系统已经能准确指挥野生象群。
从编辑观察看,这类技术值得关注的一点,是让观察变得更细。过去的一段录音,可能只留下“附近有象”的记录;研究继续推进后,人们有机会提出更具体、也更需要验证的问题:不同场景是否有稳定的声音线索,群体互动如何随着时间变化?
它也提醒我们,很多AI成果背后都有不显眼的长期工作。录音、现场记录、个体识别和实验设计,让机器找到的模式有机会与真实世界相连。没有这层联系,再漂亮的模型输出,也很难知道应该相信到什么程度。
给动物配一句人类台词很容易。耐心弄清它们自己的交流方式,要走更长的路。大象的低鸣、鲸的点击声里,已经出现了一些可检验的线索;那些还没有答案的部分,也正是这个话题最吸引人的地方。
资料:Earth Species Project(2026年10月1日、9月30日)、Scientific Reports相关论文;科罗拉多州立大学、MIT News(两项2024年研究回顾)。本文为公开研究解读,未进行动物实验或产品实测。
