点击上方蓝字「羽飞智能」关注我们
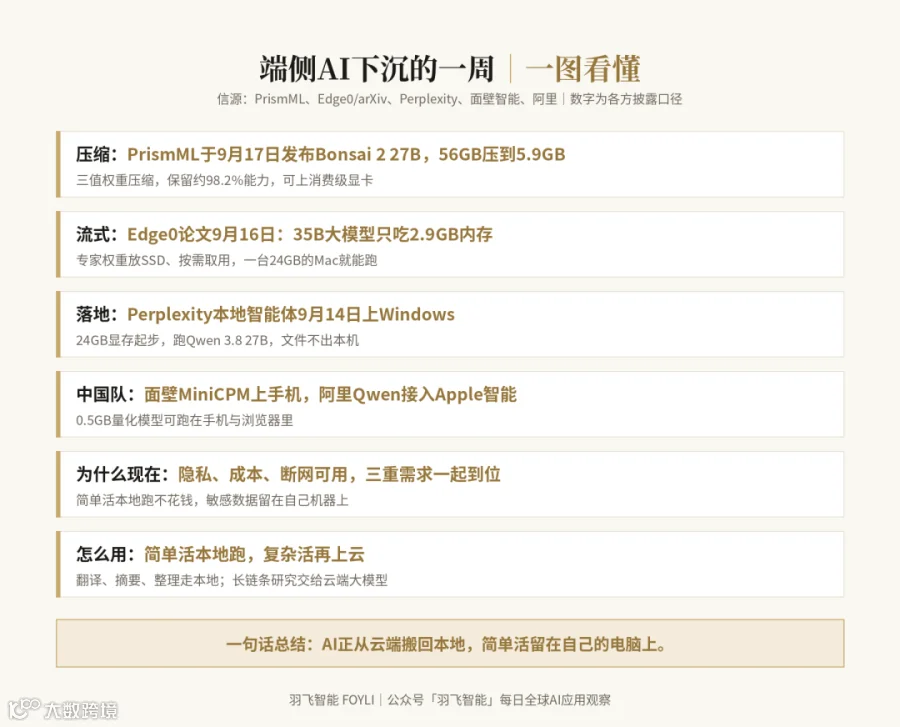
这一周,AI圈最实在的进展不在云端,而在一台台普通电脑里。9月14日,Perplexity把能自己干多步任务的智能体装进了本地Windows电脑;9月16日,一篇论文让35B的大模型只吃2.9GB内存就在Mac mini上跑起来;9月17日,PrismML把一个27B模型从56GB压到5.9GB。大模型正在从数据中心搬回本地。

PrismML把27B模型压到5.9GB:小到能塞进个人电脑
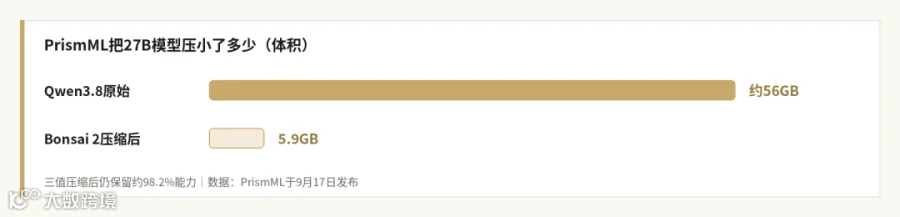
9月17日,一家叫PrismML的公司发布了Bonsai 2 27B。它拿阿里的Qwen3.8 27B做底子,把模型从原始约56GB压到5.9GB,还留住了大约98.2%的能力。压缩靠的是一种叫"三值"的办法——把模型里原本用16位小数表示的参数,简化成只用−1、0、+1三个值来存,占的空间一下小了一个量级。

跑起来也不挑硬件。官方说它能在一张英伟达RTX 5090显卡上不压缩直接跑,速度约每秒143个词;在苹果M5 Max芯片上约每秒46.8个词。模型以Apache 2.0协议免费开放下载。对普通电脑来说,结论很直接:以前只能连云端才能用的那种"聪明"模型,现在有机会直接装在自己的机器上。
这里要分清"压缩"和"缩水"。过去把模型改小,常用的是另一种叫量化的办法,压得狠了准确率、知识都会掉。三值压缩的巧妙处在于,它只动存储的位数、尽量不动模型学到的东西,所以体积小了一大截、能力还留得住。官方给的基准也印证了这点:在编程、知识推理、工具调用几类测试上,Bonsai 2和原版Qwen3.8的分差都在3分以内。它做的是把大模型"瘦身",而非"减配"。
Edge0论文:35B大模型只吃2.9GB内存,一台Mac就能跑
同一周还有一篇更"取巧"的论文。9月16日挂上arXiv的Edge0,换了个思路:不是把模型压小,而是把模型摊在硬盘上、用到哪块取哪块。它基于Qwen的一个混合专家(MoE)模型——这类模型内部分了256个"专家",每处理一个词只叫醒其中4个。Edge0就把全部专家的权重放在SSD硬盘里,每次只把当下要用的那几个读进内存。

这样一来,一台24GB内存的Mac mini M4 Pro,只用2.9GB活跃内存就能跑起这个35B模型,实测每秒生成15到18个词,够日常对话用。为了不让"从硬盘读权重"拖慢速度,它还加了个小部件提前预判下一步要叫哪几个专家、边算边取,这一招把生成速度又拉高了近六成。代价是能力比原版略降,五项基准平均差3.9分——换来的是一台家用电脑也能碰35B模型。框架同样按Apache 2.0开源,目前先支持苹果芯片,其他平台还在路上。
两条路子放一起看,方向其实一致:让内存不再是拦路虎。一个是把模型本身压小到能整个装进内存,一个是把大部分权重挪到硬盘、只在内存里留当下要用的那点。前者胜在通用、换硬件也能跑,后者胜在能碰更大的模型、但对硬盘速度有要求。对普通用户,不必纠结原理,记住一个变化就够:过去"内存不够、模型太大跑不动"这道坎,正在被两种不同的办法各自绕开。
Perplexity把智能体装进本地电脑:文件不出本机
如果说前两件事是"模型能跑在本地",Perplexity这一步是"活能在本地干完"。9月14日,它把自家的Portable Computer智能体上线到Windows电脑,能自己完成多步骤任务。它跑的是本地版的Qwen 3.8 27B,条件是要一张显存24GB起步的英伟达RTX或RTX PRO显卡。

关键在两点:本地跑的任务不消耗账户积分,而且文件始终留在自己电脑上、不发往云端。这正好戳中很多公司的顾虑——把客户名单、合同、报价单发给云端AI,总担心数据出门。除了Qwen,Perplexity还准备了自研的PPLX 27B,以及英伟达的Nemotron系列可选。
"能干多步任务"和"只会答一句"是两回事。多步智能体能把一件事拆成几步自己走完:比如读一批本地文件、挑出要的信息、再整理成一张表。这类活以前要么手工做、要么把文件传上云。放到本地跑,等于请了个不带资料出门的助手——它翻的都是自己电脑里的文件,做完的结果也只留在本地。对律所、财务、医疗这些数据敏感又流程重复的行当,这个组合的吸引力很实在。
中国队也在同一条路上:模型进手机、进国行设备
端侧这条路,中国厂商走得并不慢。清华系的面壁智能今年开源了MiniCPM系列端侧模型,其中1B参数的版本做INT4量化后权重只有0.5GB,能直接跑在手机和浏览器里;它还与三星达成合作,模型将搭载到数款旗舰机型上。阿里的通义千问则已确认作为AI能力接入苹果智能,覆盖国行的iPhone、iPad和Mac。把模型做小、塞进手边设备,海内外是同一个方向。
端侧这件事,对国内公司还多一层现实意味。一是数据合规——很多行业要求客户数据、经营数据不出本地,端侧模型天然贴合这条线。二是算力自主——在国产芯片和消费级设备上把AI跑起来,少受进口高端算力波动的影响。把一个够用的小模型装进自己的服务器或电脑,既满足了合规,也把主动权攥在手里。这也是为什么手机厂商、办公软件都在往设备里塞AI。
为什么是现在:隐私、成本、离线,三件事一起凑齐
端侧AI不是新词,为什么这半年突然密集落地。把驱动力拆开看,是三个需求同时到了位。

第一是隐私。数据留在自己机器上,不必发给第三方,这对处理客户信息、合同、财务的公司格外要紧。第二是成本。本地跑不按次数收费,一台电脑买回来能用到底,高频的简单任务尤其划算。第三是离线可用。断网、弱网也能工作,工厂车间、门店、外勤这些网络不稳的场景,本地模型反而更靠得住。再叠加这一周看到的模型压缩和芯片进步,端侧从过去的"跑不动",变成了现在的"跑得动、还够用"。
硬件这条线的变化容易被忽略,但很关键。这两年新出的电脑和手机芯片,大多专门加了跑AI的单元,苹果的M系列、带独立显卡的PC、装了NPU的国产芯片都是如此。以前一台家用机连中等模型都吃力,如今主流配置跑个十几二十B的模型已经不勉强。硬件把地基垫高了,模型又在压缩上把楼层降低,两头一凑,端侧才真正从实验室走到了办公桌。
对做生意的人意味着什么:简单活留本地,复杂活再上云
端侧不是要取代云端,而是多了一个更便宜、更私密的选择。真正实用的用法是分工:把简单、高频、又碰敏感数据的活放本地,把复杂、长链条、要最强能力的活交给云端。
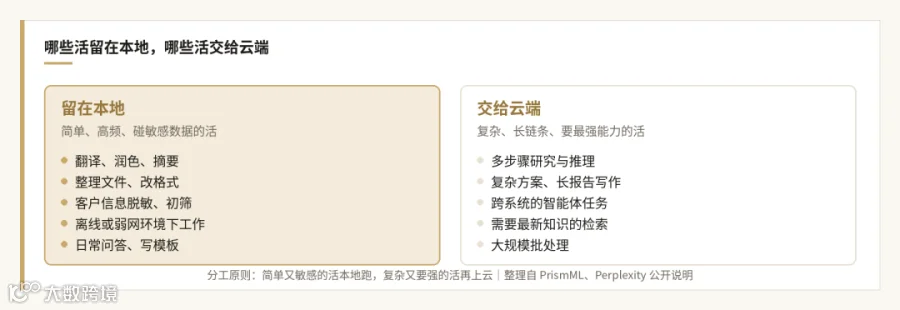
具体来说,翻译、润色、摘要、整理文件、给客户信息做脱敏初筛这类活,本地模型完全够用,还不花钱、数据不出门。真正需要多步骤研究、写复杂长报告、跨系统跑智能体、或要最新知识检索的活,再调用云端的强模型。对中小公司,一个可落地的起步动作是:先挑一两个每天都在重复、又不涉及最难判断的任务,在一台配置够的电脑上装个开源端侧模型试跑;跑顺了,再决定哪些扩大、哪些上云。前面提到的Bonsai 2、Edge0都按Apache 2.0免费开放,Perplexity的本地版对订阅用户开放,门槛比想象中低。
举个门店的例子:每天要把顾客咨询整理成回访清单、把进货单录进系统、给促销文案润色几版。这些活重复、量大、还带着顾客手机号这类敏感信息,正适合本地模型处理——一台带独立显卡的电脑就能跑,数据不出店,也不按次付费。真到了要做季度经营分析、写一份给总部的完整方案时,再把整理好的、脱去敏感信息的数据交给云端强模型。本地当"前处理",云端当"深加工",各用其长。
要提醒的是,端侧模型能力仍比顶尖云端模型有差距,Edge0这类预览版在多步骤、工具调用上还偏弱,官方自己也标注了。所以别指望一台电脑包打天下,把它当成"处理日常和敏感数据的第一道工序"更合适。选型时看三件事就够:模型体积能不能装进现有电脑、跑起来的速度够不够日常用、开源协议允不允许商用。
这股风谁受益、谁承压
端侧下沉,产业链上下游冷暖不一。最直接受益的是终端和芯片:能跑AI的手机、笔记本、带大显存的显卡有了新卖点,苹果、英伟达和一众国产芯片都想抓这波换机需求。做模型压缩、端侧推理框架、把开源模型调教好交付给企业的团队,也会多出一块活。对做应用的公司来说,好处是把一部分算力成本从"每月按量付费"变成"一次性买台机器",长期账更划算,数据也更可控。
承压的一头则是纯靠卖云端调用量赚钱的生意。简单、高频的任务一旦沉到本地,云端能收到的调用自然少一块。这也是为什么云厂商并不排斥端侧,反而主动推——把简单活让给本地、自己专攻难而贵的复杂任务,是更稳的卡位。对读者而言不必选边站,看清这层分工,采购时才知道哪些能力值得买断在本地、哪些按需上云更省。
把这一周连起来看:压缩让模型变小,流式加载让内存不再是墙,本地智能体让活能就地干完,海内外厂商一起把AI往设备里塞。云端依然负责最难的活,但越来越多的日常任务,正在回到一台普通电脑、甚至一部手机上完成。对想省钱、又在意数据安全的公司,这是个可以现在就动手试的方向。
信源:PrismML官网及新闻稿、SiliconANGLE(2026年9月18日);Edge0论文 arXiv:2609.18063(9月16日)、Hugging Face模型卡;Perplexity产品公告、Tom's Hardware(9月14日);面壁智能公开信息、新浪科技(2026年);阿里通义千问接入苹果智能公开信息。关键数字均为各方披露口径,核实日期见括注;端侧模型能力与速度因硬件而异,以官方页面为准。