搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
Meta偷偷上线了个"贴吧",还是想再造一个Reddit?
>
Meta偷偷上线了个"贴吧",还是想再造一个Reddit?
Beecommercer
2026-05-26
2
导读:硅谷的产品发布,从来都不是表面看上去那么简单。一家市值几万亿的巨头,突然推出一个新APP,绝对不是因为产品经理灵感来了想玩玩社区。
硅谷的产品发布,从来都不是表面看上去那么简单。
一家市值几万亿的巨头,突然推出一个新APP,绝对不是因为产品经理灵感来了想玩玩社区。这种动作背后,一定是在解决一个要命的、绕不开的工程难题。
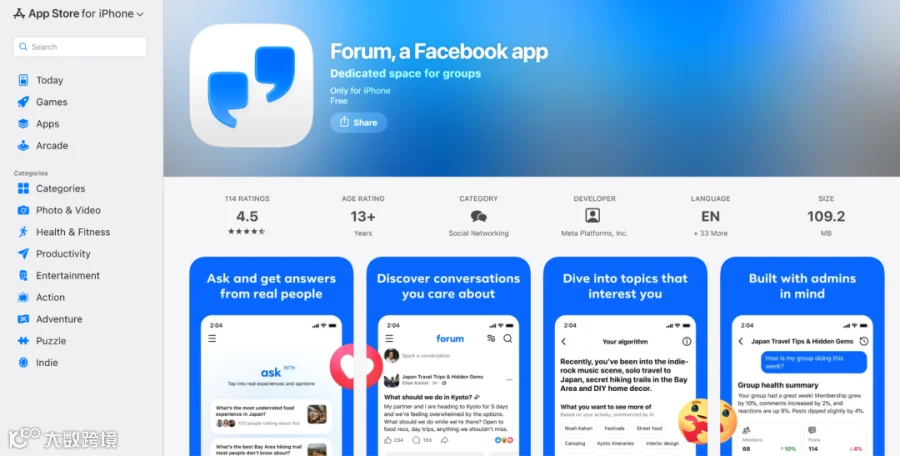
这周,Meta悄悄上线了一个新APP,叫"Forum"(论坛)。
打开一看,特熟悉——社区讨论板块、"提问"按钮、点赞顶帖的机制……
Reddit
、
Quora
、知乎、贴吧的影子都在里面。Meta的公关说得很漂亮:这是个让大家找到兴趣社群、分享真实经历的"数字广场"。
但凡你了解一点2026年AI圈的现状,就能一眼看穿这事儿——
Meta根本不是想做社交,它是在解决一个让所有AI公司睡不着觉的死结:互联网上的高
质量
数据,快被薅光了。
一、那堵越来越近的"数据墙"
要理解Meta为啥这时候做个论坛,得先明白现在的大模型有多"饿"。
ChatGPT
能写诗、Gemini能debug代码、Llama能装出共情的样子——这些"AI奇迹",全是堆数据堆出来的。
模型靠什么训练?把整个公开互联网扒下来——维基
百科
的所有词条、所有数字化的公版书、几十年的博客、社交媒体的存档……几十亿GB的文字,全往里塞。
但问题来了:互联网是有限的。
这三年,数据科学家一直在拉警报,业内叫"Data Wall"(数据墙):模型的参数还在指数级膨胀,但是高质量人类写的文本,已经基本被薅干净了。
更要命的是,互联网开始反抗了。2023、2024年那波
版权
大战之后,纽约时报、各大新闻集团、
独立站
长,全都把门关上了——上robots.txt屏蔽、起诉AI公司未授权抓取。
那条曾经免费奔流的数据河,被一段段截断了。
二、为啥不让AI自己生成数据?因为会"中毒"
肯定有人想:扒不到数据没关系啊,让现有的AI自己生一波,再拿来训新模型不就行了?
这条路是绝路。
这里有个挺玄学但又特别真实的现象,叫"模型坍塌"(Model Collapse)。
简单说就是:你拿AI生成的内容去训AI,几代之后,模型会把那些细微的幻觉、偏见、统计上的小毛病不断放大。
就像复印件再复印、复印件再复印——画质越来越糊,最后糊到不能看。
训练几代之后,AI会开始说一些重复、诡异、不知所云的胡话。它对人类语言的微妙之处,彻底失去了感觉。
要避免模型坍塌,唯一的解法是:喂它干净的、真实的、人类写的东西。
2026年这个
时间
点,真实的人类对话,是地球上最稀缺的资源之一。
三、为什么"提问+点赞"的设计这么贼?
不是所有人类数据都一样值钱。
让AI变成一个能跟你聊天的助手,靠看食谱博客是没用的。它得学人类是怎么对话的。
这里有个关键技术,叫RLHF(基于人类反馈的强化学习)。
听起来挺玄,拆开看特别简单:
要训出一个能准确回答问题的AI,你得给它看大量"人类问问题—人类答问题"的例子。但机器怎么知道哪个答案是好的?
靠人投票。比如上图Reddit帖子用户的点赞留言等互动的数据。
现在你回头看Meta这个Forum App的设计——
●用户A问了个怎么修水管的复杂问题 → 这就是训练用的Prompt
●用户B、C、D写了详细回答 → 这就是候选答案
●大家给C的回答顶到最上面 → 这就是人类的偏好标注
看明白了吗?
Meta这哪是做社区,这是在搞一个全民参与、不要工钱的"数据标注厂"。
用户们一边乐呵呵地"互助答疑",一边把训练AI最需要的那种"问题+答案+优劣排序"数据,全套打包、免费交付给Meta。
属于是把"白嫖"玩到艺术境界了。
四、Reddit的前车之鉴,Meta的"数据独立宣言"
肯定有人问:既然带点赞的问答数据这么值钱,Meta为啥不直接扒Reddit?
人家Reddit攒了二十年的数据,不正是Meta要的吗?
——因为Reddit想明白自己手里的牌值多少钱了。
2024年初,Reddit把API一锁,开始向各大AI公司收过路费。
Google
为了拿Reddit的数据训Gemini,据传一年砸了6000万美元。
OpenAI
也签了类似的天价合同。
扎克伯格哪能咽下这口气。每年掏几亿美元,给一个第三方平台买训练数据——这不是合作,这是命脉攥在别人手里。
Reddit哪天涨价、哪天不卖了、哪天为了讨好对手把Meta踢出去……Meta整条AI产线就得停摆。
Forum App的发布,就是Meta的"数据独立宣言"。
把用户圈在自己的生态里,从此训练数据自产自销、不用授权、不用花钱、不受制于人。
五、对品牌方意味着什么?一个更可怕的事
这事儿要是只停在硅谷工程师的层面,跟我们也没多大关系。
但它真正可怕的地方是——它正在重写"被看见"的规则。
这一年大家都看到了:越来越多人不去Google搜东西了,直接问AI。
买什么软件、修什么家电、选什么CRM、推荐个旅行目的地……以前是滑Google的十条蓝链,现在是看AI直接给一个答案。
那么问题来了——
Meta用Forum里养出来的数据,训出一个超强的AI助手,部署到
WhatsApp
、
Instagram
私信、
Facebook
上之后,会发生什么?
这个AI推荐什么品牌、什么产品、什么解决方案,完全取决于Forum里被点赞顶上去的是什么。
你的品牌如果没在Meta这个"数据池子"里活跃、没有被高赞讨论过——
在Meta AI的"认知"里,你根本不存在。
用户问:"小团队用哪个CRM最好?"
AI不会去网上现搜,它会根据自己训练时看过的Forum共识,给一个答案。那个答案里,有没有你的名字,取决于你有没有在那里"待过"。
六、写在最后:我们都是免费的算力
开放、可抓取的互联网时代,正在落幕。
我们进入的是一个数据围墙花园的时代——巨头们建起一个个封闭的园子,专门用来"养"人类的真实互动。
Meta的Forum App,是一次教科书级的操作:
●解决了数据墙的存亡危机
●绕开了第三方数据授权的天价开支
●拿到了一条持续不断、被数学验证过的人类反馈流水线
而我们这些用户,要清醒地认识到一件事:
你的每一次提问、每一次回答、每一个点赞,都不再只是社交动作。它们是这个时代最赚钱的技术的原材料。
我们不是Forum的用户,我们是它的算力。
对品牌和营销人来说,结论也很扎心:
未来的
SEO
不在你自己的官网上,它在这些论坛里。
你得潜进这些"数据水库",留下真正有价值的内容,让你的品牌成为那个被反复点赞的答案。
算法在看、在学、在合成。
给它点像样的东西读,是这个时代品牌唯一能做的事。
【声明】内容源于网络
0
0
Beecommercer
1234
内容
56
粉丝
0
关注
在线咨询
Beecommercer
1234
总阅读
0
粉丝
0
内容
56



 Beecommercer