导读近期,Forbes 技术委员会发表了一篇署名文章《Entering The Ontology Era: The Blueprint For Enterprise AI Agents》。作者 Tarek Nseir 是欧洲 AI 价值交付公司 Valliance 的联合创始人。这篇文章在海外引发了一轮转发和讨论,因为它说了一句很多厂商想说又不敢说透的话。这篇文章做三件事:把那篇文章的结论和论证讲清楚——本体是企业级 Agent 落地的唯一路径,海外已经确认;再看中国是不是也遇到了同一个问题;最后告诉你,10 月的北京,这场问题将第一次拿到成体系的中国答案。
出品社区|DataFun
这篇文章的结论,和它是怎么证明的
在讲结论之前,先回答一个应该被问的问题:凭什么信这篇文章? 毕竟观点满地都是,谁都能说一句“本体很重要”。
看平台。 它发表在 Forbes 技术委员会(Forbes Technology Council)——福布斯旗下只对受邀开放、经审核准入的高管社区,是世界级 CIO、CTO 和技术高管发表产业判断的正式阵地。这不是自媒体博文,也不是哪个厂商的白皮书,而是全球头部商业媒体平台上、以真实姓名和职务背书的署名判断。
看作者。 Tarek Nseir 不是评论员,是在这个行当里干了 25 年的交付者。他是连续创业者,曾创办欧洲头部数字转型咨询公司(后被美股上市公司 EPAM 收购),长期在董事会与高管层身边做转型,担任过英国数字行业组织 BIMA 的联合主席;现在是伦敦 AI 交付公司 Valliance 的联合创始人兼 Senior Value Partner——他的职业就是替欧洲企业把 AI 做出可衡量的价值,公司按效果收费。这样的人劝企业“别急着买 Agent,先把本体建起来”——Valliance 不卖 Agent 平台,这句话不是在卖货,是一线交付者对自己客户发出的逆耳忠告,含金量与厂商营销文恰好相反。
看论证过程。 文章的论据没有一个来自他自己的产品,全部来自行业级事实:Palantir 十年的产品路线、Databricks 的官方发布、微软 CEO 纳德拉的亲自撰文、Glean 的公开商业数据。这是一位一线交付者对“整个行业正在收敛”的综述判断,而非孤立的个人观点。文章发表后,它在海外企业 AI 从业者与咨询行业圈子里被持续转发引用——被引用最多的,恰恰是最后那句结论。
所以,当我们说“海外已经确认”时,指的是这样一件事:头部媒体的平台上,一线交付者综述了头部公司的行动,收敛出同一个结论。
回到文章本身。
结论只有一句:本体论(Ontology)是企业 AI Agent 的蓝图,而且是唯一的答案。
它不是靠喊口号证明的,论证链压缩下来是三步:
第一步,机理:你的 Agent 不懂你的企业。 Agent 只能推理它“理解”的信息、流程和业务逻辑——而企业的知识碎片化地躺在 CRM、ERP、OA 和几十万份文档里,从来没被拼成一个整体。所以模型再强,价值也被封顶:模型智力是上限,Agent 对企业的理解才是瓶颈。文章把多数企业的通病叫“试点炎”(pilotitis):先买 Agent、先跑试点,把上下文当“以后再补”的东西——顺序做反了,试点必然停摆。
第二步,历史:这个答案十年前就有人押中了。 Palantir 在所有人讨论 AI 之前的核心判断就是:只有先把分散的数据、流程和业务规则整合成一个连贯的模型,决策才会变好,其他一切(包括人类判断)都叠加在这个模型之上。这不是 AI 时代的新发明,是被验证过的老答案。
第三步,收敛:今天的海外正在殊途同归。 Databricks 发布了 Genie Ontology;微软 CEO 纳德拉亲自撰文提出“闭环”——竞争优势不取决于能否获得前沿模型,而取决于知识、工作流、决策能否作为单一系统协同运转;企业搜索公司 Glean 靠“Context Graph”做到了 72 亿美金估值、3 亿美金以上的年经常性收入;模型厂商则在拼命强化记忆与编排。这些公司彼此没有商量过,却在同一时间走向同一个答案:让 AI 理解企业。
三步走完,文章收尾斩钉截铁:赢家不会是拥有最好模型的那一个,而是能让信息、决策和行动协同流动的那一个——“而本体论,是唯一的答案。”
Palantir 是数据起家,Databricks 是数据平台,微软是操作系统,Glean 是创业公司——当这些彼此不商量的玩家收敛到同一个结论时,这件事就不叫趋势判断了,叫确认。
那中国呢?
先说现状:观望。 和海外两年前的心态几乎一模一样,理由无非三种——
-
看不懂:本体论听起来像哲学课,和“这个季度要交付的 Agent 项目”有什么关系? -
怕投入:去年追 RAG,今年追 MCP,本体是不是又一个要追的概念? -
没案例:海外的故事再漂亮,中国企业怎么做成的?
但如果你往产业深处看,会发现一件更有意思的事:中国不是在跟随一个海外概念,而是在不同行业里独立撞到了同一堵墙。
医疗是最早撞墙的行业。在“每一次输出都必须确定性地正确”的场景里,概率性的 RAG 和通用模型彻底失效——走通了的团队发现,要重构的不是模型,而是从模型、到知识、到工程、到交付的整个栈,知识必须被结构化成可查证、可追溯的体系。
工业是撞得最硬的行业。工厂里物理规律不可违背、工艺机理不容概率、容错空间趋近于零——概率模型在这里天然不合格,必须靠本体把工业数据、机理模型和业务语义结构化,AI 的输出才可审计、可执行。
平台和基础设施层也在动。搜索、推荐、数据平台圈在讨论同一件事:Agent 需要的不只是“数据在哪里”,而是“数据意味着什么、业务实体如何关联、行动受什么规则约束”——开放语义、本体、元数据正在被并列为 Agent 上下文的三重支柱。甚至已经有人开始逐条比较 Palantir、Snowflake、Databricks 等几种本体技术路线在中国的适配性。
同一个瓶颈,不同的行业,各自撞墙,各自得出同一个方向——这和海外发生的收敛,是同一件事。 中国的区别在于:口径更乱、系统更碎、组织更大,语义债更重;但反过来,一旦建成,抄不走、买不到的护城河也更深。
墙已经撞上了,缺的是一次把“撞墙经验”摊开的场合。
所以,我们把北京站主论坛排成了一场“本体论的中国证词”
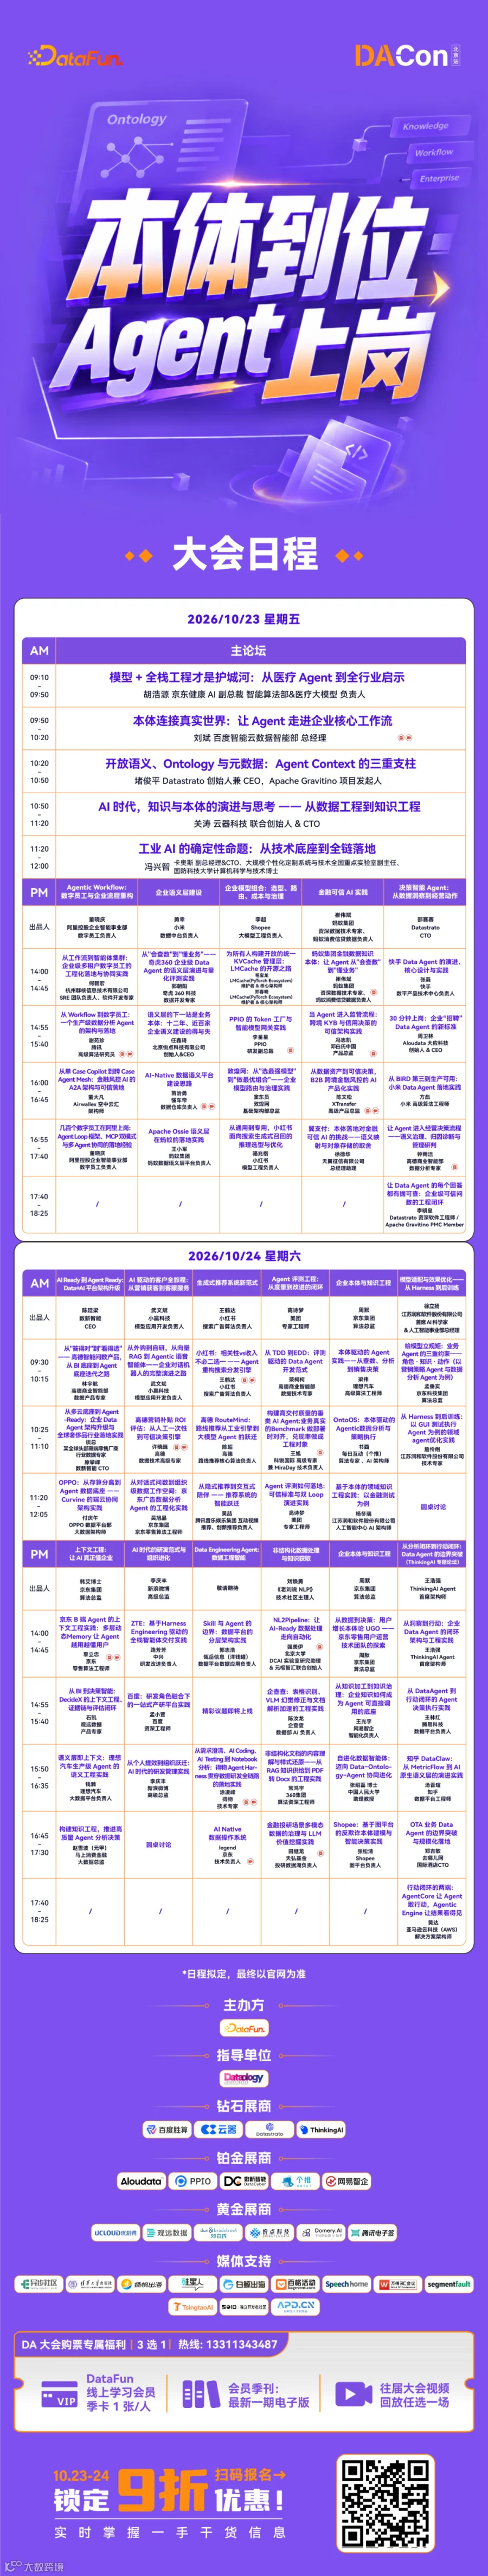
这正是 DACon 2026 北京站(10 月 23-24 日)主论坛的策划逻辑。五场主题演讲,就是五个行业对同一道题的作答,叙事上一环扣一环:
第一棒,回答“为什么必须”。 京东健康 AI 副总裁胡浩源(《模型+全栈工程才是护城河:从医疗 Agent 到全行业启示》)——从最不容出错的医疗场景出发,证明光有模型不够:要重构“模型→知识→工程→交付”的完整工程栈,把知识做成结构化、可查证的体系。这一棒立住整个论坛的命题:确定性场景里,散装知识等于没有知识。
第二棒,回答“本体是什么、怎么落地”。 百度数据智能部总经理刘斌(《本体连接真实世界:让 Agent 走进企业核心工作流》)——业务本体把对象、关系、逻辑与行动统一组织,让 Agent 在权限、血缘、版本和流程约束下“能分析、能判断、能协同”。这一棒给出中国平台级的产品化答案。
第三棒,回答“地基怎么搭”。 Apache Gravitino 发起人、Datastrato 创始人堵俊平(《开放语义、Ontology 与元数据:Agent Context 的三重支柱》)——从数据基础设施视角,讲清 Agent 可信上下文的三大支柱怎么建设。
第四棒,回答“路线怎么选”。 云器科技联合创始人 & CTO 关涛(《AI 时代,知识与本体的演进与思考——从数据工程到知识工程》)——把 Palantir、Snowflake、Databricks 等多种本体路线摊开比较:真正的差异不是“有没有图”,而是知识如何表示、运行、生产和验证,给出企业从数据工程走向知识工程的路径。
第五棒,回答“最难啃的行业怎么办”。 卡奥斯副总经理、大规模个性化定制系统与技术全国重点实验室副主任冯兴智(《工业 AI 的确定性命题:从技术底座到全链落地》)——工业为什么必然走向本体路径,以及工业世界模型怎么建。
五个人、五个行业、五种视角,但你会发现他们在回答同一道题——这本身,就是中国版“收敛”的现场证据。

全日程里的“本体专题”:中国的案例,已经排好了队
主论坛是判断现场,但真正让人确信“中国已经在做”的,是分论坛的案例密度。我们把北京站全部议程逐场过了一遍,把与本体重接相关的演讲提炼成一份本体专题导览——两天里你能听到的中国本体实践,横跨医疗、工业、金融、电商、汽车、出行、内容社区、通信、学术等近十个领域:
◆ 本体工程的一线实践(本体与企业知识工程论坛为主)
-
理想汽车《本体驱动的 Agent 实践——从查数、分析到销售决策》:用本体组织企业数据,让对象、关系、指标和业务规则成为 Agent 可理解的语义结构——从后训练接近 100% 准确率但难维护,转向本体驱动 -
悦点科技《语义层之上:让企业隐性经验成为 AI 可执行的资产》:十二年、近百家企业本体落地的实践与教训,含成功与失败的双面复盘 -
蚂蚁集团《金融数据知识本体:让 Agent 从“会查数”到“懂业务”》:用数据知识本体打通多源业务语义——异动归因准确率超 85%,交叉机会识别缩至小时级 -
Shopee《基于图平台的反欺诈本体建模与智能决策实践》:账号、设备、交易多实体的本体化建模,对抗团伙欺诈 -
天翼支付《本体落地的分叉路口:语义映射与对象存储的取舍与实践》:本体是“翻译层”还是“数据层”?一个几乎不可逆的关键选型,含返工代价的真实复盘 -
中国人民大学《自进化数据智能体:迈向 Data–Ontology–Agent 协同进化》:把 Ontology 作为可执行语义中间层的学术前沿框架 -
润和软件《基于本体的领域知识工程实践:以金融测试为例》、网易智企《从知识加工到知识治理》、每日互动(OntoOS 业务语义本体操作系统)、马上金融(知识工程驱动分析决策)——金融测试、企业知识治理、运营分析等场景的本体变体
◆ 语义层:本体的口径地基(企业语义层建设论坛为主)
-
蚂蚁集团《Apache Ossie 语义层在蚂蚁的落地实践》:已沉淀 100+ 语义模型、5000+ 指标,单一语义事实来源 -
知乎《DataClaw:从 MetricFlow 到 AI 原生语义层的演进实践》:AI 原生轻量语义层+知识图谱,团队渗透率超 65% -
奇虎 360《从“会查数”到“懂业务”——Data Agent 的语义层演进与量化评测》:真实数仓里学术 85% 的准确率如何断崖下跌、“半成品冷启动,边跑边长”的路径 -
Datastrato(Apache Gravitino)《让 Data Agent 的每个回答都有据可查》:数千指标规模的可信问数工程闭环 -
懂车帝《AI-Native 数据语义平台建设思路》:明确“基于本体论的数据语义”平台化建设 -
高德、小米、腾讯、易车、观远:语义层建模与评测、语义治理与归因诊断(沉淀 6.6 万条可追溯知识、分析效率提升 64 倍)、把 BI 语义层变成 AI 进化燃料、数据语义库+知识自进化、语义层与本体层的三层底座——语义层已经在中国头部企业里批量进入生产
◆ 上下文工程:本体建好之后,怎么喂给 Agent(上下文工程论坛为主)
-
理想汽车《语义层即上下文:生产级 Agent 的语义工程实践》:把散落在 Prompt 与工具中的知识拆分为本体、OSI、Playbook 和通用执行层,形成有证据的根因判断 -
京东《B 端 Agent 的上下文工程实践》:多层动态 Memory 让 Agent 越用越懂用户 -
京东健康(主论坛)《模型+全栈工程才是护城河》:取消概率性 RAG,自研确定性 Agentic Search 与结构化知识体——严肃场景里知识必须被结构化成可查证体系 -
观远数据、天弘基金:决策智能的上下文工程与证据链、投研多模态数据治理成可计算的语义资产
数一数:全日程与本体重接相关的演讲 30 场上下、27 家机构——从互联网大厂到工业企业,从金融到内容社区,从创业公司到高校。这不是一个“海外概念的引进专场”,是中国各行各业已经在本体路上走了多远的一次集中亮相。
两天议程,一条线索:海外论证了方向,中国的实践者交出施工图。
写在最后
最后说一句可能刺耳的话。
模型会平权。 你能买到的模型,你的对手也能买到;今年领先的模型能力,明年就是所有平台的默认配置。
本体不会。 你对企业业务世界的建模——每一个对象、每一条规则、每一次“我们终于对齐了这句话是什么意思”的痛苦会议——抄不走,买不到,开源仓库里也没有。
海外已经确认了答案。中国的撞墙者已经在北京站排好了队。
10 月 23-24 日,北京,DACon 2026 北京站——Data-First, AI-Real。 来看中国的企业是怎么做的,然后想想你能借鉴什么。
📅 时间:2026年10月23-24日
📍 地点:北京希尔顿逸林酒店