
阿波罗的SKills: [送Skills]75字符标题新规后,AI一键生成Listing优化 广告全自动数据复盘Skills广告分析 [送PD复盘Skills]Prime Day战况数据复盘:下一轮广告该怎么投? AI算法的Listing关联流量skills 亚马逊AI推荐流量占比突破30%:关联流量布局正在重塑关键词权重(附AI优化Skills) Alexa Listing 就绪度检查助手 Rufus 被 Alexa 取代: Amazon AI Shopping的应用与深度解读 [万字解读] A9算法最新专利: 从搜索到流量操作系统的亚马逊算法之路 曝光份额体检Skills: [附送Skills] 曝光份额报表看非标品:4层读法,多数人第一步就反了 分享不易,内容 + 代码 + Skills生成耗时数小时整理和编写,感谢转发 + 点赞 + 收藏支持小编! |
正文
一个制冰机的 ASIN,我在最新一周的美国站 ABA 数据里反向命中了 360 个搜索词。如果一个个手动判断"这个词跟我这条链接相不相关",半天都干不完——而这还只是三个 ASIN、一个周的量。
这篇文章,我想把我上礼拜搭的一台"自动化词库工具"完整拆给你看:它是怎么从几千万条搜索词里,自动把高相关词挖出来、打上分、分好类的。文章末附送这份 Skills,你照着就能搭一套自己的。
一、选词最贵的不是"找词",是"判相关度"
先对齐一个认知:词不是"想"出来的,是从数据里"挖"出来的。
谁都知道词库重要。但大多数人的做法是"正向捞词":打开搜索词报告,看到自己链接出过哪些词,抄下来,再凭感觉给每个词标一个"相关/不相关"。这里有两个致命问题。
第一个问题:正向捞词有天花板。
你只能看到"你已经投过的词",看不到"你没投过、但竞品正在吃的词"。词库再勤快,也跳不出你现有投放的圈。
第二个问题,也是最贵的:判相关度是纯体力活,还最容易出错。
举个真实场景:你有一个台面制冰机的链接,你的竞品 ASIN 在 ABA 热搜词报告里一周命中了 360 个词——ice maker、countertop ice maker、nugget ice maker、euhomy ice maker、ge opal nugget ice maker……
这里面,countertop ice maker(台面制冰机)跟你的链接高度相关,该投;ge opal nugget ice maker(GE 的 nugget 冰型)是别的品牌、别的冰型,跟你完全无关,该否定。
一个词一个词地判,360 个词判到怀疑人生。更要命的是:人肉判断的标准会漂——你上午判的和下午判的,可能都不是同一个标准。比如 nugget ice maker 这种词,你精神好的时候会想起"我家做的是 bullet 冰,这词不该投",精神一差就随手标了"相关"。同一个词,今天标"相关",下周再看到又标"不相关",词库越攒越乱。
所以真正的问题不是"我没有词",而是"我挖出来的词,没有一个稳定的机制去判相关度、打标签"。
二、为什么别用 LLM 一个个问"这词相关吗"
有人会说:那让 AI 帮我判啊,丢给 GPT 问一句"这个词和这个商品相关吗"。
我一开始也是这么想的。然后我发现这条路又慢、又贵、还会瞎编。这里藏着一个认知翻转:
我一开始真拿 GPT 试过:给它一个词加一段 Listing,让它打分。结果同一个词,第一次问说"高度相关",换个问法又说"一般"。那一刻我就明白了——生成式模型干不了这活,它太想"把话说明白",而打分要的是"闭嘴,只给结论"。
相关度判断,你要的不是"会写作文的 AI",而是"只会做判断题、不会撒谎的 AI"。
现在主流的大模型是"生成式"的:它一个字一个字往外蹦,擅长写长文、聊闲天。但让它给 360 个词各打一个分,它就露怯了:
慢:每个词都要等它完整生成一遍答案,360 个词排队等。
贵:每个词都走一遍完整推理,token 哗哗地烧。
会幻觉:同一个词问两次,可能给你两个不一样的答案。它不是在"判断",是在"临场发挥"。
我最后用的,是一个叫 Jev 的东西。它是 TypeSafe 做的一个"决策模型"(官方叫 System One 模型),跟生成式大模型是两条完全不同的路线:
|
|
生成式 LLM |
Jev(决策模型) |
|---|---|---|
输出 |
逐字生成自由文本 |
只返回「打几分 + 每个分的概率」 |
会不会瞎编 |
会 |
结构上编不了,只能在给定选项里选 |
速度 |
慢 |
一个请求 70–500 毫秒,快 40–200 倍 |
成本 |
贵 |
约 $0.042/百万输入 token,输出免费 |
一句话:让 Jev 判相关度,它只会回答"几分、几成把握",绝不会给你编一个理由。
再往深一层:它给的是"概率",不是"结论"。同样是 9 分,60% 把握和 99% 把握是两个完全不同的信号——前者你自己再瞄一眼,后者可以直接放心用。这个"把握度",正是你批量处理几千个词时,决定"哪些词要人工抽验、哪些可以闭眼用"的依据。LLM 给不了你这个,它只会甩一句笃定的评语给你。
我实测的效果:ice maker → 9.9 分(强相关);ge opal 2.0 nugget ice maker → 2.2 分(竞品,该否定)。它不光认得"是不是制冰机",还认得"是不是你这台制冰机该抢的词"——这个区分度,是人工判 360 个词时最容易走神丢掉的。

三、词库不该手动堆,该"ASIN 反向命中"
第二个认知翻转:词库不是一个个手动往里塞,是从 ABA 数据里"反向命中"出来的。
这里要先懂 ABA(Brand Analytics)的热搜词报告长什么样。它是亚马逊给品牌卖家的一份官方数据,里面美国站每一个搜索词,都带了三列"点击最多的商品 ASIN"(Top Clicked Product #1 / #2 / #3)。也就是说:
每一个搜索词,亚马逊都告诉了你"点这个词的人,最后点进了哪个商品"。
再补一个细节:这三列 ASIN 之外,每个搜索词还带两列更细的数——Click Share(点击份额)和 Conversion Share(转化份额)。也就是说,你不仅能知道"点这个词的人点进了哪个竞品",还能知道"这些竞品里谁吃掉了最大的份额"。这个份额,以后做竞品分析、判断谁才是真正的对手,是现成的线索。
大多数人只看这份报告的"搜索频率排名",用来找大词。但我发现它真正值钱的地方,是那三列 ASIN。
反过来想:我把我的竞品 ASIN 丢进去,找出所有"点进去的是这些竞品"的搜索词——这不就是一份"竞品在吃、而我不一定投过"的词库吗?
这个"反向命中"的逻辑,就是整台工具的地基。它绕开了"正向捞词"的天花板:你看到的不是自己投过的词,而是整个类目里,真实买家在搜、并且搜完点进了竞品的词。
实测:一个中腰部制冰机 ASIN,单周就能反向命中 96 个搜索词;三个 ASIN 合起来,一周 360 个、两周 404 个词。
反向命中出来的词,能直接干什么?至少四件事:
拓词:把你没投过、但竞品在吃的词补进词库。
竞品词库:一次性把 N 个竞品的词池全挖出来,看清他们的主力词是什么。
否定词:分类里"竞品品牌词"这一栏,就是现成的否定词候选。
新品冷启动:新品没有历史数据,靠竞品 ASIN 反向命中,能快速拿到一个可用的初始词池。

四、4 步流水线:从几千万搜索词到一张词表
下面是我搭出来的完整流程,一共四步。每一步我都说清"用了什么、为什么这么选"。整套技术栈其实就三样:DuckDB(存数据、查数据)、Python(抓页面 + 串流程)、Jev(打分)。都不复杂,关键是每一步用对了地方。
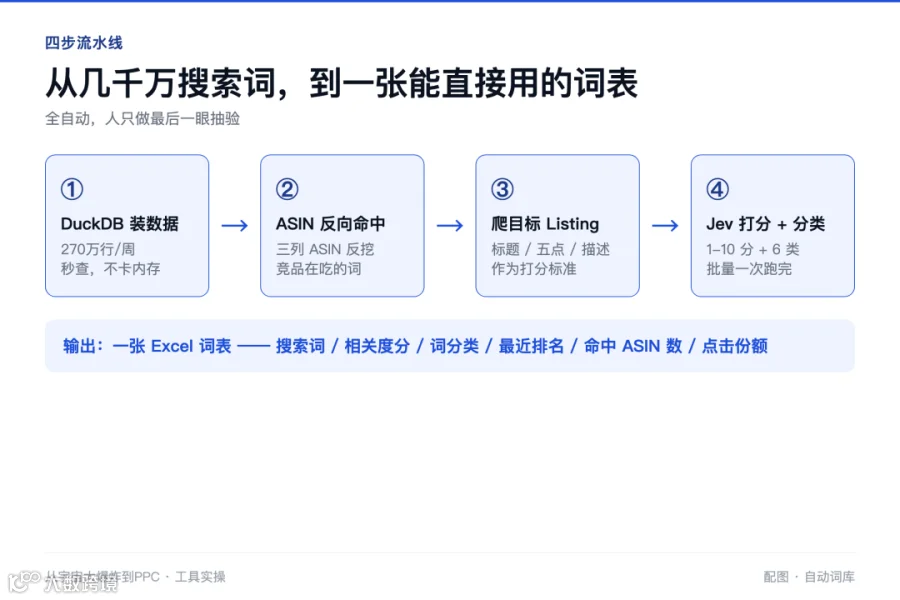
第 1 步:用 DuckDB 把 ABA 数据装进去。
ABA 热搜词报告的量级是劝退级的:一周一个 CSV 文件就 270 万行,一个文件 1.3–2GB,十二周加起来就是 3200 万行。你用 Excel 打开直接死机,用 pandas 读也吃满内存、卡到怀疑人生。
我用的是 DuckDB——一个专门为"大表格秒查"设计的列式数据库。它不用装服务器,一个本地文件就能跑,查 270 万行是秒级的事。这一步看起来只是"把数据搬进去",但选对工具,后面每一步才不会卡。工具选错了,数据一加载就劝退,后面全是空谈。
第 2 步:ASIN 反向命中搜索词。
把你要挖的竞品 ASIN 列表丢给 DuckDB,一条 SQL 就能命中:找出所有"Top Clicked Product #1/#2/#3 三列里出现过这些 ASIN"的搜索词。同时顺手把每个词的几个口径一起算出来。
这里有个口径值得单独记住:"最近一次排名"和"历史最佳排名"是两回事。 实测 countertop ice maker 最近一周排名 5673,但历史最好排到过 5337。排名是波动的,它的涨跌本身就是选词信号——只存一个数,你就丢了"这个词最近是在起量还是在掉"的信息。
第 3 步:爬目标 ASIN 的 Listing。
命中了词,还要知道"这些词跟我的链接相不相关"。所以这一步去爬你目标 ASIN 的详情页,抓回标题、五点描述、正文描述、类目、品牌。这堆文本,就是第 4 步打分的"标准答案"。
为什么一定要爬,而不是凭 ASIN 号猜?因为 Jev 判相关度,靠的是"拿搜索词跟商品的文字描述比"——bullet ice maker(子弹冰)和 nugget ice maker(冰珠)就差一个词,但冰型完全不同,你不给它标题和五点,它没法下判断。
第 4 步:Jev 打分 + 分类,导出词表。
把 Listing 当"参考物"只放一次,360 个词当成 360 个问题,一次性丢给 Jev。每个词它给你两个结果:
相关度分(1–10):
ice maker9.9 分,ge opal2.2 分。词分类(6 类):品类词 / 自有品牌词 / 竞品品牌词 / 属性规格词 / 场景用途词 / 其他长尾。
为什么用 1-10 分而不是简单的是/否?因为词的价值是分层的:9 分和 6 分都是"相关",但投放力度天差地别。1-10 分让你能按分值分层出价、分层建活动,而不是一刀切。
为什么要分类?因为不同类型词,打法完全不一样:品类词是主力投放;自有品牌词要守;竞品品牌词要么否定、要么单独开活动打拦截;属性词、场景词是长尾拓量的主力。分类这一步,直接决定这个词进哪个活动、怎么用。
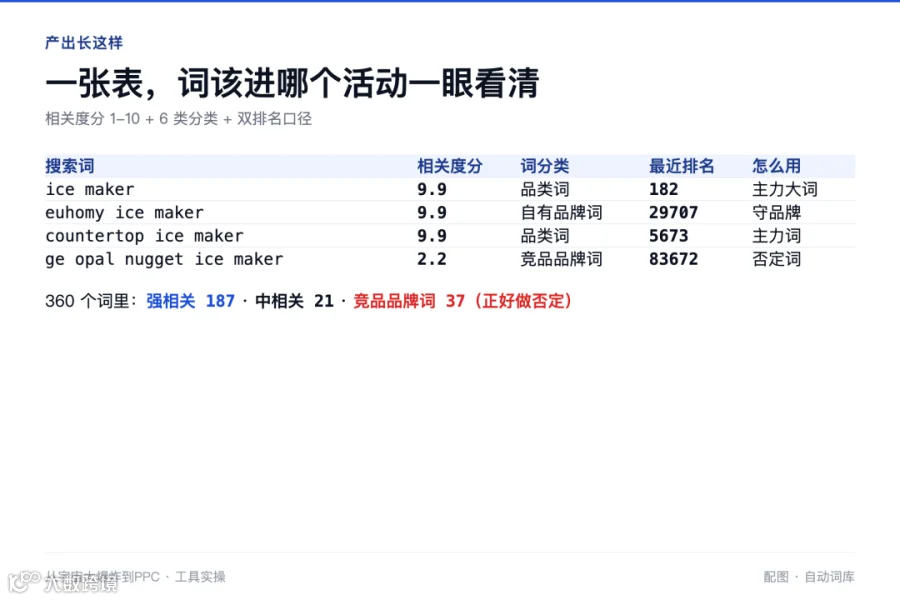
最后导出成一张 Excel:搜索词、相关度分、词分类、最近一次排名、命中 ASIN 数、点击份额。实测 360 个词里,强相关(≥8 分)187 个、中相关 21 个;竞品品牌词 37 个——这些正好拿去做否定词,一举两得。
四步跑下来,从"几千万行原始数据"到"一张能直接用的高相关词表",全自动,人只做最后一眼抽验。这是它跟"人肉选词"的本质区别:人肉是体力,它是流水线。
拿我这次的制冰机为例,输入三个竞品 ASIN,跑出来长这样:
搜索词 |
相关度分 |
词分类 |
最近排名 |
你会怎么用 |
|---|---|---|---|---|
ice maker |
9.9 |
品类词 |
182 |
主力大词 |
euhomy ice maker |
9.9 |
自有品牌词 |
29707 |
守品牌 |
countertop ice maker |
9.9 |
品类词 |
5673 |
主力词 |
ge opal nugget ice maker |
2.2 |
竞品品牌词 |
83672 |
否定词 |
一张表,词该进哪个活动、该不该否定,一眼看清。
再算一笔账:Jev 打 360 个词,成本不到一分钱(按 $0.042/百万输入 token 算),跑完不到一分钟。同样的量交给人工,少说半天。你手里的 ASIN 越多、类目越大,这个差距越夸张——几千个词对它来说也就是多跑几次。
以前我手动选词,一个链接的几百个词,从早筛到晚,还筛得自己心里没底。现在同样的活,一条命令一分钟出表,我只需要把"该抽验的那几个低把握词"点开看一眼。
五、我踩过的 3 个坑(照抄能省你半天)
坑一:ABA 的 CSV 第一行不是表头。
每个文件第一行是一段元数据 Reporting Range=...,真正的表头在第二行。读数据必须跳过第一行,否则整列错位、后面的命中全废。
坑二:爬到的价格可能是别的币种。
爬 Listing 时如果你的网络走海外节点,price 字段可能抓到新加坡元(S$)这种。它跟关键词相关度无关,但别拿它去做定价判断——那个要单独去美国站核。
坑三:Jev 一次别塞太多词。
它的上下文有上限(约 64k token)。我这边一次塞 60 个词是安全值,塞多了直接报错——不是模型笨,是你贪了。老老实实分批,多跑几次反而更稳。
最后说清边界:这套工具做的是"选词"这一步,出的是"词表",不是"直接开投"的结论。Jev 的分再准,也只是相关度的判断,最后还得你结合转化数据、竞价、预算去做投放决策。它替代的是"人肉筛词的体力活",不是"你作为操盘手的判断力"。
六、总结 + 附送这份 Skills
一句话记住今天这篇:词库不是手动堆出来的,是"ABA 数据反向命中 ASIN + 决策模型 Jev 打分"自动挖出来的。
上手你只要准备三样:① 后台下载的 ABA 热搜词报告(几周的 CSV)② 你的竞品 ASIN 清单 + 一个目标 ASIN ③ 一个 TypeSafe 的 Jev key(申请几分钟)。环境装好之后,一条命令就出表。
附送:ABA 自动词库 Skills
它解决什么:给你 ABA 数据 + 一组 ASIN,一键产出「高相关关键词词表」。
内置口径:① 1–10 相关度打分(期望值,非拍脑袋)② 6 类词分类(品类/自有品牌/竞品品牌/属性规格/场景用途/长尾)③ 最近一次 + 历史最佳双排名 ④ 命中 ASIN 数。四步流水线一个脚本串起来,输入 ABA 目录 + ASIN 列表 + 目标 ASIN,直接出 Excel。
领取方式:转发本文到朋友圈,免费领取这份 Skills 的脚本 + 完整使用说明。

数据声明:文中制冰机案例来自美国站真实 ABA 热搜词报告与公开 Amazon Listing;搜索词与 ASIN 均为公开数据。相关度分数由 TypeSafe Jev 决策模型输出,供参考,不代表 Amazon 官方口径。
如果你也发现,真正耗时间的不是“有没有数据”,而是怎么把几千、几万条数据变成能直接执行的判断,那这套思路就不只适合做词库。
欢迎来 Apollo 特训营,在这里我们会继续把这种方法落到账户实战:从找词、筛词、广告结构,到预算怎么分、流量怎么接,用真实案例一步步拆。
工具帮你省时间,方法帮你少走弯路。
首个AI全链路跑通案例:新品14天从0到日销100单
2026-04-27
运营花几天搭建的关键词库, Codex不到1小时完成:亚马逊运营效率正在被重新定义
2026-08-04
提升自然订单,不是多开广告:4步搭建正确广告架构
2026-08-21

亚马逊新规:变体评论不再全部共享,哪些产品会受影响?
2026-08-22
新品一上架就开大预算广告,真的能快速推起来吗?
2026-08-13
亚马逊Listing进入CDQ时代?关于评分、属性和排名,官方到底怎么说
2026-08-12

[案例分享]断货30天 我如何几天做回到日出200单
2026-07-22