


继 Claude Opus 5.5 和 Claude Sonnet 5.5 之后,Anthropic 正式发布了 Claude Haiku 5.5。官方将其定义为「迄今为止最便宜、最快且能力最强的小模型」。
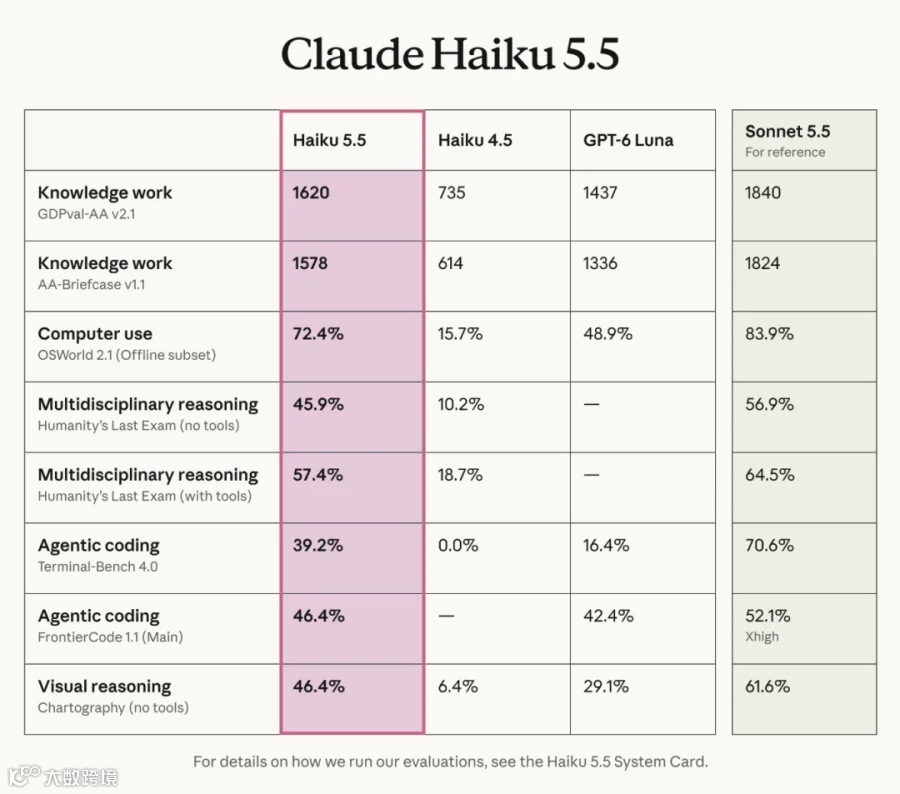
性能与价格:全面对标 GPT-6 Luna
从测试数据来看,Claude Haiku 5.5 直接对标 OpenAI 的 GPT-6 Luna。在六项关键指标中,Haiku 5.5 均处于领先地位:
- 电脑操作 (OSWorld):72.4% vs 48.9%
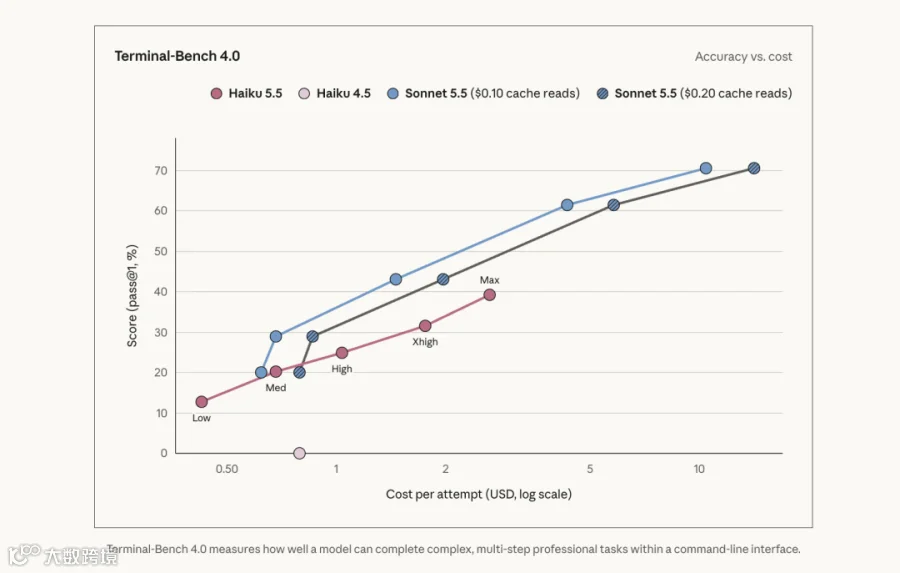
- 命令行编程 (Terminal-Bench 4.0):39.2% vs 16.4%
在价格方面,Claude Haiku 5.5 将 API 定价降至每百万输入 token 0.10 美元、输出 0.50 美元,与 GPT-6 Luna 保持一致。相比上一代 Claude Haiku 4.5(输入 1 美元/输出 5 美元),成本降低了整整 10 倍。换算成人民币,每百万输入 token 成本不足 0.7 元,缓存读取仅需 0.01 美元。

需注意,当上下文长度超过 10 万 token 时,Haiku 的单价会上涨 5 倍。因此,对于超长文本任务,限制在 27.2 万 token 以内不涨价的 GPT-6 Luna 可能更具性价比。 Anthropic 官方数据显示,综合平均运行成本比 Haiku 4.5 低 75%。
可调节推理强度:性价比的新变量
Claude Haiku 5.5 是首个支持调节推理强度的 Haiku 模型,提供 Low、Med、High、Xhigh 至 Max 五个档位。档位越高,模型表现越强,但 Token 消耗也相应增加。

在电脑操作任务中,即使仅开启中档(Med),Claude Haiku 5.5 得分也高于 GPT-6 Luna 的最佳表现,且成本更低(0.13 美元 vs 更高成本)。
但在知识工作领域,情况略有不同。同等花费(0.09 美元)下,Luna 得分(1437 分)略高于 Haiku 5.5(约 1420 分)。Haiku 5.5 若要达到 1620 的高分,需开启 Max 模式,单次任务成本升至 0.87 美元,约为 Luna 的 10 倍。
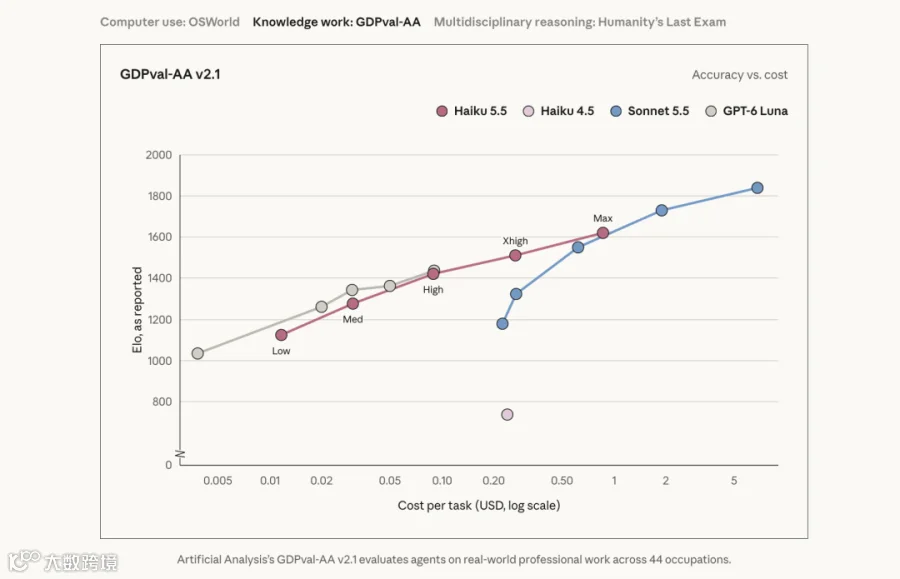
第三方机构 Artificial Analysis 的测评指出,开启 Max 推理强度的 Haiku 5.5 可能会极度消耗 Token,类似「深度思考」模式,而 High 及以下档位则相对均衡。
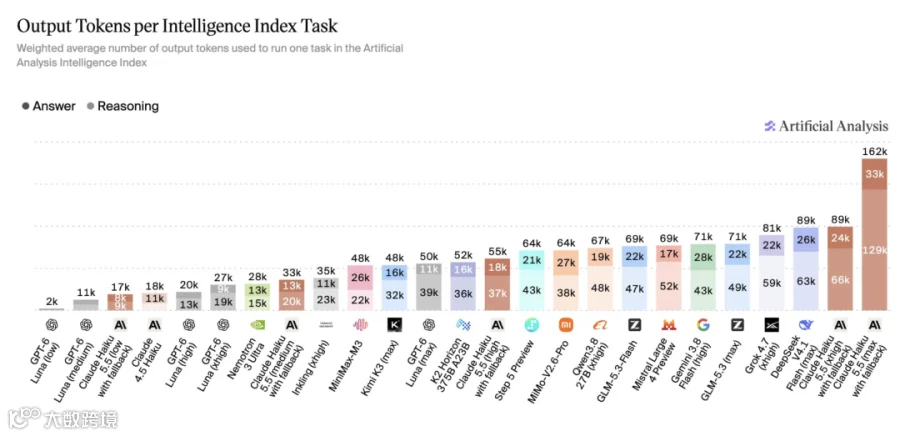
在综合排行榜中,Claude Haiku 5.5 得分 43 分,远超上一代的 17 分,进步显著。

产品定位与应用场景
对于复杂的 Agent 编程任务,Claude Sonnet 5.5 和 Claude Opus 5.5 仍是更优选择。成本曲线显示,同等花费下 Sonnet 的得分高于 Haiku。
Claude Haiku 5.5 的核心定位是高效处理量大且琐碎的任务,如生成摘要、压缩上下文、数据分类及数据库查询等。其速度快、成本低的特点,使其非常适合作为子智能体辅助 Opus 或 Sonnet 进行代码编写或其他复杂任务。
目前,Claude Haiku 5.5 已登陆 Claude 网页版、桌面端、手机 App 及 Claude Code,免费用户即可使用。
Claude Sonnet 降价与订阅福利
此外,Anthropic 宣布 Claude Sonnet 5.5 缓存读取价格减半,从每百万 token 0.20 美元降至 0.10 美元,与 GPT-6.1 Sol 持平。官方表示,此举将使大多数智能体任务的成本降低约 20%。
针对订阅用户,Anthropic 推出了新的 API 额度福利:
- Claude Max 5x:每月 100 美元额度
- Claude Max 20x:每月 200 美元额度
- Team 团队版:每月最多 500 美元额度(团队共用)
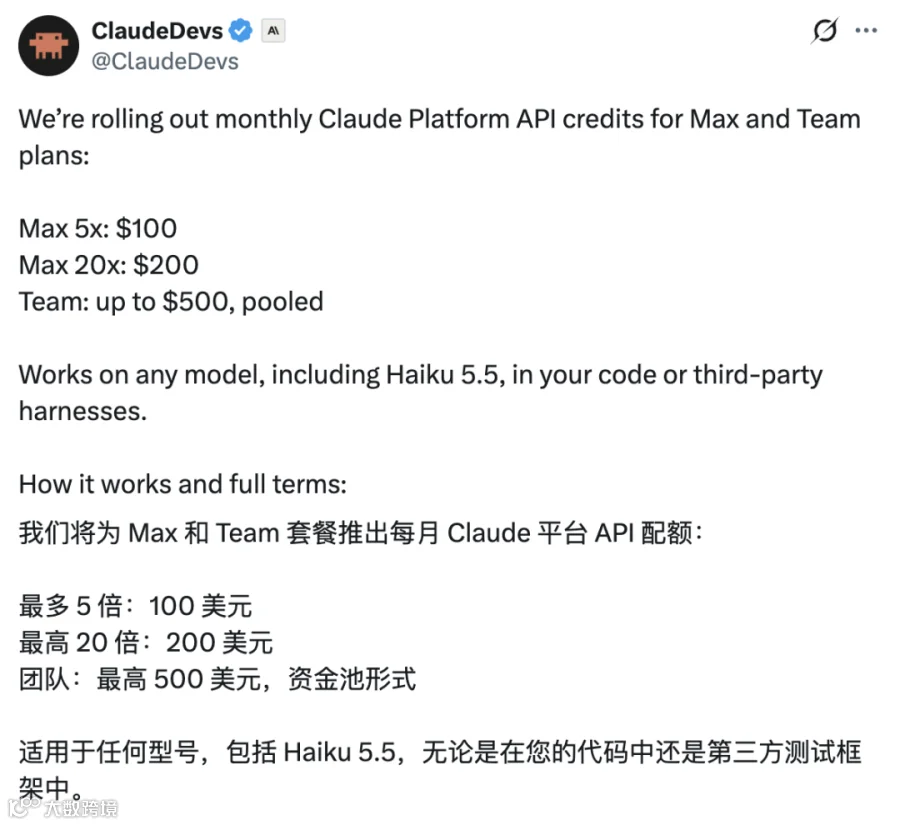
该额度适用于所有模型(包括 Claude Haiku 5.5),可用于自行调用或接入第三方工具,但不适用于 Claude Code 内部。额度当月有效,过期清零。
随着 Opus、Sonnet、Haiku 三款模型的 5.5 版本全部发布,Claude 5.5 家族阵容已完整。接下来,市场目光将转向备受期待的 Claude Fable 5.5。