核心总结
如果说过去十年是“移动互联网”的十年,那么未来十年,一定是“大模型与Transformer”的十年。
读完这本《基于GPT-3、ChatGPT、GPT-4等Transformer架构的自然语言处理》,我最大的感受是:AI不是来抢饭碗的,它是来重新定义饭碗的。
一、为什么这本书值得一读?
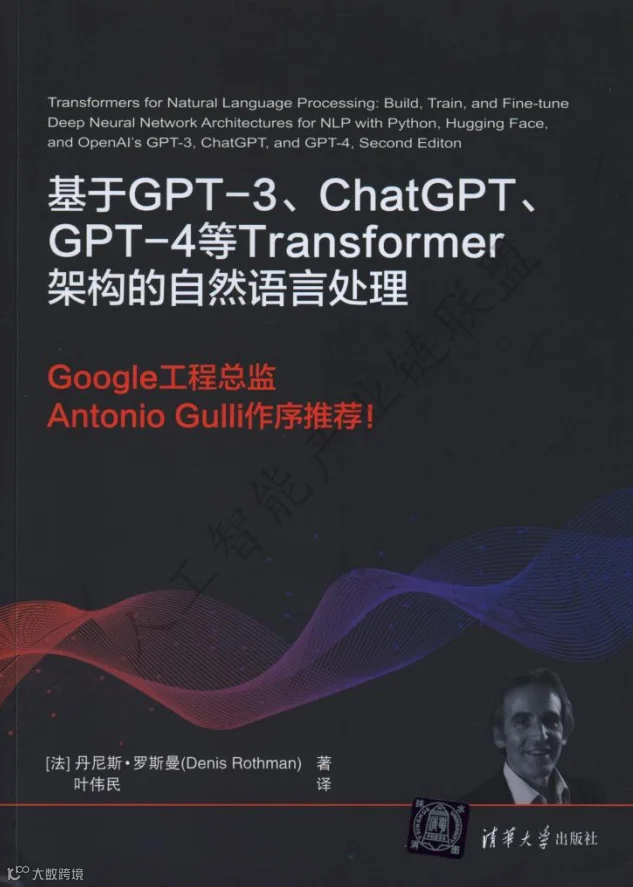
本书由法国AI专家丹尼斯·罗斯曼(Denis Rothman)撰写,清华大学出版社2024年出版,获Google工程总监Antonio Gulli作序推荐。这并非一本仅停留在概念层面的理论书,而是一部涵盖从底层架构到代码实战、从NLP到计算机视觉、从GPT-3至GPT-4的综合性指南。
全书贯穿一个核心理念:
Transformer正在颠覆AI领域。谁理解Transformer,谁就握住了AI时代的底层钥匙。
内容不仅覆盖原始Transformer、BERT、RoBERTa、GPT、T5等基础模型,还深入探讨机器翻译、文本摘要、语义角色标注、问答系统、情绪分析、假新闻检测、可解释AI、视觉Transformer及AI助理等应用场景。简而言之,这是一部“Transformer宇宙漫游指南”。
二、全书地图:17章核心内容解析
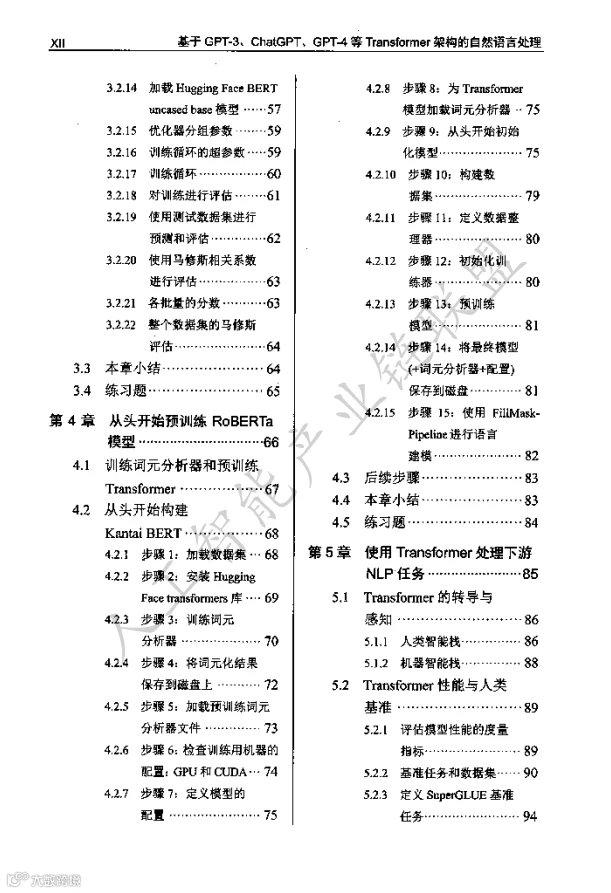
第1章:Transformer模型介绍
从工业4.0、基础模型及提示工程切入,阐述AI进入“大模型时代”的逻辑。核心观点指出,基础模型具备同质化与涌现能力,单一模型即可执行多种任务,无需针对每个任务单独训练。
第2章:Transformer模型架构入门
深入解读“Attention Is All You Need”论文,详解编码器、解码器、多头注意力、位置编码、残差连接、层归一化及前馈网络。通俗理解如下:
-
• 注意力机制:让每个词关注句中其他所有词,判断关联度。 -
• 多头注意力:多个“头”同时从不同维度分析句子。 -
• 位置编码:明确词汇在序列中的位置信息。 -
• 残差连接:防止深层网络中的信息丢失。 -
• 层归一化:提升训练稳定性。
第3章:微调BERT模型
BERT作为“双向编码器”,类似做“完形填空”。它仅使用Transformer编码器,通过掩码语言建模(MLM)和下一句预测(NSP)进行训练,微调后可用于句子分类、可接受性判断等任务。
第4章:从头开始预训练RoBERTa模型
作者以Immanuel Kant文本为例训练“KantaiBERT”,涵盖词元分析器训练、字节级BPE、数据集构建、数据整理器定义、模型训练与保存等全流程。本章旨在证明Transformer并非魔法,而是可逐步构建的工程系统。
第5章:使用Transformer处理下游NLP任务
介绍GLUE、SuperGLUE等基准任务。尽管Transformer在诸多NLU任务上已超越人类基准,但需注意基准测试并不完全等同于真实世界表现。
第6章:机器翻译
涉及WMT数据集、BLEU评估及Google翻译等。关键点在于机器翻译是转导过程而非逐字翻译,高BLEU分数并不必然代表翻译自然。
第7章:GPT-3
GPT采用纯解码器架构,从左至右生成文本。参数规模从GPT-2的1.17亿激增至GPT-3的1750亿,展现出强大的零样本、单样本及少样本学习能力。本章还涵盖OpenAI API使用、微调及提示设计。
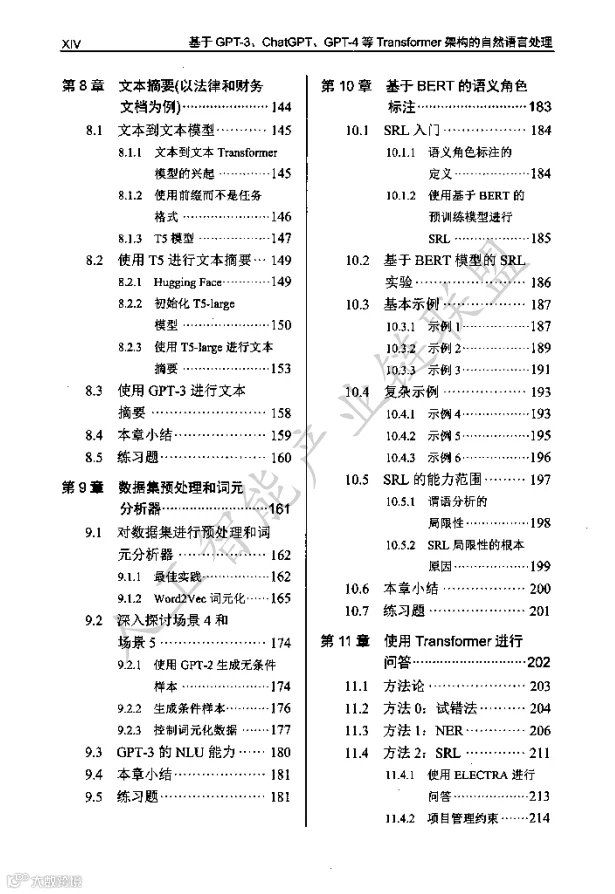
第8章:文本摘要
T5模型将NLP任务统一为“文本到文本”模式。通过添加前缀(如“summarize:”)即可执行摘要任务。书中指出,面对复杂文本时,模型仍可能存在局限性。
第9章:数据集预处理和词元分析器
详述词元化、BPE、Word2Vec等技术。核心观点认为词元化是NLP的隐形战场,错误的词元化会导致模型学习偏差,例如将“amoeboid”错误拆分可能引发语义关联错误。
第10章:基于BERT的语义角色标注
利用BERT识别谓语、论元及修饰语,回答“谁做了什么”等问题。但需注意其在无动词句子、省略句等场景下的局限性。
第11章:使用Transformer进行问答
高质量的问答系统需结合问题生成、实体识别、语义角色标注及质量控制,而非简单的上下文匹配。
第12章:情绪分析
针对复杂句式(如转折句),模型可能误判。结论指出情绪分析需遵循组合性原则,不能简单统计正面或负面词汇。
第13章:使用Transformer分析假新闻
结合认知失调理论与理性路线图,利用多维技术辅助判断。核心观点强调不存在绝对客观的“假新闻检测器”,Transformer可辅助思考但不能替代人类判断。
第14章:可解释AI
通过BertViz、LIME等工具打开黑盒,提升AI可信度。
第15章:从NLP到计算机视觉
核心思想是“图像即单词序列”。ViT将图像切块处理,CLIP进行图文对比学习,DALL-E实现文生图。
第16章:AI助理
涵盖提示工程、GitHub Copilot、嵌入技术及推荐系统等。未来AI专家的角色将从“写代码”转向“设计流水线、管理AI及质量控制”。
第17章:ChatGPT和GPT-4
讲解ChatGPT API、GPT-4、Whisper及高级提示工程。展示了对话式AI的新编程语言结构,包含system、user、assistant三种角色。
   response = openai.ChatCompletion.create(
  model="gpt-3.5-turbo",
  messages=[
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "What web services do you offer?"}
  ]
)
三、专业解读:值得铭记的五大洞察
1. Transformer是“任务无关”的通用序列学习器
只要转化为序列数据,Transformer即可处理文本、图像、语音等,其应用已从NLP扩展至计算机视觉、机器人等领域。
2. 预训练+微调正被“提示工程+零样本”补充
GPT-3证明仅靠提示即可完成多种任务。提示工程并非玄学,需结合对模型、数据及业务的理解。清晰度的提升直接关联回答的可靠性。
3. 数据质量决定模型上限
词元化错误、噪声数据及多义性等问题若不解决,再大的模型也会出错。AI遵循“垃圾进,垃圾出”原则。
4. 大模型不是万能药
大模型仍存在幻觉、偏见及逻辑局限,且涉及成本与伦理问题。人类仍需作为AI的副驾驶甚至主驾驶进行把关。
5. 工业4.0 AI专家需要跨学科能力
未来AI专家需具备语言学、业务领域、项目管理、伦理法规及成本控制等多维能力,从“代码编写者”转型为“AI流水线设计师”。
四、适用人群
-
• AI从业者:完善Transformer知识体系。 -
• 数据科学家:深入理解NLP、CV及大模型落地。 -
• 产品经理:明晰AI能力边界。 -
• 企业管理者:规划AI项目,管控成本与风险。 -
• 学生与转行者:建立从BERT到ChatGPT的认知地图。 -
• AI爱好者:通过案例理解大模型原理。
五、金句总结
注意力就是一切。
预训练是基础,微调是技能,提示是沟通。
模型越大,越需要人类判断。
词元化是隐形战场,数据质量决定AI上限。
AI不是取代人,而是放大人的能力。
未来属于会设计AI流水线的人。
六、结语:AI时代,别只做旁观者
本书从Transformer架构延伸至ChatGPT、GPT-4,横跨NLP与计算机视觉,兼顾代码实战与伦理思考。它揭示了一个事实:
大模型不是终点,而是新起点。
真正稀缺的,不是模型,而是会用模型解决真实问题的人。
建议将此书置于案头,常读常新。收藏本文,相当于拥有了一张Transformer世界的导航图。AI时代,我们一起进化。