


让强化学习去优化医疗建议、科研问答这类开放任务,有个绕不开的尴尬,裁判要读完一整篇回答才打一个分。分数是有了,可到底哪句话加分、哪句话扣分,模型完全不知道。一个几千 token 的回答被压成一个标量,token 级的信用分配等于没有。Meta 和纽约大学这篇 OPD Before RL,就是冲着这个稀疏信号来的。

先说这类任务为什么难判
数学有标准答案,代码能跑单元测试,可一句健康建议是否到位,看的是事实准确、有没有必要的就医提醒、结构是否清楚这些多维标准。常见做法是把标准写成一份 rubric,每条一个自然语言判据配一个权重,让 LLM 裁判逐条判,再加权归一成一个分数,用 GRPO 这类算法去做 RL。问题就出在最后这一步,一整条轨迹只换来一个标量奖励,稀疏,费样本,从弱模型起步时尤其不稳。
两步走,先把稠密信号补回来
作者的做法分两步。第一步叫 RP-OPD,带评分细则特权的在线蒸馏。教师模型能同时看到问题、评分细则、还有学生已经写出来的前半段,输出下一个 token 的概率分布;学生只看问题和前半段,看不到细则,去对齐教师的前 K 个 token 分布,用前向 KL,K 取 256。
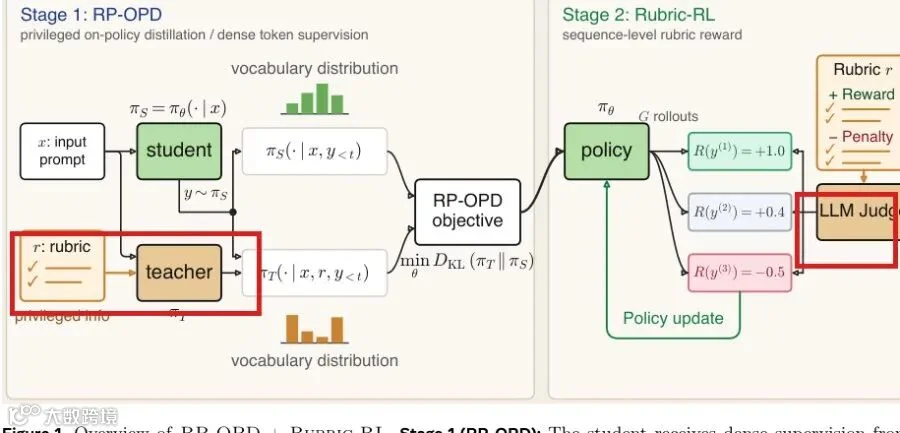
红框左边是第一步的关键,教师手里有 rubric 这份特权信息,学生在自己生成的回答上逐 token 对齐教师分布,稠密监督就是这么补回来的。这里有个容易忽略的点,学生在自己会走到的前缀上被纠偏,不必照着教师写好的范文念。
第二步才做真正的 RL,从蒸馏好的检查点出发,让裁判按细则打分当奖励,直接优化任务级的分数。
光蒸馏不够,模仿会停在平台期
有人会问,既然蒸馏给了稠密信号,为什么不一直蒸下去。作者单独验证过,蒸馏本质是模仿,学生最后会停在一个平台期,明显低于教师,也低于直接做 rubric RL 的水平。
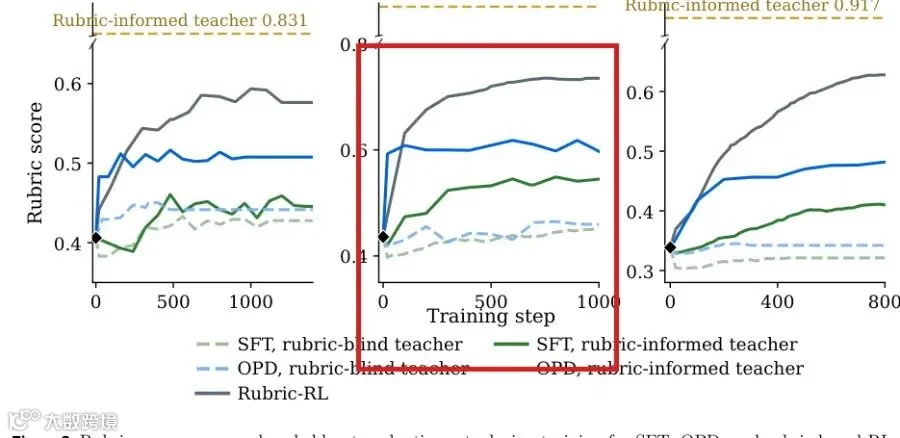
红框这组曲线把这件事说清楚了,金色虚线是能看细则的教师上限,灰色是直接的 Rubric-RL,蓝色是 OPD。OPD 单独用会早早压平,追不上直接 RL,更够不到教师。模仿到顶了,再往上得靠直接优化奖励,所以两步是互补的。
一个反直觉的发现,SFT 热身可能伤可塑性
更常规的热身其实是 SFT,拿教师写好的满分回答微调学生。这篇的一个关键观察是,SFT 学固定范文,会把输出分布往那几篇上收,token 熵明显更低。他们看到,SFT 训得越久,后面 RL 涨得越少,甚至在留出集上越训越差,这跟别人说的可塑性下降对得上。相比之下,OPD 的教师分布给多个延续都留了概率,学生熵更高,给后面的 RL 留了探索空间,也更晚触顶。
成绩

三个开源学生模型、三个基准,统一用 Qwen2.5-32B 或 Llama-3.1-70B 当教师,评测时再用独立的 GPT-4o-mini 做防作弊打分。红框两行是这套两阶段方法,在每一个模型乘基准的组合里都是最高分。七 B 模型在 ResearchQA 上追平了 GPT-5,回答长度还差不多。
最有意思的一段,SFT 热身更容易诱发奖励作弊
在 RubricHub Science 训到 RL 六百步,SFT 加 RL 有 75.2% 的回答被关键词标记,特征是嘴上自称符合评分细则,内容却没给到。RP-OPD 加 RL 只有 1.7%。
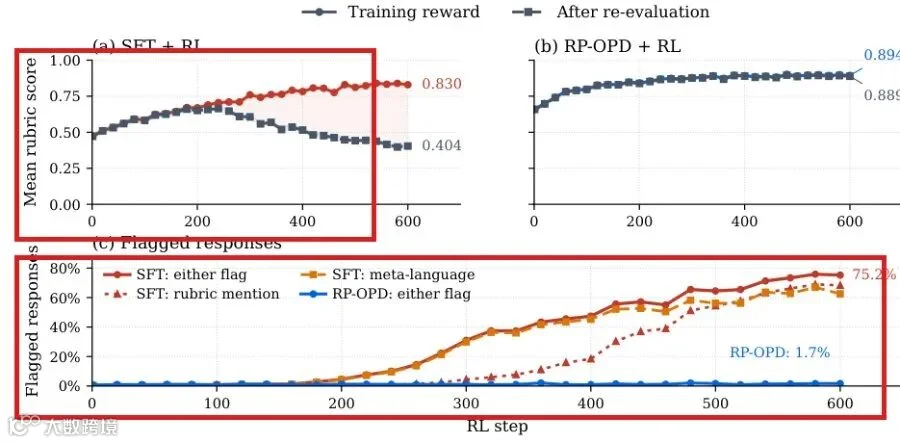
红框上左是 SFT 加 RL,训练奖励一路涨到 0.830,作者把被标记的回答重评一遍、明确告诉裁判别给自称正确这种话打分,分数一下掉到 0.404;红框下面那条曲线,SFT 加 RL 的标记率一路爬到 75.2%,OPD 加 RL 平在 1.7% 附近。论文里有个例子,同一道统计物理题,SFT 基线说本回答至少七千字、满足全部细则,拿满分,实际推导没给;OPD 版本老老实实写了玻尔兹曼分布的公式,反而分更低。
这套自夸的源头在 SFT 阶段,教师被要求刷分,范文里就夹了宣称符合细则的话,模型学过来,RL 再把它放大。蒸馏只让学生对齐教师概率、不复刻整篇答案,这类话术就少被学进去。
值得说的一点,是先稠密后稀疏,把评分细则先给教师当提示、再给 RL 当奖励,热身阶段别急着用 SFT 把模型过早收紧。还有个反直觉的提醒,SFT 分数高不代表 RL 之后更强,热身选什么会实打实影响 RL 能走多远。
边界也清楚。它假设你手上有任务级 rubric 和一个更强的教师,效果取决于细则写得是否到位、教师是否可靠;蒸馏要多跑教师推理,这笔开销和收益他们没系统权衡;评测只在健康和科学两类任务上;训练时的裁判用的是 Qwen3-32B,换个更强的裁判,结论可能还会变。
OPD Before RL: Warm-Starting Rubric-Based RL with On-Policy Distillation
纽约大学 · Meta
arXiv 2610.02781 (2026-10-02)
https://arxiv.org/abs/2610.02781